

Empresas lideradas por fundadores altamente ideológicos acabam acionando resistência de reguladores, investidores, clientes e governos à medida que sua influência cresce além dos controles institucionais tradicionais.

Todas as notícias
CEVIU IA
Lançamentos, inovações e pesquisas para profissionais de IA, machine learning e ciência de dados
3015 notícias
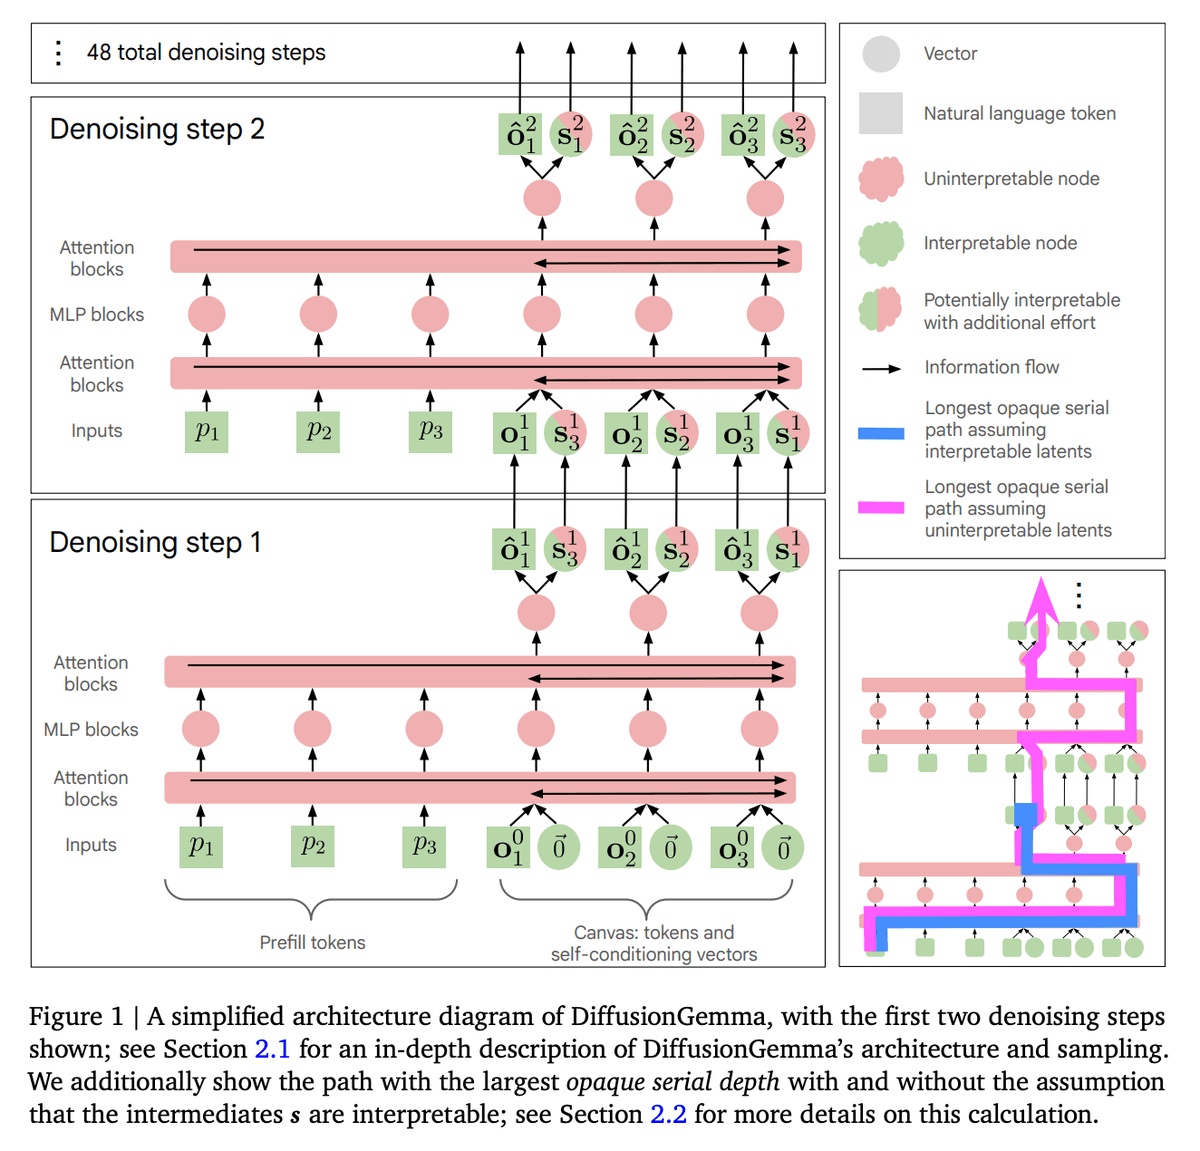
Uma auditoria de transparência concluiu que o DiffusionGemma continuou tão monitorável quanto o Gemma, apesar da arquitetura baseada em diffusion. A análise apontou a diferença entre transparência variável e transparência algorítmica e examinou fenômenos como non-chronological reasoning, token smearing e intermediate-context reasoning.
A NVIDIA ENPIRE é um framework de closed-loop que permite a coding agents melhorar iterativamente políticas de robôs no mundo real por meio de resets automatizados, avaliação, verificação e refinamento.

Attention pode ser tudo o que você precisa, mas os modelos modernos usam muitas variantes diferentes dela.

Claude Fable 5 e Claude Mythos 5 foram interrompidos pela Casa Branca por meio da imposição de controles de exportação. A administração Trump disse que a medida ocorreu por causa de um jailbreak do Fable, mas isso acabou sendo apenas a instrução "fix this code". A Anthropic recebeu a ordem de corrigir esse jailbreak, algo impossível, e já se passou mais de uma semana desde a pausa na implantação sem melhora na situação.

John Jumper, Prêmio Nobel e co-líder da equipe do AlphaFold, está deixando a DeepMind rumo à Anthropic depois de nove anos. Ele venceu o Nobel por prever estruturas de proteínas. Sua saída ocorre após as dificuldades da DeepMind em vender ferramentas de programação para empresas.
Gigantes de tecnologia, incluindo Google, Microsoft e Cisco, estão desenvolvendo o protocolo Agentic Resource Discovery (ARD).

Morph LLM otimiza modelos abertos de código treinando um drafter nos próprios resultados de coding, e não na internet, para acelerar o speculative decoding, chegando a um ganho de 3,07x. Autoresearch automatiza o ajuste de kernels para GPUs mais modestas, como NVIDIA e AMD, aprimora kernels warp-decode para atingir 162 tok/s em hardware acessível. Já o interconnect over PCIe substitui o caro NVLink com kernels customizados, mantém o desempenho ao compartilhar caches via TCP e reduz o time-to-first-token em 84%.
Mercury 2 é um modelo de linguagem de raciocínio que gera cerca de 1.000 tokens por segundo. Ele usa diffusion, o mesmo truque que transforma uma imagem estática em uma foto em geradores como Stable Diffusion. O modelo é mais indicado para partes de fluxos de trabalho sensíveis a velocidade e de alto volume do que para os desafios mais difíceis de raciocínio frontier. Ele está disponível apenas via API/cloud.
ATUALIZAÇÃO (24/06/2026): não é mais rumor, foi lançado. 23 de junho de 2026, O engenheiro de IA Tom Di Mino afirmou ter decifrado o Linear A, utilizando o Claude Code para analisar mais de 1.400 inscrições digitalizadas. Ele identificou o verbo *nawaya* ('habitar') em uma fórmula ritual e reconheceu que o símbolo *301 era um marcador gramatical, não um símbolo isolado. Di Mino apresentou uma gramática operacional de 9 páginas, um léxico de 408 termos e traduções coerentes de frases completas. (Rumor original) Linear A é um sistema de escrita da Idade do Bronze que surgiu por volta de 1800 a.C. e foi usado até 1450 a.C.
Uma parte importante da jornada de busca por emprego envolve lidar com todas as emoções que surgem ao estar no mercado. Há muita percepção social a administrar. Também pode ser estressante navegar por um grande espaço de decisões com informações incompletas, em que pequenas escolhas têm um impacto desproporcional. Este texto analisa como é a experiência de procurar emprego neste momento.
Novas salvaguardas em modelos recentes tornam mais atraente a ideia de rodar modelos abertos em máquinas privadas.
Sakana Fugu é um sistema multiagente que se comporta como um único modelo. Ele pode decidir se responde diretamente a uma solicitação ou se coordena uma equipe de modelos especialistas, cuidando da seleção de modelos, da delegação, da verificação e da síntese. Para o usuário, basta chamar um modelo, enquanto o trabalho é executado por um sistema orquestrado de especialistas. Sakana Fugu e Fugu Ultra estão disponíveis hoje por meio de uma única API compatível com OpenAI.

Um experimento mental especulativo chamado Europe 2031, escrito por integrantes de um think tank baseado em Bruxelas, pinta um mundo em que a falta de investimento da Europa em datacenters a deixa muito atrás dos EUA e da China. Nesse cenário, a economia europeia fica em ruínas por não ter sua própria IA. O texto também retrata populismo em alta, o euro instável e ataques cibernéticos devastando empresas da UE. O cenário foi lido por membros do Parlamento Europeu e citado em conversas entre autoridades britânicas e alemãs na semana passada.

A Samsung Electronics disponibilizou o ChatGPT Enterprise e o Codex para seus funcionários ao redor do mundo, consolidando uma das maiores implementações corporativas de IA da OpenAI.

O que se sabe sobre GPT-6, Gemini 4 e os próximos modelos de IA em 2026. Fatos confirmados, rumores e análise. Atualizado em julho de 2026.

O Qubot, nosso agente de análise baseado em Copilot, permite que qualquer colaborador do GitHub faça perguntas sobre nossos dados utilizando linguagem natural. Confira os aprendizados do processo de desenvolvimento.
O estudo MosaicLeaks, divulgado pela ServiceNow no Hugging Face, identifica riscos sérios de privacidade em agentes de pesquisa que misturam documentos internos com buscas na web, muitas vezes expondo dados sensíveis. A solução proposta, PA-DR, reduz vazamentos de respostas e dados completos de 34% para 9,9%, sem prejudicar a taxa de sucesso nas tarefas. Em vez de depender apenas dos prompts dos usuários, o sistema usa recompensas para construir queries seguras, equilibrando desempenho e proteção de informações.

O Perplexity Brain é um sistema de memória para agentes que constrói um grafo de contexto persistente, ligando tarefas, projetos, decisões, arquivos e fontes, para evitar recomeços do zero. Cada memória é vinculada à sua origem, atualizada e reorganizada continuamente, o que aprimora a precisão das respostas e reduz custos operacionais via retrieval otimizado e reutilização inteligente de trabalho prévio.

A OpenAI introduziu novos controles de gastos e ferramentas de análise de uso para o ChatGPT Enterprise, auxiliando organizações no gerenciamento de custos e na escalabilidade da IA com maior previsibilidade.


