
Fine-tuning em GPUs: Por que o tempo real excede estimativas de FLOPs?
Aprofundamento CEVIU
Aprofundamento
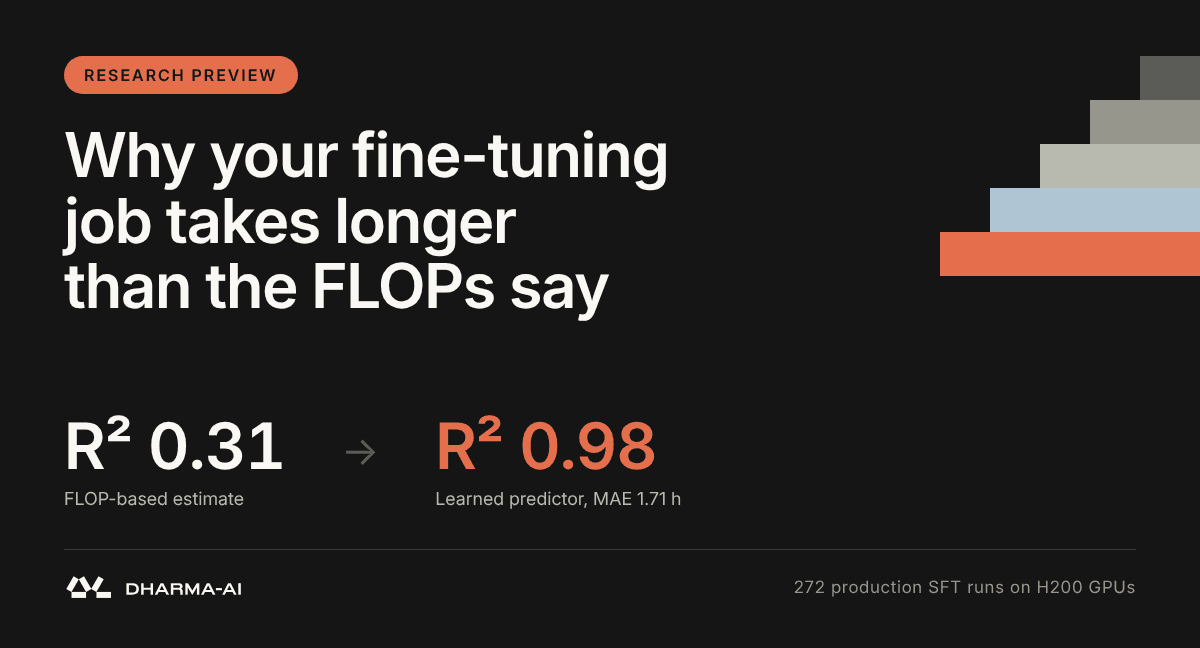
A Dharma-AI, em um estudo pré-publicação no arXiv, revelou uma discrepância significativa na estimativa do tempo de fine-tuning em clusters de GPU compartilhados. A pesquisa, que analisou 272 execuções de produção totalizando 7.382 GPU-horas, demonstrou que o método tradicional de cálculo baseado em FLOPs explica apenas 31% da variação no tempo de execução, com um erro médio absoluto de 12,41 horas. Este método falha ao não considerar aspectos como configuração do ambiente, carregamento do modelo, tokenização, avaliações periódicas e uploads de checkpoint, além da contenção real de recursos em ambientes multi-tenant.
Em contraste, um regressor CatBoost, que incorpora dados pré-despacho como cadência de avaliação, política de checkpoint e carga por GPU, alcançou uma precisão substancialmente maior, com R² de 0.98 e erro médio absoluto de 1,71 horas. Este modelo preditivo é alimentado por 24 features que expõem os overheads do processo, incluindo o número de amostras avaliadas (num_eval_data) e o volume de I/O de checkpoints (num_params_saved). A importância dessas variáveis ressalta que o tempo de execução real é moldado não apenas pelo cálculo bruto, mas também pelas decisões de configuração do treinamento e pela dinâmica do cluster.
Por que isso importa
Para engenheiros de MLOps e gerentes de infraestrutura, a capacidade de prever com precisão o tempo de fine-tuning de modelos generativos, especialmente em clusters de GPU, é fundamental. Um agendamento ineficiente leva a GPUs ociosas ou a atrasos em experimentos e entregas. O estudo da Dharma-AI valida que modelos preditivos baseados em dados pré-despacho são mais eficazes do que estimativas simplistas de FLOPs, permitindo um planejamento mais assertivo sobre quais tarefas executar, quando e em quantas GPUs. Isso se traduz em otimização do uso de recursos e na redução de custos operacionais, especialmente em um cenário onde GPUs como a NVIDIA H200 são escassas e caras.
Linha do tempo
O CEVIU noticiou que 'Latência é Crucial: Goodput Supera Throughput no Serviço de LLMs', destacando a importância da experiência do usuário em LLMs.
O CEVIU cobriu 'Desvendando a Performance de LLMs Locais: O Impacto de Hardware e Configurações', que abordou como fatores de hardware e software afetam o desempenho de LLMs locais.
O CEVIU publicou sobre 'Otimização de Dados Impulsiona Progresso no Pré-Treino de Modelos de IA', mostrando que a otimização de dados é chave para o avanço em modelos de IA.
O CEVIU analisou 'A 'Lacuna de Inference': O Custo Oculto da Otimização de LLMs em Produção', abordando a discrepância entre benchmarks e desempenho real em produção.
O CEVIU noticiou 'Desafios do Treinamento de Modelos de Linguagem com Precisão de 4 Bits são Analisados pela Thinking Machines', sobre os desafios da quantização em treinamento de LLMs.
O CEVIU cobriu 'Execução de Modelos MoE de 180B de Parâmetros em Hardware Limitado é Detalhada', explorando a execução de MoE em hardware modesto.
A Dharma-AI publicou um estudo sobre a disparidade entre estimativas de FLOPs e tempo real de fine-tuning em GPUs.
Perguntas frequentes
Por que as estimativas de tempo de fine-tuning baseadas em FLOPs são imprecisas?
As estimativas baseadas em FLOPs consideram apenas o cálculo bruto do modelo, ignorando o tempo de setup do ambiente, carregamento de modelo, tokenização, avaliações periódicas, uploads de checkpoint e a contenção de recursos em clusters multi-tenant. Esses fatores adicionam overheads significativos que não escalam linearmente com a carga de trabalho.
Como o modelo CatBoost da Dharma-AI melhora a precisão da previsão?
O modelo CatBoost incorpora 24 features pré-despacho, como cadência de avaliação, política de checkpoint, carga por GPU e volume de dados de avaliação. Ele aprende as interações não lineares entre esses fatores a partir de execuções passadas, resultando em uma previsão mais precisa do tempo de execução total.
Quais são as principais limitações do estudo da Dharma-AI?
O estudo focou apenas em fine-tuning supervisionado (SFT), não incluindo outras estratégias de treinamento como RLHF. As execuções foram realizadas exclusivamente em GPUs NVIDIA H200, limitando a transferibilidade numérica do modelo para outras gerações de GPU sem retreinamento. Além disso, a precisão diminui em execuções muito longas devido à escassez de dados nessa faixa.
Que insights a análise de feature importance trouxe para o fine-tuning?
A análise mostrou que a cadência de avaliação (num_eval_data) e o volume de I/O de checkpoints (num_params_saved) são tão importantes quanto o número de parâmetros do modelo. Isso indica que as escolhas de configuração do treinamento impactam significativamente o tempo total, além da complexidade computacional do modelo.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 18 de novembro de 2026
- Editoria
- CEVIU IA