
Execução de Modelos MoE de 180B de Parâmetros em Hardware Limitado é Detalhada
Aprofundamento CEVIU
Aprofundamento
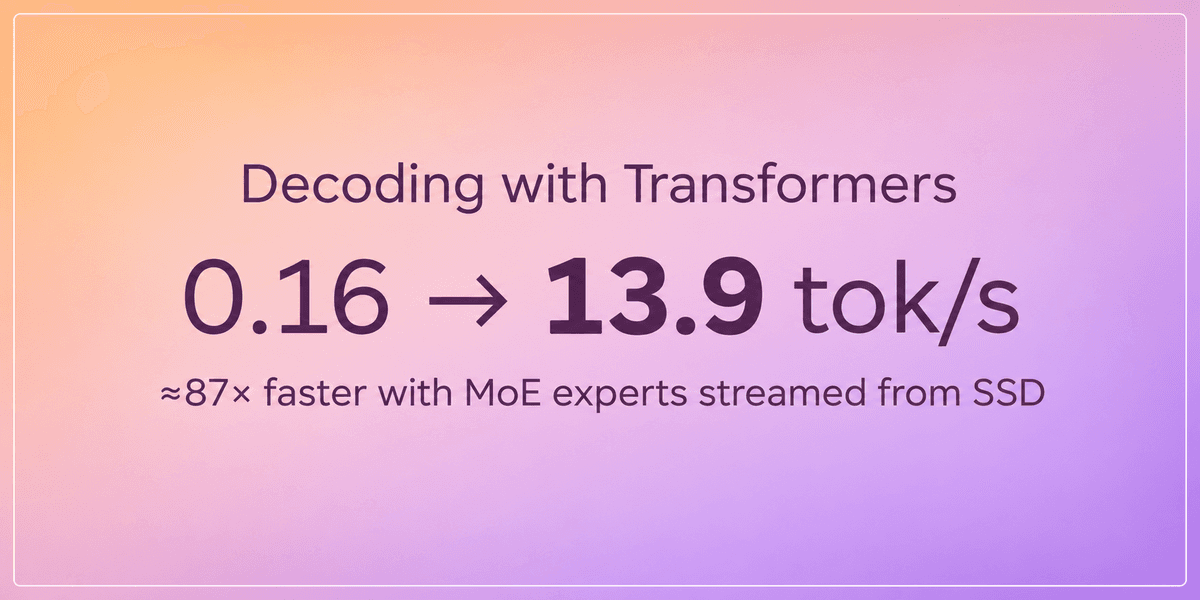
A execução de modelos Mixture-of-Experts (MoE) de grande escala, como o Qwen3.8-Flash-Next com 180 bilhões de parâmetros, em hardware limitado é o foco de um estudo recente. A metodologia proposta envolve o streaming de experts diretamente de um SSD, otimizando o uso da memória. Essa técnica permite que os experts MoE, que compõem a maior parte dos pesos do modelo, sejam carregados sob demanda, evitando a necessidade de VRAM excessiva. O desempenho de geração de tokens se mostra comparável ao método Strata, uma referência na área. Testes práticos foram realizados em PCs com GPUs RTX 4090 e em MacBooks M5 com 32GB de RAM unificada, mostrando a viabilidade da abordagem em configurações de hardware mais modestas.
O que mudou
Em 18 de setembro de 2026, o CEVIU noticiou que modelos MoE poderiam rodar em GPUs de consumidor com SSD, com destaque para o SSD-LLaMA que otimizava o pipeline de I/O. Agora, este estudo detalha uma implementação similar, mostrando que o streaming de experts do SSD para a GPU ou CPU unificada alcança desempenho competitivo, aprimorando a capacidade de execução de modelos MoE de 180B de parâmetros em hardware acessível. O que era uma demonstração de viabilidade geral se aprofunda agora em uma metodologia testada com o Qwen3.8-Flash-Next, um modelo específico de grande porte.
Em agosto de 2026, o CEVIU cobriu soluções como o FreeToken e análises de modelos multimodais densos como Qwen3.8 e Qwen3.6 em GPUs de 24GB. O presente estudo avança ao detalhar não apenas a capacidade de rodar um modelo MoE ainda maior (180B) em hardware de consumidor, mas também as otimizações de software, como o uso do framework Transformers e kernels Metal customizados, para fechar a lacuna de desempenho em relação a soluções dedicadas como o Strata, que já era referência quando da nossa cobertura em 19 de agosto de 2026.
Por que isso importa
Para desenvolvedores e cientistas de dados que operam com hardware de consumidor, esta pesquisa significa a possibilidade de experimentar e utilizar modelos de IA de grande escala, como o Qwen3.8-Flash-Next, que antes seriam restritos a infraestruturas de alto custo. A otimização da memória via streaming de experts do SSD representa um avanço na democratização do acesso a modelos de ponta. Isso abre caminho para a inovação em aplicações locais, especialmente em cenários de desenvolvimento e teste, onde a latência da nuvem e os custos de inferência são fatores limitantes. Além disso, a demonstração em dispositivos como MacBooks M5 com RAM unificada amplia o espectro de uso para profissionais que dependem de mobilidade e desempenho.
Linha do tempo
Avaliação comparativa de modelos multimodais densos (Qwen3.8, Qwen3.6 e Gemma 4) em GPU de 24GB.
Lançamento do FreeToken para otimização de modelos MoE em dispositivos pessoais.
Estudo sobre desempenho de inferência de modelos de IA compactos em dispositivos móveis.
Demonstração de execução de modelos MoE massivos em GPUs de consumidor com SSD (SSD-LLaMA).
Otimização do modelo Muse Spark Open da Meta (816B) para Mac Studios M5 Ultra.
Avaliação de desempenho de LLMs locais em AMD Ryzen AI Max+.
Detalhes sobre a execução de modelos MoE de 180B de parâmetros em hardware limitado via <i>streaming</i> de <i>experts</i> de SSD.
Perguntas frequentes
O que é o <i>streaming</i> de <i>experts</i> em modelos MoE?
É uma técnica para carregar partes de um modelo Mixture-of-Experts (MoE) sob demanda, diretamente de um armazenamento secundário, como um SSD. Isso permite que modelos muito grandes sejam executados em hardware com menos memória de vídeo (VRAM) ou RAM unificada.
Como essa técnica afeta o desempenho da inferência de IA?
A técnica de streaming de experts visa otimizar o uso da memória, mas pode introduzir latência devido ao acesso ao armazenamento. No entanto, o estudo mostra que, com otimizações, o desempenho de geração de tokens pode ser comparável a métodos mais estabelecidos como o Strata, mantendo a eficiência.
Quais tipos de hardware se beneficiam mais dessa abordagem?
Principalmente hardware com VRAM ou RAM unificada limitada, como PCs com GPUs de consumidor (ex: RTX 4090) e laptops (ex: MacBooks M5 com 32GB de RAM unificada). A técnica permite executar modelos que de outra forma não caberiam na memória disponível.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 18 de novembro de 2026
- Editoria
- CEVIU IA