
LiquidAI lança LFM3, família de modelos de 2B de parâmetros para texto, visão, áudio, omni e decisão em um só backbone
Aprofundamento CEVIU
Aprofundamento
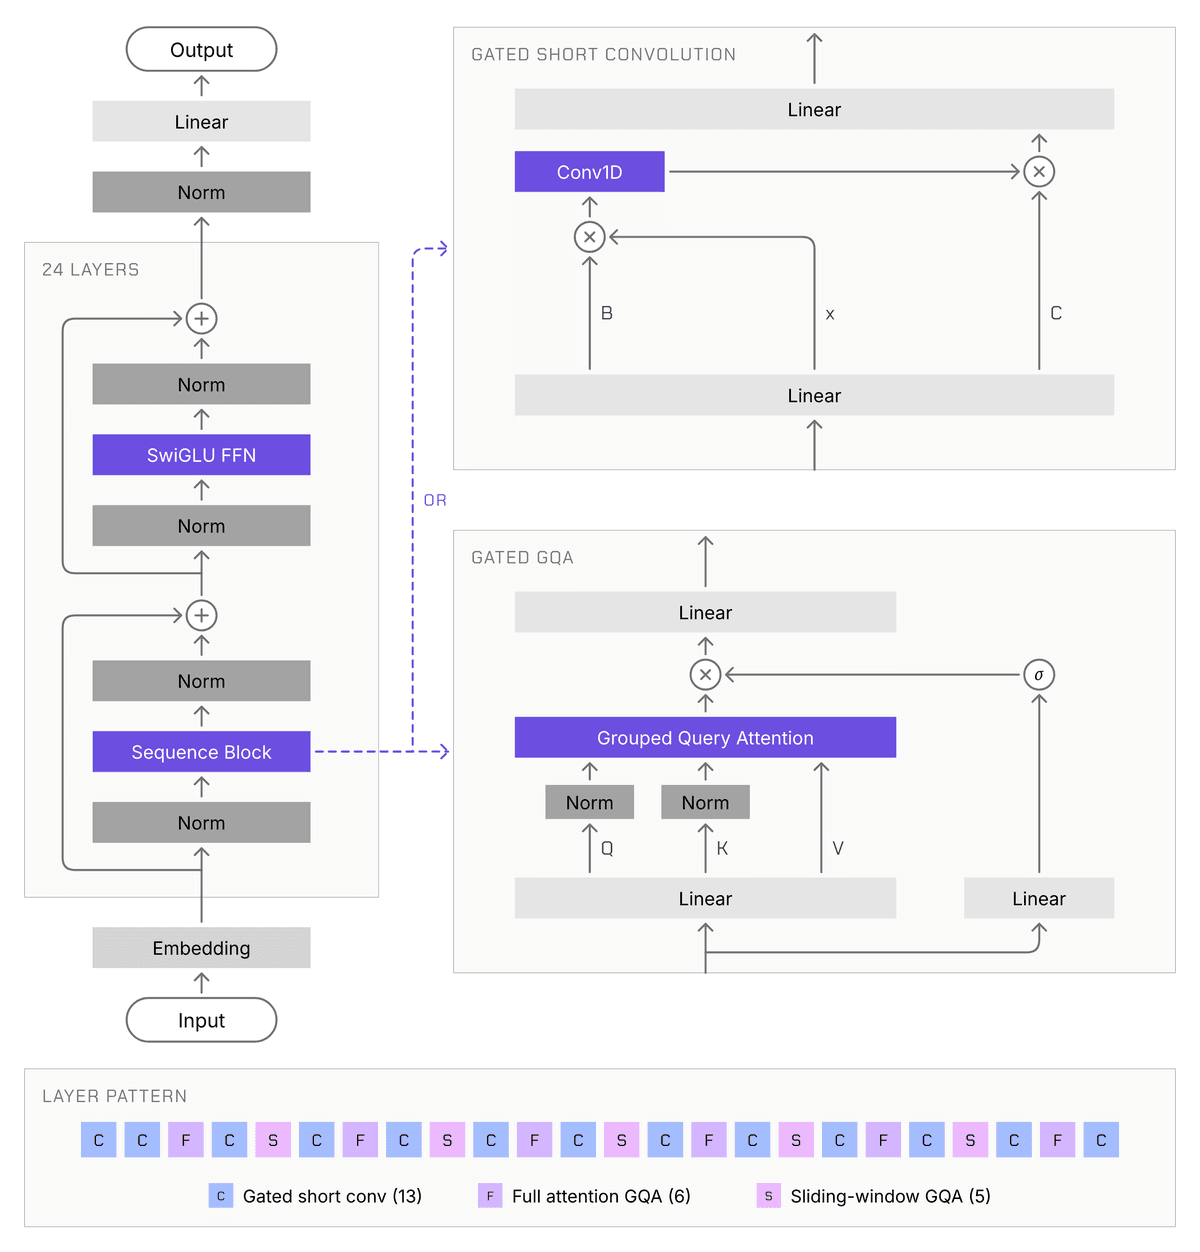
O LFM3 é a nova geração dos Liquid Foundation Models e reúne texto, visão, áudio, omni e decisão em um único backbone, todos na faixa de 2B de parâmetros. Todos os seis modelos partem do LFM3-1.7B-Base, que tem 24 camadas: 13 convoluções curtas com gate (kernel 7, contra 3 no LFM2), 5 de sliding-window attention com janela de 256 tokens e 6 de global attention. A arquitetura também traz head-wise gated attention (que, segundo a fonte, pode ajudar a suprimir outliers de ativação que prejudicam a quantização), Partial RoPE nas camadas globais e sandwich norm.
O pré-treino usou 22T tokens, com o mesmo vocabulário de 128K do LFM2.5-8B-A1B. Os 3,5T finais são mid-training com mais traces agentic e chamadas de ferramentas, o que também estende o contexto para 256K tokens. O modelo de texto cabe em cerca de 1 GB em 4 bits. Nos números da própria LiquidAI, o LFM3-1.7B supera o LFM2.5-2.6B com 35% menos parâmetros e marca 38,42 no WebArena-Verified, contra 3,02. O LFM3-VL-2B (1,9B) sobe a média de 62 benchmarks de visão de 57,6 para 71,4. Todos os modelos são open-weight, rodam em transformers e aceitam fine-tuning em uma única GPU. Os números são medições da fabricante.
O que mudou
Em 26 de junho de 2026, o CEVIU noticiou "Liquid AI lança o Liquid Foundation Model 2.5 com 230 milhões de parâmetros", e o LFM2.5-230M aparece agora como backbone de linguagem usado para medir o encoder de visão do LFM3. Em 8 de outubro de 2026, o CEVIU publicou "Liquid AI Lança Modelos de Decisão d1 Open-Weight para Texto, Visão e Áudio", citando o d1-3B. Agora o d1-2B o substitui com um terço menos parâmetros e nota maior nos quatro suites de decisão da fonte (75,5 contra 64,0 no ImajevBench). Em 6 de outubro de 2026, o CEVIU já havia coberto o d1 com entrada de visão.
Por que isso importa
Para quem opera IA no dispositivo, a leitura é que a LiquidAI aposta em modelos pequenos e especializados por fine-tuning, em vez de um generalista grande. Se os números se confirmarem fora do blog da fabricante, um modelo omni de 2B pode substituir a cadeia ASR, VLM, LLM e TTS em hardware limitado. Vale validar em benchmarks independentes antes de migrar.
Linha do tempo
Liquid AI lança o LFM 2.5 com 230 milhões de parâmetros.
Liquid AI atualiza o d1 com entrada de visão.
Liquid AI lança modelos de decisão d1 open-weight (d1-3B e d1-OMNI-600M).
LiquidAI lança o LFM3, família de 2B com texto, visão, áudio, omni e decisão em um backbone.
Perguntas frequentes
O que é o LFM3 da LiquidAI?
É a nova geração dos Liquid Foundation Models, com seis modelos de classe 2B para texto, visão, áudio, omni e decisão. Todos derivam do mesmo backbone, o LFM3-1.7B-Base. Os pesos são abertos e estão no Hugging Face.
Dá para rodar o LFM3 em dispositivos locais?
Sim, esse é o foco. O modelo de texto ocupa cerca de 1 GB em precisão de 4 bits e tem contexto de 256K, o que permite agentes no dispositivo. A busca de arquitetura cobre 14 combinações de dispositivo e backend, incluindo Raspberry Pi 5 e NPU Qualcomm Hexagon.
Como fazer fine-tuning do LFM3?
Todos os modelos aceitam fine-tuning em uma única GPU. A LiquidAI oferece notebooks para texto, visão, áudio e omni, da preparação de dados à avaliação. O LFM3-1.7B-Base está disponível para pós-treino próprio.
Qual a diferença entre o d1-2B e o d1-omni-2B?
O d1-2B trata texto, imagens e vídeo. O d1-omni-2B entra quando há áudio nas entradas e, segundo a fonte, mantém quase toda a acurácia mesmo com perguntas faladas. Ambos respondem várias perguntas em uma única passagem, com probabilidades calibradas.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 27 de outubro de 2026
- Editoria
- CEVIU IA