
NVIDIA defende codesign full-stack para driblar o gargalo de memória da IA
Aprofundamento CEVIU
Aprofundamento
A NVIDIA parte de um diagnóstico direto: modelos com trilhões de parâmetros, KV cache crescente e trajetórias agentic (que em alguns casos processam até 3 milhões de tokens) pressionam a HBM, enquanto a oferta de memória aperta e os preços sobem. Na inference, a HBM guarda sobretudo os parâmetros do modelo e o KV cache, e os dois disputam capacidade limitada.
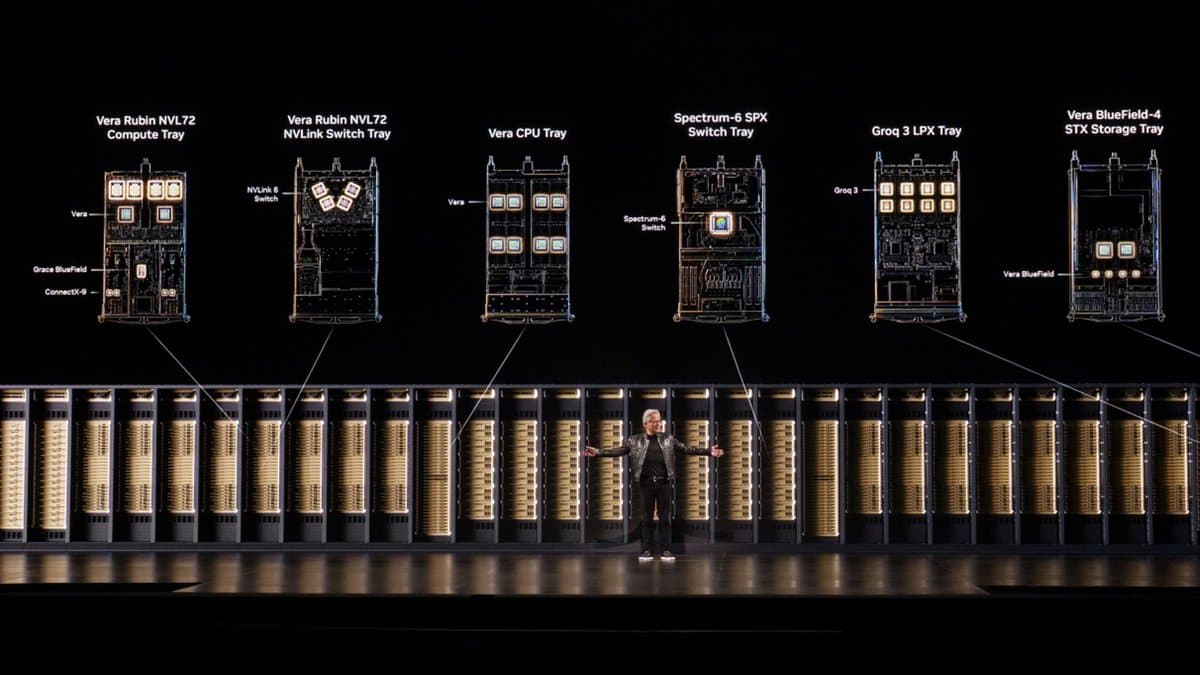
A empresa argumenta que mais capacidade não resolve sozinha, porque ela só rende o que a largura de banda consegue movimentar. Passado o memory wall, a HBM extra continua custando e consumindo energia sem ser aproveitada. A resposta é a hierarquia: NVFP4 para encolher pesos e KV cache em relação ao FP8, pesos distribuídos por até 72 GPUs no NVL72, memória LPDDR da Vera CPU ligada às GPUs Rubin por NVLink-C2C, e o Dynamo movendo contexto inativo para o armazenamento CMX. Nos embeddings de RAG, o índice fica fora da HBM. Nos números da própria NVIDIA, do Blackwell Ultra ao Vera Rubin a HBM por GPU subiu cerca de 3%, e o throughput agentic por dólar subiu até 30x no SemiAnalysis AgentX.
O que mudou
Em 11 de agosto de 2026, o CEVIU noticiou "Nvidia explora versões do Rubin Ultra com menos memória para driblar escassez", e em 14 de agosto de 2026, "Nvidia Reavalia Memória HBM para Rubin Ultra em Meio à Escassez Global". Ambas tratavam da possível redução de memória como movimento reportado por fontes do setor, ou seja, sem confirmação. Agora a NVIDIA apresenta, em texto próprio, a lógica técnica para lidar com a escassez: extrair mais trabalho de cada byte em vez de depender só de mais HBM por GPU. O texto não confirma nenhuma configuração do Rubin Ultra.
Por que isso importa
Para quem opera ou dimensiona clusters de inference, a leitura é que o custo por token tende a depender mais da gestão da hierarquia de memória do que do tamanho da HBM. Isso muda a conta de compra: software, rede e armazenamento entram no cálculo. Vale lembrar que os ganhos citados vêm de benchmarks escolhidos e divulgados pela própria fornecedora.
Linha do tempo
CEVIU noticia que a Nvidia estaria avaliando versões do Rubin Ultra com menos memória.
CEVIU noticia que a Nvidia reavalia a HBM do Rubin Ultra em meio à escassez global.
NVIDIA defende codesign full-stack para contornar o gargalo de memória da IA.
Perguntas frequentes
O que é o memory wall citado pela NVIDIA?
É o ponto em que a largura de banda da memória não consegue entregar dados na velocidade em que o compute os consome. Depois dele, aumentar a capacidade de HBM não traz ganho útil. A memória extra segue gerando custo e consumo de energia.
Como o NVFP4 ajuda a economizar HBM?
O formato NVFP4 reduz o espaço ocupado pelos pesos em comparação ao FP8, que é a menor precisão possível na plataforma Hopper. Aplicado ao KV cache, também diminui seu tamanho, e mais contexto fica residente na HBM. A NVIDIA cita vários modelos recentes já lançados com checkpoints em NVFP4.
Para que serve o CMX context memory storage?
É uma camada de armazenamento pensada para guardar contexto inativo com custo por bit bem menor que o da HBM. Diferente de SSDs locais, é compartilhada entre servidores. E dispensa a proteção de dados de longo prazo, que um contexto de curta duração não exige. O Dynamo move o contexto para lá e o traz de volta antes da reutilização.
Quanto o throughput por dólar melhorou segundo a NVIDIA?
No SemiAnalysis AgentX com DeepSeek V4 Pro, o GB300 NVL72 entrega até 10x mais throughput por dólar que a plataforma H200 a 100 tokens por segundo por usuário. O Vera Rubin NVL72 chega a até 30x sobre o GB300 NVL72 a 125 tokens por segundo por usuário. Nesse último salto, a HBM por GPU subiu cerca de 3%.
Fontes
- blogs.nvidia.comfonte original
- Categoria
- CEVIU Hardware
- Publicado
- 05 de novembro de 2026
- Editoria
- CEVIU Hardware