
Point queries no DataFusion: boas práticas para buscas de linha única com baixa latência
Aprofundamento CEVIU
Aprofundamento
O texto de Nuno Faria (INESC TEC), publicado em 24 de outubro de 2026, parte de uma palestra no meetup de DataFusion em Boston, em setembro de 2026. O objetivo é fazer point reads terminarem em menos de 1 ms. O teste usa um único arquivo Parquet com 100 milhões de linhas, colunas k (bigint, único) e v (varchar, md5 da chave), numa VM c4d-standard-4 com disco de 6k IOPS.
No armazenamento, o maior ganho vem da ordenação por chave: a versão ordenada teve throughput 6000x maior, lendo uma página em um row group, contra em média 67 row groups e 122 páginas no arquivo desordenado. Também ajudam desligar dictionary encoding (a chave tem muitos valores distintos) e manter sem bloom filters (min/max já bastam). O melhor ponto para lookups ficou perto de 128k linhas por row group e 1k por página, longe dos padrões (1M e 20k). Para atender também análise, 2k a 4k linhas por página funcionou bem. Em compressão, lz4 é mais rápido e zstd tem o melhor equilíbrio.
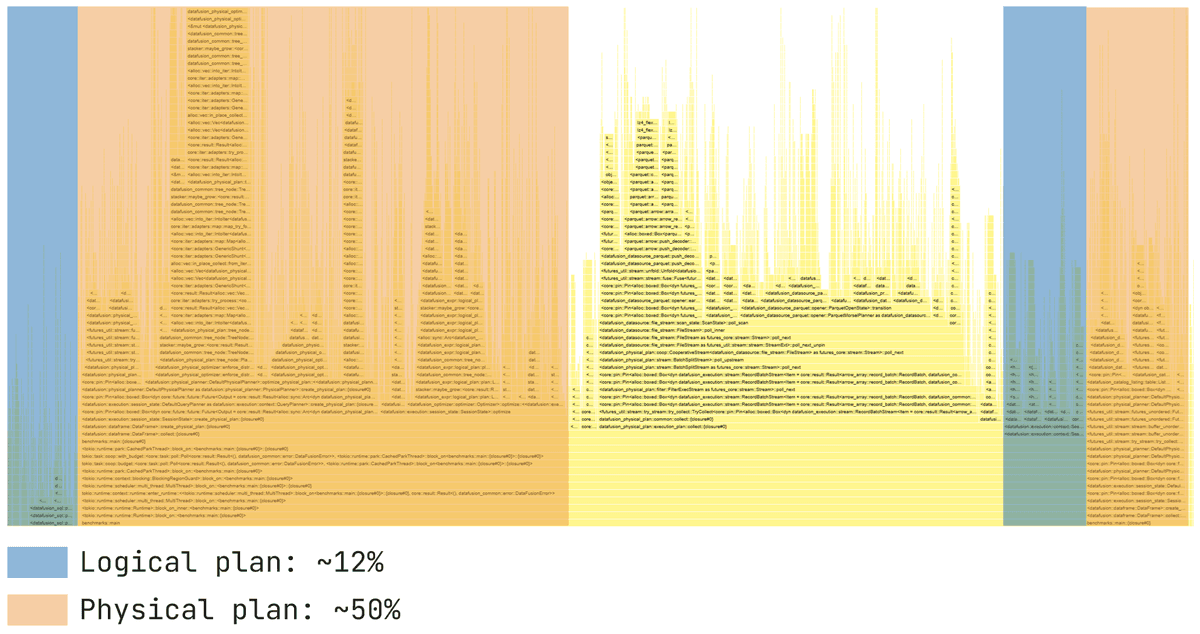
Na execução, target_partitions igual a 1 favorece leituras pequenas, enquanto leituras grandes (10M linhas) preferem paralelismo. O pushdown_filters ajudou em leituras pequenas e grandes, mas segue desligado por padrão porque piora algumas consultas. O cache de metadados vem ativo desde a versão 50.0.0 (limite padrão de 50MB). Em prepared statements, o DataFusion só reaproveita o plano lógico. Um protótipo que reutiliza o plano físico dobrou ou triplicou o throughput, mas ainda não existe no projeto.
Por que isso importa
Para quem opera DataFusion como camada de consulta sobre Parquet, a leitura é que dá para atender buscas por chave sem outro banco, desde que o arquivo seja escrito já pensando nisso. Ordenação e tamanho de página custam pouco na escrita e rendem muito na leitura. O ponto de atenção é que várias configurações dependem da carga, então vale medir com o seu padrão de acesso.
Perguntas frequentes
Por que ordenar o Parquet pela chave faz tanta diferença em point queries?
O DataFusion usa estatísticas de mínimo e máximo por row group e página para decidir o que ler. Com o arquivo ordenado, os intervalos são estreitos e só uma página precisa ser acessada. No teste, o arquivo desordenado exigiu em média 67 row groups e 122 páginas.
Quais tamanhos de row group e página são melhores para buscas de linha única?
No benchmark, valores perto de 128k linhas por row group e 1k por página foram os melhores. Os padrões do DataFusion são 1M e 20k. Se o mesmo arquivo atende análise e lookups, 2k a 4k linhas por página deram bom resultado nos dois casos.
Vale usar target_partitions igual a 1?
Para leituras pequenas, sim, porque evita o custo de coalescer partições extras. Para leituras grandes, como 10M linhas, o paralelismo padrão é mais rápido. Dá para alterar em tempo de execução com SET datafusion.execution.target_partitions.
Os prepared statements do DataFusion reaproveitam o plano físico?
Hoje não, só o plano lógico. O autor testou um protótipo que cacheia o plano físico e obteve de 2x a 3x mais throughput. Essa versão ainda não está disponível no DataFusion.
Fontes
- datafusion.apache.orgfonte original
- Categoria
- CEVIU Dados
- Publicado
- 29 de outubro de 2026
- Editoria
- CEVIU Dados