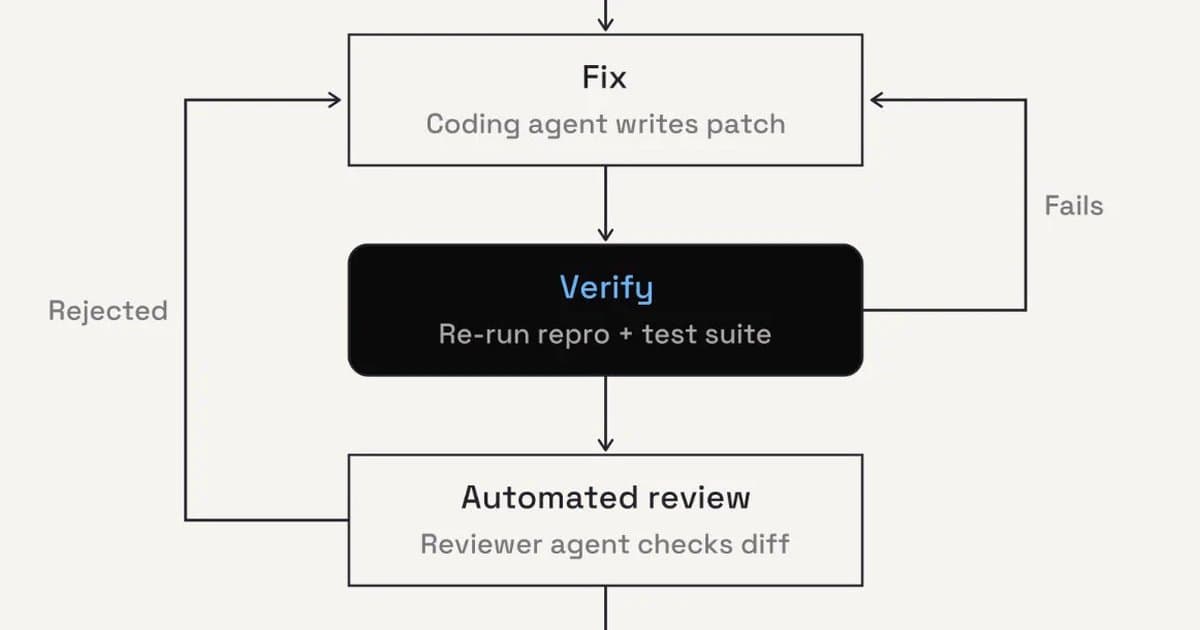
Segundo o claude.dev, uma equipe de 1.000 agentes reproduziu uma prova formal do Último Teorema de Fermat em 28,7 horas. Cada agente trabalhou em sandboxes separados, com Git compartilhado e um banco de dados SQL para coordenação. O experimento combinou triagem de comandos e monitoramento offline com acesso restrito à rede, e consumiu um terço dos tokens de saída da formalização anterior. Para quem desenvolve, o caso mostra um arranjo de isolamento, versionamento e coordenação para escalar equipes multiagentes com mais segurança no Claude Fable 5.2.
Textos escritos por IA sobrecarregam o leitor quando escondem quem está agindo, usam linguagem vaga ou enterram o ponto principal em afirmações vazias e ênfases fora de lugar. O post compara artigos e discussões sobre código usando uma taxonomia de clareza. O argumento é que essas falhas pesam mais do que as assinaturas conhecidas de textos de IA, como frases prontas ou o uso de certa pontuação.
A PostHog usa decision models para responder perguntas específicas, com saídas tipadas e pontuações de probabilidade, antes de acionar modelos maiores. O filtro de dados pessoais da empresa evita 98,7% das chamadas a LLMs. Os limiares (thresholds) são definidos de acordo com o custo de falsos positivos e falsos negativos.
A Dropbox usou IA para rastrear dependências da plataforma, prototipar integrações e criar componentes React compartilhados entre seus apps web e desktop. Tarefas com escopo definido, delegadas a agentes, também entregaram 22 melhorias de acessibilidade e concluíram em uma semana um backlog de 53 tarefas de limpeza de testes. Em todos os casos, engenheiros revisaram os resultados.
À medida que a IA torna mais barato encontrar e corrigir bugs, decidir o que o software deve fazer vira o verdadeiro gargalo. Feedback real de usuários, usuários simulados e testes determinísticos deixam lacunas na definição do comportamento esperado. O artigo recomenda smoke tests e jornadas de usuário realistas, o uso de convenções já estabelecidas para as decisões menores e a manutenção da responsabilidade humana sobre as escolhas de produto.
A Anthropic recomenda começar a maior parte das tarefas de código e de trabalho de conhecimento no Opus 5.5 com esforço médio, usar modelos menores nas tarefas mais simples e reservar o Fable 5.2 para os trabalhos técnicos mais difíceis. O guia também detalha como as configurações de effort, o prompt caching e a compatibilidade entre os thinking blocks dos modelos influenciam o custo e a confiabilidade ao trocar de modelo.
Os agentes de IA estão corroendo a escassez de talento em engenharia, que sustentava as altas margens do software. Ao mesmo tempo, tornam os produtos mais fáceis de copiar e os clientes mais fáceis de migrar. Com o desenvolvimento mais barato, produtos menores e especializados podem ganhar espaço, e o valor das aquisições tende a se deslocar para clientes e distribuição. Isso porque vendas continuam sendo um gargalo e o código se torna menos durável como ativo.
O Muse Ember é o modelo multimodal pequeno da Meta, pensado para tarefas repetitivas de agentes, como tool calls, routing, extraction e subtarefas de programação. Segundo a própria Meta, ele entrega forte eficiência de custo em comparação com o Haiku 5.5 e o GPT-6 Luna. Na avaliação FrontierCode 2.0, porém, o Haiku fica à frente.
A verificação de localização pode ajudar a detectar chips de IA avançados desviados para destinos restritos, mesmo com os controles de exportação em vigor. O artigo examina os esforços para determinar onde esses chips estão em operação, enquanto legisladores dos EUA defendem a exigência de verificação.
O Claude Fable 5.2 projetou um viva-voz, um hub de assistente de voz e um pet virtual, cobrindo placas de circuito, carcaças, firmware e instruções de montagem. Engenheiros humanos construíram protótipos funcionais sem precisar corrigir os circuitos. Os dispositivos, porém, ainda não passaram por validação elétrica, ajuste de antena, testes térmicos ou certificação.
Mesmo com agentes de IA assumindo cada vez mais tarefas de código, debugging e arquitetura, engenheiros seguem tendo valor. Esse valor está na definição de problemas, no julgamento e no conhecimento tácito, moldado pela experiência vivida.
O Nunebot é um prompt reutilizável que percorre repositórios e abre um pequeno PR de manutenção em cada um. Antes disso, o fluxo passa por etapas de simplificação, QA, revisão adversarial e CI.