
Airbnb iguala frontier models em classificador de políticas com fine-tuning de modelo pequeno por cerca de 1% do custo
Aprofundamento CEVIU
Aprofundamento
O Airbnb avaliou um classificador de produção que filtra conteúdo que viola a política de transparência de preços e pagamentos. O modelo é chamado milhares de vezes por minuto e bloqueia a publicação em tempo real, então precisa devolver o score em até 200 ms. Falso positivo aqui impede conteúdo legítimo de ir ao ar, por isso a precisão pesa.
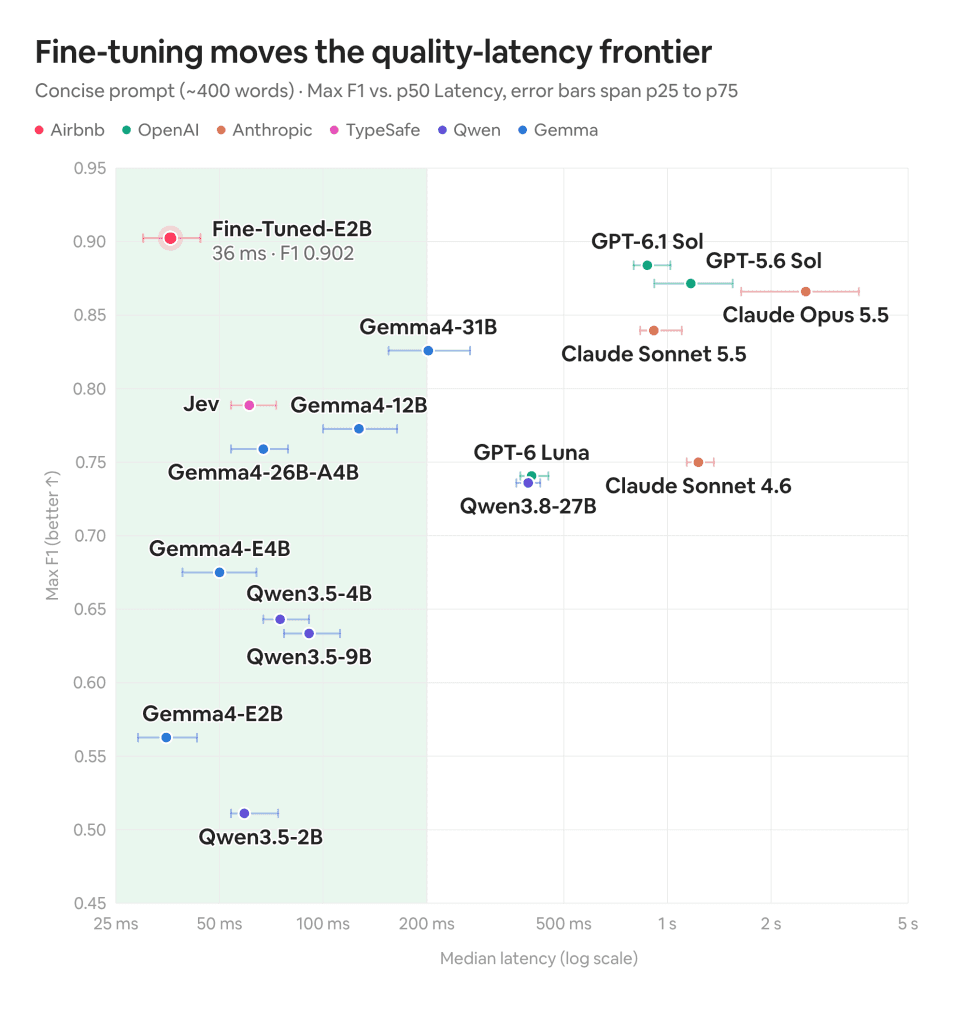
O teste usou um conjunto held-out de 10.000 exemplos ponderados. Os modelos open-weight rodaram com vLLM 0.28.0 em uma única GPU NVIDIA RTX Pro 6000, com bfloat16 até 12B parâmetros e checkpoints FP8 ou NVFP4 nos maiores. O Gemma4-E2B, ajustado com centenas de milhares de exemplos do domínio via GLOWC, framework interno da empresa, foi de 0,563 para 0,902 de max F1, com latência mediana de 35 ms e cerca de 85 ms no p99. GPT-6.1 Sol e Claude Sonnet 5.5, mesmo em modo de baixo raciocínio, ficaram perto de 900 ms de mediana e com p99 na casa dos segundos. O Jev, da TypeSafe, retorna probabilidade em vez de veredito e foi o melhor modelo pronto abaixo de 100 ms.
O que mudou
Em 5 de novembro de 2026, o CEVIU noticiou "Airbnb iguala frontier models em classificação com modelo fine-tuned e custo muito menor", com o salto de F1 de 0,563 para 0,902. Esta nova matéria acrescenta o recorte de custo e latência: mediana de 35 ms, servir em uma GPU custando cerca de 1% das APIs de frontier models, e o ponto de virada em que os modelos hospedados ficam mais baratos, abaixo de aproximadamente 15 a 30 requisições por minuto.
Por que isso importa
Para quem opera classificação em alto volume, o recado é que a conta depende do tráfego. Uma GPU custa o mesmo ociosa ou ocupada, enquanto a API cresce linearmente com o volume. Em tarefas de baixo volume ou que mudam toda semana, um frontier model com bom prompt segue sendo a escolha razoável. Quem tem dados rotulados e precisa de threshold ajustável, e não de um veredito fixo, encontra aqui um argumento forte para o fine-tuning.
Linha do tempo
CEVIU noticia o Airbnb igualando frontier models em classificação com modelo fine-tuned.
Benchmark detalhado mostra F1 de 0,902, 35 ms de mediana e custo de cerca de 1% das APIs em alto volume.
Perguntas frequentes
Qual foi o resultado do classificador fine-tuned do Airbnb?
O modelo Gemma4-E2B chegou a 0,902 de max F1, contra 0,563 antes do ajuste. A latência mediana ficou em 35 ms. Isso o coloca no nível dos melhores modelos proprietários testados.
Quando vale mais a pena usar API de frontier model?
Em baixo tráfego. No benchmark, abaixo de cerca de 15 a 30 requisições por minuto, Claude Sonnet 5.5 e GPT-6.1 Sol saíram mais baratos que uma GPU dedicada. O Airbnb também indica API com bom prompt para tarefas que mudam toda semana.
Um prompt maior não resolve a diferença de qualidade?
Ajuda pouco nos modelos rápidos. Com um prompt detalhado de 2.700 palavras, os modelos proprietários ganharam de um a três pontos e se aproximaram do classificador ajustado, mas com latência bem maior. Nos modelos abaixo do orçamento de latência, a lacuna continuou grande.
Por que usar score em vez de veredito?
O score permite escolher o equilíbrio entre precisão e recall por meio de um limiar. Modelos que só devolvem verdadeiro ou falso entregam um ponto fixo, e mudar isso exige reescrever o prompt.
Fontes
- airbnb.techfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 06 de novembro de 2026
- Editoria
- CEVIU Web Dev