
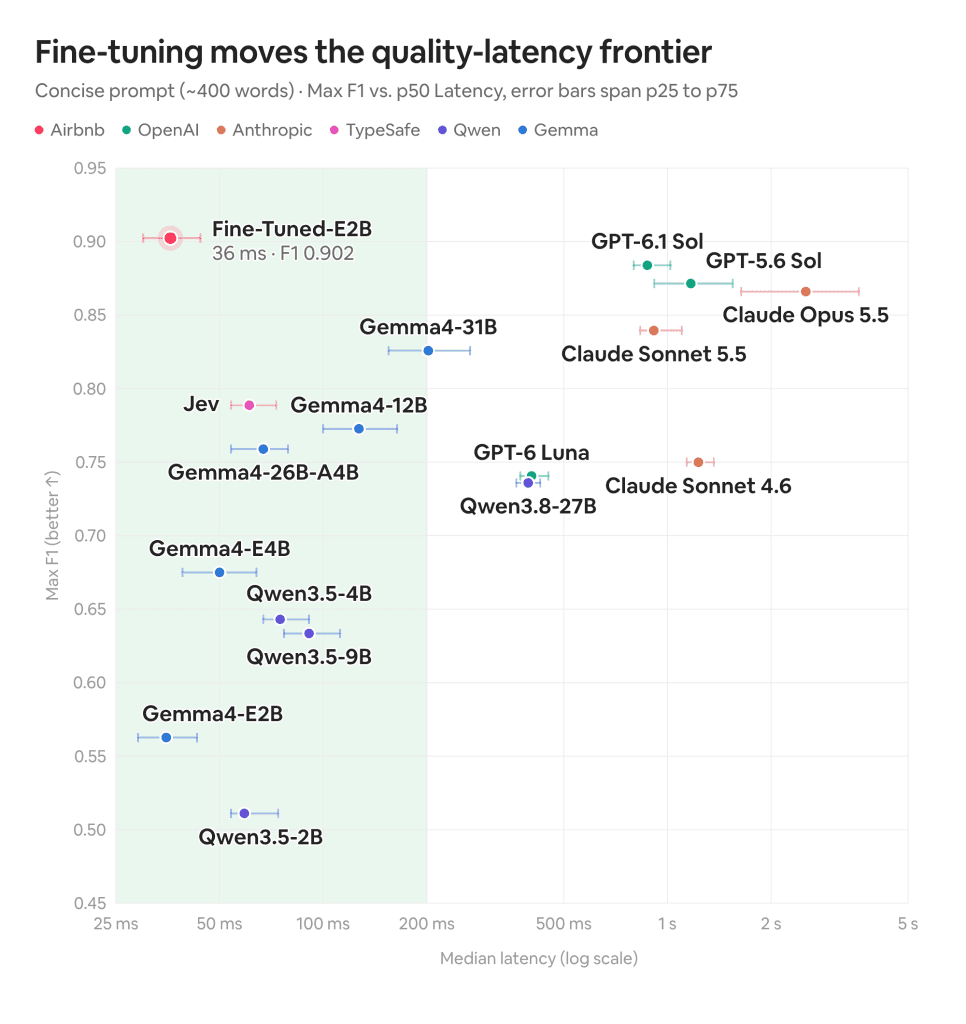
Airbnb iguala frontier models em classificação com modelo fine-tuned e custo muito menor
Aprofundamento CEVIU
Aprofundamento
O teste do Airbnb usa um caso real de produção: um classificador que filtra conteúdo que viola a política de transparência de preços e pagamentos. O modelo é chamado milhares de vezes por minuto e bloqueia a publicação em tempo real, então precisa responder em até 200 ms. Falso positivo tem custo alto, porque impede a publicação de conteúdo legítimo.
A comparação usou 10.000 exemplos ponderados de avaliação separados do treino. Os pesos corrigem o viés de amostragem do tráfego de produção, e um subconjunto de modelos foi validado em 184 mil exemplos, com max F1 dentro de 0,01. Os modelos open-weight rodaram em vLLM 0.28.0 numa única NVIDIA RTX Pro 6000. O Gemma4-E2B passou de F1 0,563 para 0,902 após fine-tuning com centenas de milhares de exemplos do domínio, com latência mediana de 35 ms e cerca de 85 ms no p99. Já GPT-6.1 Sol e Claude Sonnet 5.5, mesmo com pouco raciocínio, ficaram perto de 900 ms de mediana e vários segundos no p99.
Há um ponto de modelagem importante. As APIs proprietárias devolvem só um veredito, ou seja, um único ponto de precisão e recall (0,82 de precisão e 0,96 de recall no GPT-6.1 Sol com o prompt curto). O classificador próprio entrega score, e o limiar pode ser ajustado sem reescrever prompt. Um prompt detalhado de 2.700 palavras deu ganho de um a três pontos nos modelos proprietários, mas não fechou a distância nos modelos rápidos o bastante para o orçamento de latência.
No custo, a GPU custa o mesmo ocupada ou ociosa, enquanto a API cobra por token, de forma linear com o volume. Com milhares de RPM, os frontier models custam duas ordens de grandeza acima de uma GPU. Abaixo de 15 a 30 RPM, Claude Sonnet 5.5 e GPT-6.1 Sol saem mais baratos. O Airbnb diz que o preço das APIs usa tabela pública de outubro de 2026 e assume 71% de cache hit, taxa maior que a observada na prática.
Por que isso importa
Para quem opera classificação em alto volume, o recado é de arquitetura: o gargalo costuma ser latência, custo e controle de limiar, não só acurácia. Se você tem dados rotulados e tráfego constante, fine-tuning de um modelo pequeno self-hosted pode ser a escolha mais racional. Se o volume é baixo ou a tarefa muda toda semana, um frontier model com bom prompt segue fazendo sentido, como o próprio Airbnb admite. Vale lembrar que é um único caso, medido pela empresa em seu ambiente.
Linha do tempo
Airbnb publica benchmark em que classificador fine-tuned de 2B parâmetros efetivos iguala frontier models com latência de 35 ms e custo muito menor.
Perguntas frequentes
Quanto o fine-tuning melhorou o modelo do Airbnb?
O F1 do Gemma4-E2B subiu de 0,563 para 0,902, no nível dos melhores modelos proprietários testados. A latência mediana ficou em 35 ms. O treino usou centenas de milhares de exemplos do domínio.
Em que volume self-hosting compensa em relação às APIs?
Nesse benchmark, acima de cerca de 30 RPM uma GPU dedicada já custa menos que as APIs frontier. Abaixo de 15 a 30 RPM, Claude Sonnet 5.5 e GPT-6.1 Sol saem mais baratos. Com milhares de RPM, a diferença chega a duas ordens de grandeza.
Um prompt maior não resolve o problema nos modelos pequenos?
Não resolveu. O prompt de 2.700 palavras deu de um a três pontos aos modelos proprietários, que passaram a igualar o classificador fine-tuned, mas com muito mais latência. Nos modelos dentro do orçamento de latência, o ganho foi modesto e a distância continuou grande.
Por que ter um score é melhor que um veredito?
Com score dá para definir o limiar e escolher o equilíbrio entre precisão e recall. Nas APIs que só devolvem verdadeiro ou falso, mudar esse ponto exige reescrever o prompt. Numa tarefa em que falso positivo é caro, esse controle pesa.
Fontes
- airbnb.techfonte original
- Categoria
- CEVIU Dados
- Publicado
- 05 de novembro de 2026
- Editoria
- CEVIU Dados