
Experimentos mostram GPT-6 Astra lendo e editando pesos de redes neurais sem gradient descent
Aprofundamento CEVIU
Aprofundamento
O trabalho vem de Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, do MIT CSAIL, e foi publicado em 2 de novembro de 2026. Eles chamam a técnica de Weight-Space Programming: um LLM de uso geral lê e escreve os pesos de uma rede diretamente, a partir de uma especificação em linguagem natural, sem otimizador e sem gradient descent. Em alguns testes, nem há feedback do ambiente.
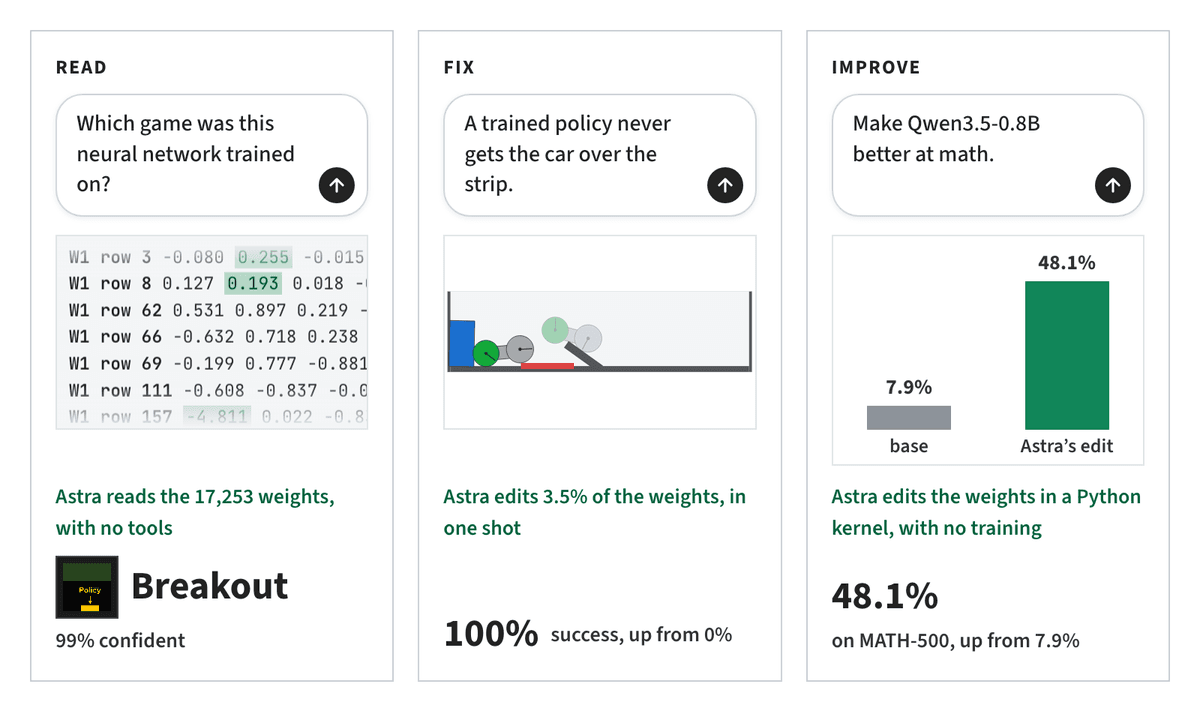
Os experimentos vão de redes pequenas a modelos reais. O GPT-6 Astra identificou, só pelos pesos brutos, em qual dos quatro jogos cada rede PPO foi treinada. Em modelos de linguagem de 7,2M de parâmetros sem as camadas de entrada e saída, acertou o idioma (Python, romaji e inglês) e achou as induction heads. Escreveu do zero redes para três jogos MinAtar (Breakout, Seaquest e Asterix) que superaram PPO treinado por 100 milhões de passos. Numa rede de 1,5 milhão de parâmetros (243 → 512 × 6 → 82) para Go, com até 50 forward passes, venceu a rede PPO de mesmo tamanho treinada em 20 milhões de partidas.
No Qwen3.5-0.8B, o Astra apontou no peso o problema dos loops de raciocínio, que o próprio model card do Qwen já alerta. Editou 0,016% dos pesos e levou o MATH-500 de 7,9% para 48,1%, com as mesmas configurações de amostragem. O IFEval subiu 3x. Já no teste com dois Gemma 3 270M (um correto, outro bajulador), o Astra não distinguiu os modelos só pelos pesos. Só acertou ao ver os padrões de atenção em textos que ele mesmo escreveu.
O que mudou
A cobertura anterior mostra o debate em torno do mesmo trabalho. Em 3 de novembro de 2026, o CEVIU noticiou "LLMs não são sobre-humanos em ler e escrever pesos de redes neurais, argumenta artigo" e, no mesmo dia, "LLMs não leem nem escrevem pesos de redes neurais de forma sobre-humana", em que o texto do seangoedecke.com sustenta que a melhor forma de atualizar pesos continua sendo treinar normalmente. A notícia de hoje volta aos números e ao método do estudo original, que serve de base para essas críticas.
Por que isso importa
Para quem desenvolve e ajusta modelos, a leitura é que edição direta de pesos pode virar ferramenta de diagnóstico e correção pontual, como no caso dos loops. Mas os próprios autores chamam os resultados de muito iniciais, e o fracasso no Gemma e no teste do modelo bajulador mostra limites claros. Vale tratar como pista de pesquisa, não como substituto do treino.
Linha do tempo
Pesquisadores do MIT CSAIL publicam o estudo sobre Weight-Space Programming com o GPT-6 Astra.
CEVIU noticia críticas de que LLMs não leem nem escrevem pesos de forma sobre-humana.
Experimentos mostram o Astra editando pesos sem gradient descent, elevando o MATH-500 do Qwen3.5-0.8B de 7,9% para 48,1%.
Perguntas frequentes
O que é Weight-Space Programming?
É o nome que os pesquisadores do MIT CSAIL dão ao uso de um LLM geral para ler e escrever diretamente os pesos de uma rede neural. Isso acontece sem otimizador e sem gradient descent, guiado por uma especificação em linguagem natural.
O que o GPT-6 Astra fez no Qwen3.5-0.8B?
Ele identificou nos pesos um problema que causava loops de raciocínio e editou 0,016% deles. Com as mesmas configurações de amostragem, o MATH-500 foi de 7,9% para 48,1% e o IFEval subiu 3x.
A técnica funciona em qualquer modelo?
Não. Em um modelo Gemma, que raramente entrava em loop, edições semelhantes não trouxeram melhora significativa. O ganho no Qwen veio de remover um obstáculo a uma capacidade que o modelo já tinha.
O Astra consegue identificar comportamento só pelos pesos?
Em vários casos sim, como o jogo de cada rede PPO e o idioma dos modelos pequenos. Mas falhou em distinguir o Gemma 3 270M bajulador do correto só pelos pesos. Acertou depois que pôde olhar os padrões de atenção.
Fontes
- rikiyat.github.iofonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 04 de novembro de 2026
- Editoria
- CEVIU Web Dev