
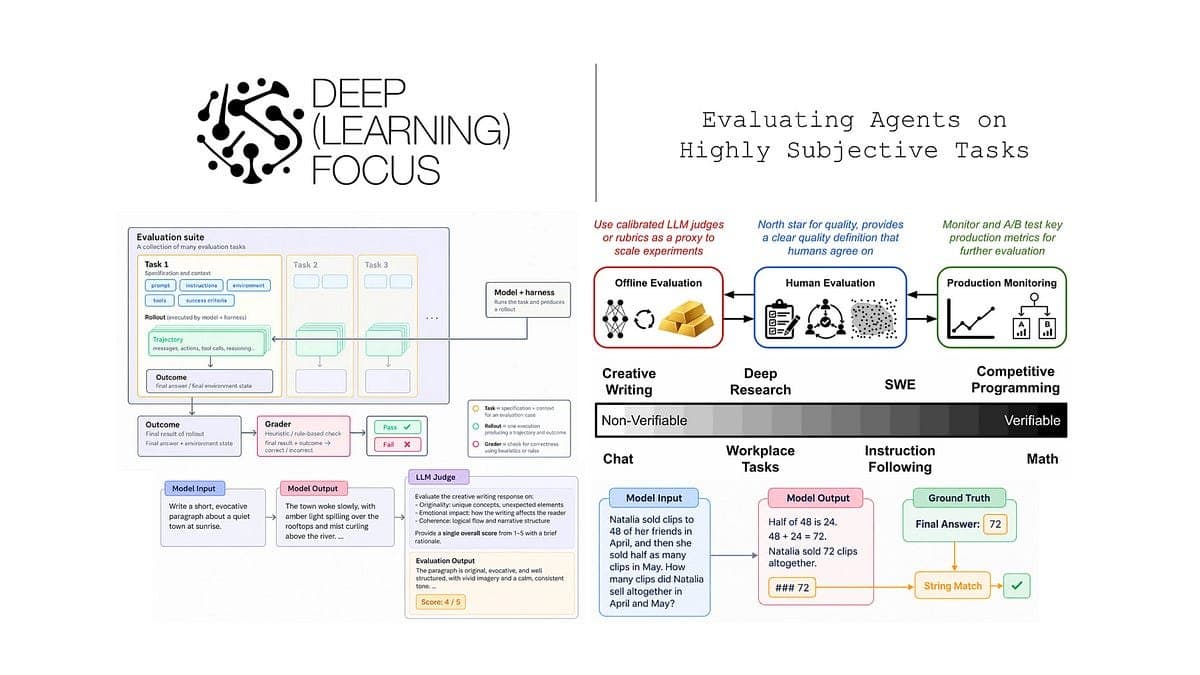
Como avaliar agentes de IA em tarefas altamente subjetivas
Aprofundamento CEVIU
Aprofundamento
A fonte parte de um problema conhecido: agentes resolvem tarefas amplas, muitas vezes longas e caras de avaliar, e ainda são não determinísticos. Uma nota maior em benchmark não prova que o agente ficou melhor. O benchmark pode não refletir o uso real, e a nota pode oscilar entre execuções só por variação. Em tarefas subjetivas, como escrita criativa, não existe verificação determinística (testes executáveis, string matching), então entram humanos ou juízes de LLM, que trazem mais ruído.
O texto propõe um roteiro em três partes: avaliação humana, avaliação offline e monitoramento em produção. Na parte estatística, cita três ferramentas. A análise de poder estima quantas amostras são necessárias a partir do efeito mínimo a detectar, da variabilidade e do nível de significância. Os intervalos de confiança (média ± 1,96 × erro padrão, para 95%) mostram a incerteza da nota. O erro padrão agrupado (clustered) vale quando as tarefas não são independentes, por exemplo se vêm do mesmo código-fonte ou documento. Já a reamostragem roda o agente, e o juiz, várias vezes e tira a média. Sobre juízes e rubricas, a fonte diz que o juiz aplica critérios gerais (como coerência numa escala Likert de 1 a 5), enquanto a rubrica quebra a qualidade num checklist por tarefa. Como ambos são proxies imperfeitos, é preciso meta-avaliação contra um conjunto de referência feito por humanos.
O que mudou
A cobertura anterior do CEVIU mostra um tema que vem sendo construído. Em 5 de março de 2026, o CEVIU publicou "Avaliações de IA no Mundo Real: Julgamento Humano, Juízes LLM e as Lacunas Existentes", sobre as limitações de pontuações convencionais em bots de atendimento. Em 23 de setembro de 2026, veio "Avaliação de Agentes de IA: Além da Simples Chamada de Ferramentas", com foco em pontuação por etapa. Em 15 de outubro de 2026, o CEVIU noticiou "LangChain Detalha Metodologias para Avaliação Robusta de Agentes de IA", que fala em combinar avaliadores de código e analisar traces. Em 16 de outubro de 2026, saiu "Avaliação de Fluxos de Trabalho com Agentes de IA: Entendendo o Custo Humano e Computacional". Esses textos tratavam de métricas e métodos. A matéria atual acrescenta o lado estatístico, ou seja, como saber se uma melhora é real ou ruído.
Por que isso importa
Para quem desenvolve e testa agentes, a leitura é que comparar duas versões pela nota de uma única rodada é arriscado. Calcular o tamanho de amostra antes, reportar intervalo de confiança e repetir execuções ajuda a evitar decisões baseadas em variação. Vale também validar o juiz de LLM contra exemplos humanos antes de confiar nele.
Linha do tempo
CEVIU publica sobre juízes LLM e julgamento humano em avaliações de IA no mundo real.
CEVIU aborda avaliação de agentes de IA além da chamada de ferramentas.
CEVIU noticia as metodologias de avaliação de agentes da LangChain.
CEVIU discute o custo humano e computacional na avaliação de fluxos com agentes.
CEVIU explica como avaliar agentes de IA em tarefas altamente subjetivas.
Perguntas frequentes
Por que avaliar agentes em tarefas subjetivas é mais difícil?
Não dá para verificar a resposta de forma determinística, como com testes executáveis. É preciso recorrer a humanos ou a juízes de LLM, e ambos discordam com frequência quando os critérios são subjetivos. Isso soma ruído ao já causado pela não determinismo dos agentes.
Qual a diferença entre juiz de LLM e rubrica?
O juiz de LLM aplica critérios de qualidade gerais a várias tarefas, como coerência numa escala de 1 a 5. A rubrica divide a qualidade em um checklist de critérios específicos de cada tarefa, e cada item pode ser checado por um juiz de LLM.
Para que serve a análise de poder?
Ela estima, antes da avaliação, quantas amostras são necessárias para detectar uma melhora mínima definida por você. Considera a variabilidade esperada das notas e o nível de significância desejado.
Como reduzir o ruído causado pela não determinismo?
Rodando o agente várias vezes na mesma tarefa e fazendo a média, possivelmente com mais de uma rodada de julgamento também. Ao comparar dois agentes, avaliar nas mesmas tarefas e usar o intervalo de confiança das diferenças pareadas pode estreitar a incerteza.
Fontes
- cameronrwolfe.substack.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU Web Dev