
Como avaliar agentes de IA em tarefas altamente subjetivas
Aprofundamento CEVIU
Aprofundamento
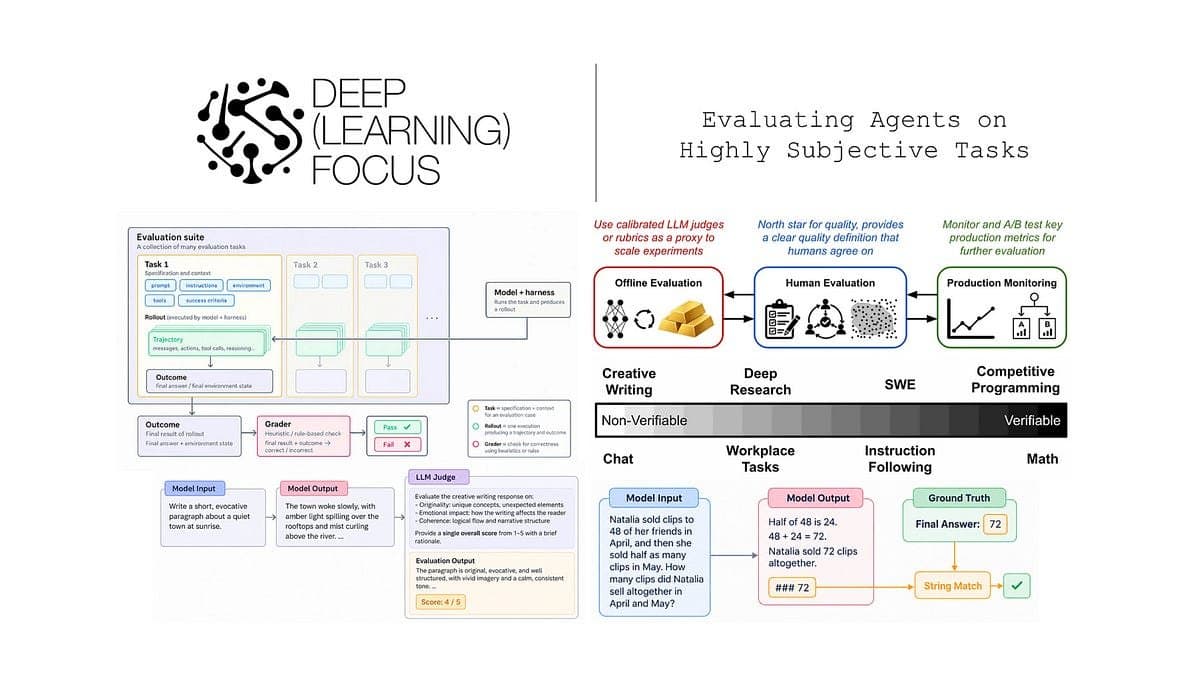
A fonte parte de um problema conhecido: avaliar agentes é caro e ruidoso. Os agentes cobrem muitos domínios, executam tarefas longas e são não determinísticos. Um score maior num benchmark não prova que o agente ficou melhor. Em tarefas subjetivas, como escrita criativa, o quadro piora, porque não existe verificação determinística e é preciso recorrer a humanos ou a juízes LLM, que também divergem entre si.
O roteiro proposto tem três partes: avaliação humana, avaliação offline e monitoramento em produção. Na camada automática, juízes LLM aplicam critérios fixos (por exemplo, coerência numa escala Likert de 1 a 5) e rubricas quebram a qualidade em checklists específicos por tarefa. Como os juízes têm vieses sistemáticos, a fonte pede meta-avaliação: comparar suas notas com um conjunto de ouro feito por humanos, usando correlação, acurácia ou métricas de concordância entre avaliadores. Há ainda a opção de checar se a nota do juiz prevê métricas de produção, como taxa de abandono.
Na parte estatística, o texto cita três ferramentas. A análise de poder estima quantas amostras são necessárias a partir do efeito mínimo detectável, da variabilidade e dos níveis de significância e poder. O intervalo de confiança de 95% usa média ± 1,96 × erro padrão, com erros padrão agrupados quando as tarefas são correlacionadas (por exemplo, derivadas do mesmo código ou documento) e comparação pareada ao confrontar dois agentes. O reamostragem repete a execução do agente e a correção do juiz para estabilizar a estimativa por tarefa.
O que mudou
A cobertura anterior mostra o tema ganhando camadas. Em 5 de março de 2026, o CEVIU noticiou "Avaliações de IA no Mundo Real: Julgamento Humano, Juízes LLM e as Lacunas Existentes", sobre a insuficiência de testes convencionais para bots de atendimento. Em 15 de outubro de 2026, em "LangChain Detalha Metodologias para Avaliação Robusta de Agentes de IA", a discussão tratava de combinar avaliadores e olhar traces. Em 16 de outubro de 2026, o CEVIU abordou o custo humano e computacional dos fluxos com agentes. A matéria de agora acrescenta o rigor estatístico (poder, intervalos, reamostragem) e a meta-avaliação dos juízes, que nos textos anteriores não aparecem no material resumido.
Por que isso importa
Para quem opera pipelines de avaliação, a leitura é que nota de juiz LLM sem calibração e sem intervalo de confiança é opinião com casas decimais. Definir o tamanho do conjunto de testes antes de rodar e reportar incerteza junto do score tende a evitar decisões de release baseadas em ruído.
Linha do tempo
CEVIU noticia as limitações de testes convencionais e o papel de juízes LLM em bots de atendimento.
CEVIU cobre a metodologia da LangChain para avaliação de agentes de IA.
CEVIU aborda o custo humano e computacional na avaliação de fluxos com agentes.
Roteiro de três partes para avaliar agentes em tarefas subjetivas, com estatística para separar ruído de melhoria.
Perguntas frequentes
Por que avaliar tarefas subjetivas é mais difícil?
Não há como verificar a resposta de forma determinística, como em testes executáveis ou comparação de strings. É preciso usar humanos ou juízes LLM, e ambos divergem quando o critério é subjetivo. Isso soma ruído ao que já vem da não determinismo do agente.
Qual a diferença entre juiz LLM e rubrica?
O juiz LLM aplica critérios gerais e consistentes entre tarefas, como coerência numa escala de 1 a 5. A rubrica divide a qualidade em um checklist específico de cada tarefa, e cada item pode ser checado por um juiz. A rubrica permite verificar aspectos concretos em vez de só uma nota holística.
Como saber se um juiz LLM é confiável?
Faz-se meta-avaliação: monta-se um conjunto de ouro com exemplos avaliados por humanos e mede-se a concordância do juiz com eles, por correlação, acurácia ou métricas de confiabilidade entre avaliadores. Também dá para testar se as notas preveem métricas de produção, como abandono.
Para que servem análise de poder e intervalos de confiança?
A análise de poder estima quantas amostras são necessárias para detectar uma melhoria mínima. O intervalo de confiança mostra a incerteza do score e ajuda a separar ganho real de variação aleatória. Repetir execuções e correções reduz ainda mais a variância.
Fontes
- cameronrwolfe.substack.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU Dados