
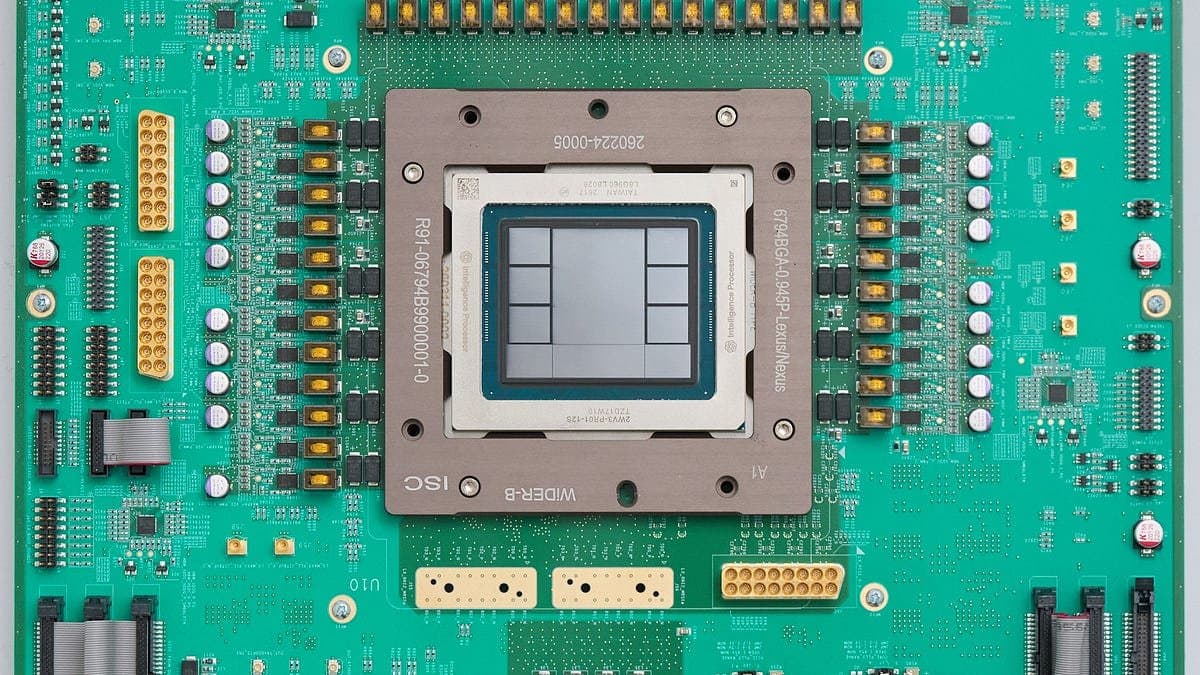
Por dentro do Jalapeño, o chip de inference da OpenAI
Aprofundamento CEVIU
Aprofundamento
A entrevista de Richard Ho, VP de Hardware da OpenAI, detalha a lógica do Jalapeño. O chip tem 64 núcleos dedicados, e cada um endereça diretamente o seu próprio banco de memória HBM. Para acessar memória de outro núcleo, é preciso passar por uma rede, mais lenta e com mais indireção. Em CPU e GPU o espaço de memória é compartilhado, com endereçamento único. Isso facilita a programação, mas exige muito hardware para gerenciar acesso e coerência. A OpenAI cortou esse overhead.
O custo está no software: o modelo de programação fica mais difícil, porque o desenvolvedor precisa cuidar do mapa de memória. Ho diz que a aposta foi que modelos de IA ficariam bons nessa tarefa, e ficaram. A otimização assistida por modelos de ML é usada para o layout e ajuda a manter a utilização alta. Segundo ele, os números de pico de flops, memória e rede são comparáveis aos de outros chips, e o ganho nos benchmarks vem da utilização. A fonte cita ainda os benchmarks SemiAnalysis InferenceX, com modelos como GPT-OSS, DeepSeek R1 e Kimi K2.5.
Outras escolhas: a OpenAI não desagregou prefill e decode, porque isso obriga a definir por anos quanto do parque vai para cada fase. Um dispositivo fungível melhora o uso da energia do data center. E optou por HBM (HBM4 nesta geração) em vez de SRAM, pois a SRAM tem capacidade limitada pelos nós de processo de TSMC, Samsung e Intel. Ho afirma que a segunda e a terceira geração estão em desenvolvimento e que a quarta já começou.
O que mudou
Em 25 de junho de 2026, o CEVIU noticiou "OpenAI revela primeiro chip com a Broadcom para construir a stack completa", com o Jalapeño apresentado como chip de inference. Em 26 de agosto de 2026, a cobertura trouxe os resultados iniciais, como em "OpenAI Otimiza Desempenho de IA com Chip Próprio Jalapeño". Em 1 de outubro de 2026, veio "OpenAI Desvenda 'Jalapeño': O Acelerador de IA Que Pode Mudar o Jogo", sobre arquitetura e design de sistema. Agora a entrevista acrescenta o porquê das decisões: memória particionada por núcleo, o tradeoff de programação e a escolha por hardware fungível.
Por que isso importa
Para quem escreve kernels ou otimiza serving de LLMs, a mensagem é que arquiteturas fora do modelo de memória compartilhada da GPU trocam conveniência por eficiência. Isso sugere que a camada de software e as ferramentas de otimização com IA passam a ser tão decisivas quanto o silício. É uma leitura editorial, não algo afirmado pela fonte.
Linha do tempo
CEVIU noticia o primeiro chip da OpenAI com a Broadcom, o Jalapeño, para inference.
OpenAI e Broadcom apresentam o Jalapeño como chip voltado a inferência de LLM.
Chegam os resultados iniciais do Jalapeño, com testes apontando ganho sobre sistemas comerciais.
Análises detalham arquitetura e design de sistema do Jalapeño.
Entrevista com Richard Ho explica HBM por núcleo, hardware fungível e otimização com IA.
Perguntas frequentes
O que diferencia o Jalapeño de uma GPU?
Cada um dos 64 núcleos acessa diretamente seu próprio banco de HBM, em vez de usar um espaço de memória compartilhado. Isso elimina boa parte do hardware de coerência e reduz a movimentação de dados. Em troca, o gerenciamento de memória fica mais complexo.
Por que a OpenAI não separou prefill e decode em hardwares diferentes?
Segundo Richard Ho, a desagregação exige decidir com anos de antecedência quanto do parque vai para cada fase. Um dispositivo fungível melhora o uso do data center e da energia disponível. A arquitetura de memória do chip permite essa flexibilidade.
Por que HBM e não SRAM?
A SRAM entrega muita banda, mas tem capacidade limitada pelos processos de TSMC, Samsung e Intel. Os modelos da OpenAI são grandes e pedem capacidade. A HBM supera esse limite mantendo banda alta.
Como a IA entrou no desenvolvimento do chip?
A OpenAI apostou que modelos de IA ficariam bons em lidar com o mapeamento de memória, o que manteve o modelo de programação viável. Ho diz que o layout do software usa modelos de ML para manter a utilização alta.
Fontes
- taekim.substack.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU Web Dev