
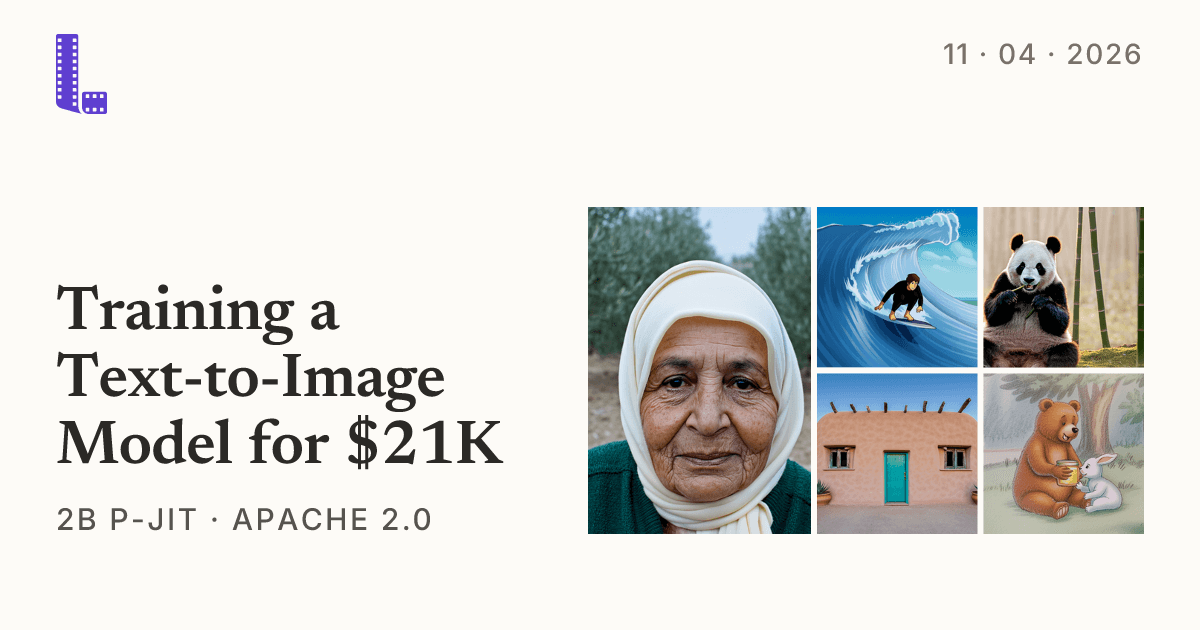
Linum detalha treino de modelo text-to-image por US$ 21 mil com arquitetura Pyramid-JiT
Aprofundamento CEVIU
Aprofundamento
A Linum é um laboratório de duas pessoas que treina modelos generativos de vídeo do zero. Segundo o relato, o gargalo de treino e inferência em vídeo é a atenção, O(n²), então comprimir mais reduz a janela de contexto e o custo. O Pyramid-JiT (P-JiT) trabalha em espaço de pixels, sem VAE. Com redução de tokens de 32×32 (contra 16×16 do Linum v2, que usa Wan VAE + DiT), a janela de atenção cai 4×. A Linum diz que o P-JiT converge em 11× menos amostras que o v2.
Nesta rodada, o modelo foi treinado por 660M de amostras, por apenas US$ 21 mil em computação, bem acima das 50 a 100M dos testes iniciais. É um teste de estresse a caminho de modelos maiores e de vídeo, já que modelos de vídeo costumam nascer como modelos de imagem. São 2B de parâmetros no DiT, com 22 blocos idênticos após dois blocos refiner por modalidade, e um codificador de texto Qwen3.5-4B congelado. Há readouts no tronco (blocos 10 e 16, prevendo a imagem em um quarto e metade da resolução) e um readout PixelREPA no bloco 5, alinhado ao DINOv3-L. O treino começa em 512² e passa para 1024², com RoPE interpolado. O pós-treino usou uma variante de FDFO.
As limitações são declaradas: o modelo não gera texto legível nem pôsteres, porque dados com texto renderizado foram filtrados. Também falha em corpo inteiro, muitas entidades, interação entre pessoas e conhecimento de mundo. Trata-se de lançamento de pesquisa, sob Apache 2.0, e não de produto.
Por que isso importa
Para quem opera treino de modelos generativos com orçamento curto, o número de US$ 21 mil sugere que dá para validar uma arquitetura em escala relevante sem um cluster grande. Fica a ressalva de que é um resultado do próprio laboratório, em imagem, e ainda não prova o ganho em vídeo.
Perguntas frequentes
O que é o Pyramid-JiT (P-JiT)?
É uma arquitetura de difusão em espaço de pixels, sem VAE. Ela usa redução de tokens de 32×32, o que corta a janela de atenção em 4× frente ao Linum v2. Um noise schedule específico ajuda o modelo a aprender detalhes finos.
Quanto custou o treino e qual o tamanho do modelo?
Foram US$ 21 mil em computação para 660M de amostras. O modelo tem 2B de parâmetros no DiT e usa um codificador de texto de 4B.
O modelo gera texto em imagens?
Não. Os dados com texto renderizado foram filtrados, então ele não escreve texto nem faz pôsteres. A Linum diz que esse tipo de dado não serve ao objetivo de ferramentas de animação.
Isso já é um modelo de vídeo?
Não. É um modelo text-to-image, lançado como pesquisa experimental sob Apache 2.0. Serve de passo intermediário rumo a modelos maiores e de vídeo.
Fontes
- linum.aifonte original
- Categoria
- CEVIU IA
- Publicado
- 04 de novembro de 2026
- Editoria
- CEVIU IA