
Priming Revoluciona IA: Como Alterar Arquiteturas sem Retreinar do Zero
Aprofundamento CEVIU
Aprofundamento
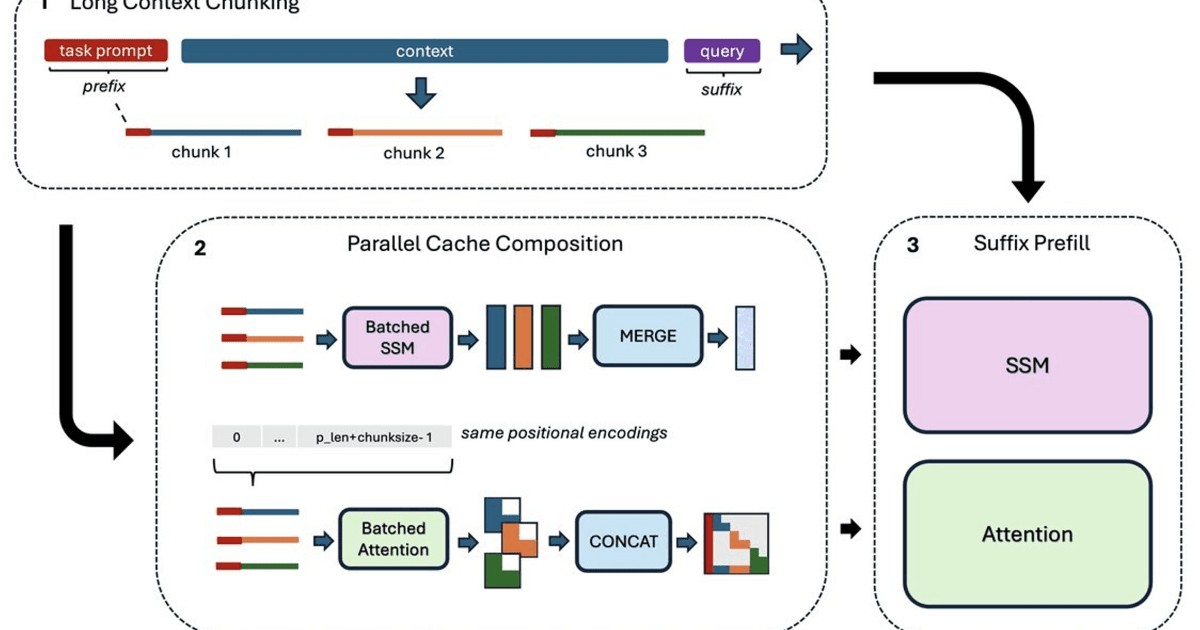
A técnica de Priming representa um salto significativo na criação de modelos de IA, especialmente para Transformers. Em vez de treinar uma arquitetura do zero, o Priming permite a reutilização de pesos de Transformers pré-treinados para inicializar modelos híbridos, que combinam as camadas de atenção tradicionais com State Space Models (SSMs). Essa abordagem inovadora possibilita a exploração de um vasto espaço de design de arquiteturas de forma econômica, com um custo de treinamento que pode ser inferior a 1% do custo original e um throughput até duas vezes maior.
O segredo do Priming reside na similaridade estrutural entre as camadas de atenção de um Transformer e os SSMs. Ambas podem ser expressas como o resultado da multiplicação de uma sequência de valores por uma matriz de 'mixagem'. Aproveitando essa equivalência, o Priming transfere o conhecimento dos pesos pré-treinados do Transformer para as novas camadas de SSM, exigindo apenas um treinamento mínimo para alinhamento e adaptação final. Isso abre portas para otimizar modelos em termos de memória, velocidade e qualidade, sem o gargalo do pré-treinamento massivo.
O que mudou
A cobertura anterior do CEVIU News já apontava para a busca por eficiência e novas arquiteturas. Artigos como "Transformers em Loop" (29 de julho de 2026) e "A Próxima Geração de LMs: Transformers Recorrentes" (10 de setembro de 2026) exploravam a reutilização de camadas para otimizar recursos. O Priming leva essa ideia a um novo patamar: em vez de apenas reutilizar ou ciclar camadas, ele permite *substituir* e *transformar* arquiteturas, criando modelos híbridos. Isso resolve o problema de alto custo para comparar diferentes designs, que era uma barreira. O artigo "Novo Transformer Otimiza Geração de Tokens com Estado Interno Contínuo" (1 de outubro de 2026), que apresentou o LIFT, já indicava a relevância de realimentar o estado interno, conceito central nos State Space Models que o Priming integra aos Transformers.
Por que isso importa
O Priming democratiza a inovação em arquiteturas de IA. O custo proibitivo de treinar novos modelos do zero, com trilhões de tokens e milhares de horas de GPU, limitava a experimentação. Agora, pesquisadores e desenvolvedores podem testar novas combinações de camadas de atenção e State Space Models (SSMs) de forma rápida e barata. Isso é crucial para superar o 'imposto de memória' dos Transformers, que escala com o número de tokens processados. Com o Priming, é possível criar modelos que raciocinam mais rápido e consomem menos recursos, tornando a IA avançada mais acessível e eficiente para um leque maior de aplicações.
Linha do tempo
PorTAL: arquitetura permite portar fine-tuning entre diferentes LLMs
LLMs Mais Leves: Sparse Training Promete Democratizar a IA
Transformers em Loop: Uma Revolução na Eficiência de Modelos de IA
Meta desvenda sinergias multimodais em pré-treinamento de IA
A Próxima Geração de LMs: Transformers Recorrentes e o Raciocínio Oculto em Destaque
Novo Transformer Otimiza Geração de Tokens com Estado Interno Contínuo
Priming Revoluciona IA: Como Alterar Arquiteturas sem Retreinar do Zero
Perguntas frequentes
O que é Priming na IA?
Priming é uma técnica que permite criar modelos de IA com arquiteturas mais eficientes, reutilizando pesos de Transformers pré-treinados. Essa abordagem reduz significativamente o custo e o tempo de treinamento, ao mesmo tempo em que melhora o desempenho dos modelos.
Como o Priming reduz o custo de treinamento?
Ele aproveita o conhecimento já contido nos pesos de um Transformer pré-treinado para inicializar camadas de arquiteturas híbridas. Isso evita o treinamento exaustivo do zero, resultando em um custo inferior a 1% do treinamento original e exigindo apenas um breve período de adaptação.
Quais são as vantagens das arquiteturas híbridas otimizadas pelo Priming?
As arquiteturas híbridas combinam camadas de atenção (memória eidética) com State Space Models (SSMs, memória de esvanecimento) para um equilíbrio superior entre memória, velocidade e qualidade. Elas podem dobrar o throughput e reduzir o consumo de memória, especialmente em contextos longos, oferecendo raciocínio mais rápido.
Quais tipos de modelos se beneficiam do Priming?
O Priming é aplicável a diversas famílias de Transformers (Qwen, Llama, Mistral), classes de modelos (densos ou MoE) e diferentes escalas (de oito bilhões a 32 bilhões de parâmetros). Ele não está atrelado a uma arquitetura ou classe específica, o que amplia sua utilidade para otimização de IA.
Fontes
- amazon.sciencefonte original
- Categoria
- CEVIU IA
- Publicado
- 13 de outubro de 2026
- Editoria
- CEVIU IA