
Amazon Web Services inova com método de "priming" para reduzir custos de pré-treinamento em IA
Aprofundamento CEVIU
Aprofundamento
A técnica de "priming" da AWS representa um avanço significativo para gestores de TI e arquitetos de sistemas que buscam otimizar o uso de modelos de IA. Historicamente, a arquitetura Transformer, onipresente em LLMs, impõe um custo de memória que cresce exponencialmente com o contexto de processamento. Isso torna a experimentação com novas arquiteturas, como os modelos híbridos de estado-espaço (SSMs), proibitivamente cara, exigindo pré-treinamento do zero com trilhões de tokens e centenas de milhares de horas de GPU.
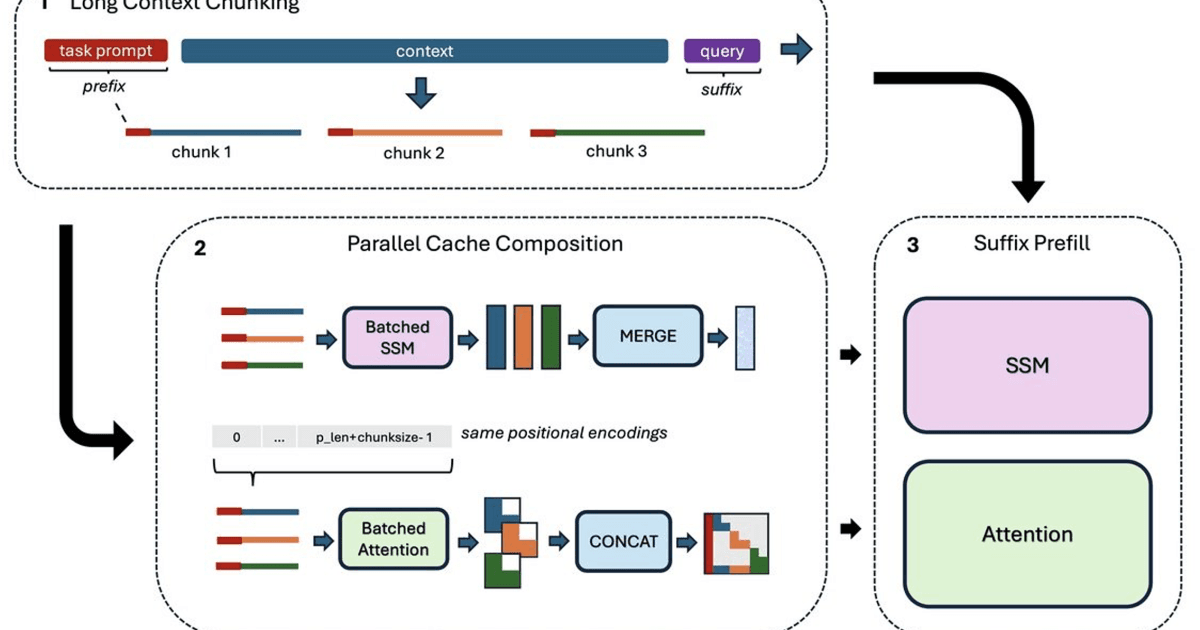
O "priming" resolve essa barreira ao reutilizar pesos de Transformers pré-treinados, substituindo seletivamente camadas de atenção por Gated KalmaNets (GKAs) mais eficientes em termos de memória. Isso permite construir modelos híbridos que mantêm o desempenho de raciocínio, decodificam mais rápido e, crucialmente, reduzem o custo de pré-treinamento em mais de 99%. A iniciativa se alinha com a tendência de buscar LLMs mais leves, conforme noticiamos em julho de 2026, democratizando o acesso a arquiteturas avançadas de IA e impulsionando a pesquisa com a disponibilização de código e modelos sob licença Apache 2.0.
O que mudou
O que era uma promessa de mudança de paradigma, conforme abordamos em "Priming Revoluciona IA: Como Alterar Arquiteturas sem Retreinar do Zero" (13 de outubro de 2026), agora ganha detalhes técnicos concretos e validação robusta. A notícia atual vai além do conceito, apresentando resultados tangíveis: uma redução de mais de 99% nos custos de pré-treinamento e uma decodificação até duas vezes mais rápida.
A AWS detalha a implementação com a substituição de camadas de atenção por Gated KalmaNets e disponibiliza os artefatos (modelos, código, plugin vLLM) para a comunidade. Isso transforma uma inovação teórica em uma ferramenta prática, pronta para ser explorada e adotada por desenvolvedores e empresas que visam a eficiência e agilidade no desenvolvimento de IA.
Por que isso importa
A adoção do "priming" é estratégica para empresas que precisam escalar suas operações de IA sem comprometer o orçamento. Reduzir em mais de 99% os custos de pré-treinamento significa que a inovação e a personalização de modelos de IA, antes restritas a grandes orçamentos, tornam-se acessíveis. Isso abre caminho para testar e implementar arquiteturas de IA mais eficazes, adaptadas a necessidades específicas de negócio.
Além da economia, a aceleração na decodificação e a otimização de memória dos modelos híbridos se traduzem em maior produtividade e menor latência para aplicações críticas. Para líderes de TI, esta técnica não só diminui o Custo Total de Propriedade (TCO) das soluções de IA, mas também oferece agilidade para explorar o design de modelos, garantindo uma vantagem competitiva no cenário da transformação digital.
Linha do tempo
CEVIU News publica sobre a estratégia da AWS em otimização de custos e eficiência em IA.
CEVIU News publica sobre a busca por LLMs mais leves através de Sparse Training.
CEVIU News publica sobre as sinergias multimodais em pré-treinamento de IA na Meta.
AWS anuncia pré-filtragem por metadados para otimizar buscas no Amazon S3 Vectors.
Amazon introduz o Strands Decider 2B, um modelo de IA compacto para agentes autônomos.
CEVIU News publica sobre o conceito de "priming" para alterar arquiteturas de IA sem retreinar.
Amazon Web Services detalha a técnica de "priming" para reduzir custos de pré-treinamento em IA.
Perguntas frequentes
O que é a técnica de "priming" da AWS?
É uma abordagem inovadora que permite reutilizar pesos de modelos Transformer pré-treinados para construir novas arquiteturas híbridas, como as de estado-espaço. O método reduz significativamente (mais de 99%) os custos de pré-treinamento e acelera o desempenho sem perder a capacidade de raciocínio.
Como o "priming" consegue reduzir os custos de pré-treinamento?
Ele evita a necessidade de treinar novas arquiteturas do zero. Ao transferir o conhecimento de modelos Transformer existentes e substituir camadas de atenção por Gated KalmaNets, que são mais eficientes, o processo se torna muito menos intensivo em termos de computação e tempo.
Quais são os principais benefícios de desempenho dos modelos híbridos criados com "priming"?
Estes modelos mantêm o desempenho de raciocínio dos Transformers originais, mas decodificam até duas vezes mais rápido. Além disso, a otimização de memória, especialmente com Gated KalmaNets, permite um uso mais eficiente de recursos e maior throughput em inferência.
O que são Gated KalmaNets (GKAs) e por que são importantes para o "priming"?
GKAs são um tipo de modelo de estado-espaço (SSM) que substitui as camadas de atenção dos Transformers, otimizando a memória. Eles são cruciais porque permitem que os modelos híbridos processem informações de forma mais compacta e eficiente, contribuindo para a redução de custos e aumento de velocidade do "priming".
Fontes
- amazon.sciencefonte original
- Categoria
- CEVIU TI
- Publicado
- 14 de outubro de 2026
- Editoria
- CEVIU TI