
Together Compiler propõe compilação contínua para otimizar inference
Aprofundamento CEVIU
Aprofundamento
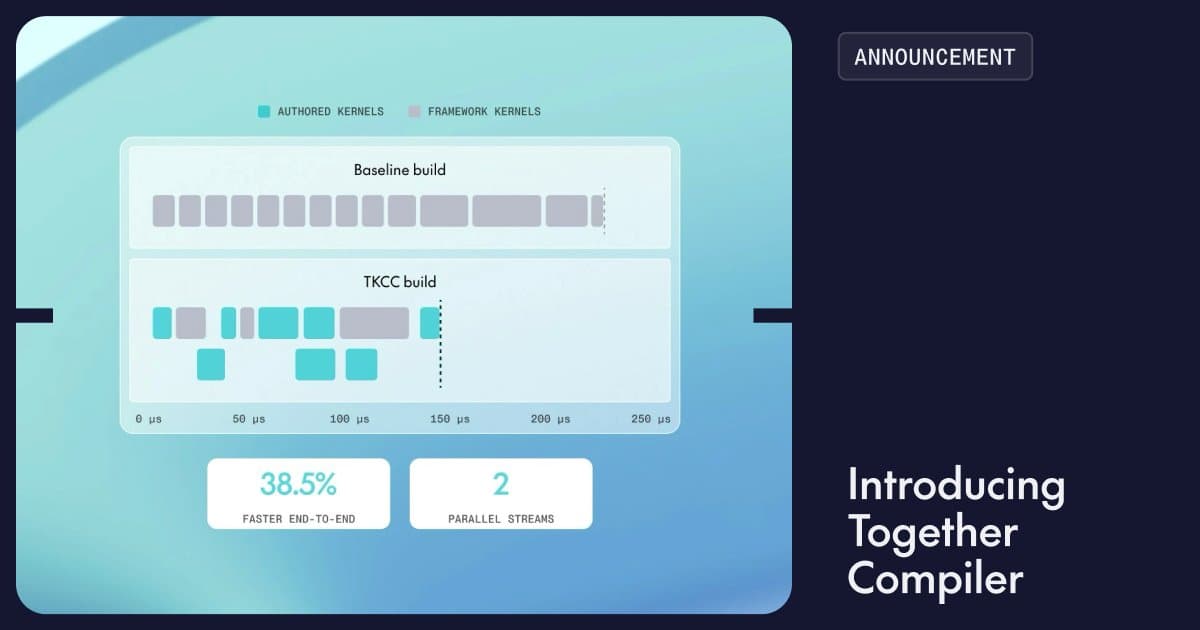
A Together AI apresentou o Together Compiler (TKCC), um loop de otimização contínuo para inference. Ele recebe três entradas: o formato do tráfego, o modelo e o hardware. Com isso, agentes geram uma série de otimizações para o motor de inference. A premissa da empresa é que otimizar na mão cada combinação de modelo, GPU e perfil de cliente não escala mais. Segundo o blog, nenhum dos dez maiores LLMs open-source no OpenRouter usa a mesma arquitetura, e o hardware vai de H100 e B200 a B300, NVL72, VR e Groq.
O diferencial técnico está em três pontos. Primeiro, "engines persistentes": o motor sobe uma vez e recarrega qualquer forward pass candidato sem reiniciar, já que o start de VLLM, SGLang ou TRT-LLM leva dezenas de minutos. Segundo, uma camada de engines rápidas (poucas camadas, iteração veloz) e lentas (muitas camadas, dados reais) para equilibrar vazão e fidelidade de medição. Terceiro, um cost model que combina specs de hardware, microbenchmarks e forward passes medidos para escolher paralelismo (TP, EP, DCP). Os números citados: até 2,6x mais TPS, 1111 TPS no MiniMax M3.1-Flash e 1205 TPS no DeepSeek v4.1-Flash em batch size 1, 1,7x sobre megakernels open-source no Llama 1B, e 252x mais throughput de experimentos que sistemas agênticos de referência. Todos são resultados reportados pela própria Together, que diz já servir trilhões de tokens com o compilador.
O que mudou
A cobertura anterior mostra uma tendência de agentes otimizando inference, mas de outros atores. Em 29 de outubro de 2026, o CEVIU noticiou "Decagon constrói inference stack que se otimiza sozinho com agentes AutoResearch", com ganhos de até 2,5x em throughput a partir de replays de tráfego de produção. Em 27 de maio de 2026, saiu "Extraia Mais Desempenho de Kernel com o Auto-Tuning do NVIDIA CompileIQ", sobre auto-tuning de compilador de GPU com algoritmos evolucionários. São casos distintos do TKCC, não versões anteriores dele. A comparação é de abordagem: a Together reivindica um loop contínuo com engines persistentes e foco em escala de experimentos.
Por que isso importa
Para quem opera inference em produção, a leitura é que o ajuste fino por workload deixa de ser trabalho manual e vira processo contínuo. Os números vêm do blog do fornecedor, então vale reproduzir no seu tráfego antes de tomar como regra. O dado sobre contexto (prompts 80% maiores duas semanas após um lançamento de modelo) sugere que configurações estáticas envelhecem rápido.
Linha do tempo
CEVIU noticia agentes de IA do LinkedIn para acelerar experimentação de modelos e infraestrutura.
NVIDIA apresenta o CompileIQ, com auto-tuning de compilador de GPU no CUDA 13.3.
Decagon descreve inference stack que se otimiza com agentes AutoResearch.
Together AI apresenta o Together Compiler, loop contínuo de compilação para inference.
Perguntas frequentes
O que é o Together Compiler (TKCC)?
É um loop de otimização contínuo da Together AI que usa agentes de alto throughput para otimizar inference. Ele parte do formato do tráfego, do modelo e do hardware. A partir disso, gera otimizações para o motor de inference.
Quais ganhos de desempenho a Together reporta?
Até 2,6x mais TPS em modelos open-source de ponta, em menos de 24 horas. Também cita 1111 TPS no MiniMax M3.1-Flash e 1205 TPS no DeepSeek v4.1-Flash, e 1,7x sobre megakernels open-source no Llama 1B com batch size 1. São números da própria empresa.
O que são engines persistentes?
São motores de inference que sobem uma única vez e recarregam qualquer forward pass candidato sem reiniciar. Isso evita as dezenas de minutos de startup de motores como VLLM, SGLang ou TRT-LLM. Assim, as GPUs ficam menos ociosas durante os experimentos dos agentes.
O TKCC serve só para LLMs?
Não. A Together diz que usa o compilador como otimizador de IA de propósito geral e mostra ganhos em bases de código de modelagem do clima, PDE, séries temporais e biologia. A comparação foi feita contra o Claude Code com o comando /goal.
Fontes
- together.aifonte original
- Categoria
- CEVIU IA
- Publicado
- 05 de novembro de 2026
- Editoria
- CEVIU IA