
DeepInfer e DeepSeek V4.1 Flash: Eficiência e Escala em Inference de IA
Aprofundamento CEVIU
Aprofundamento
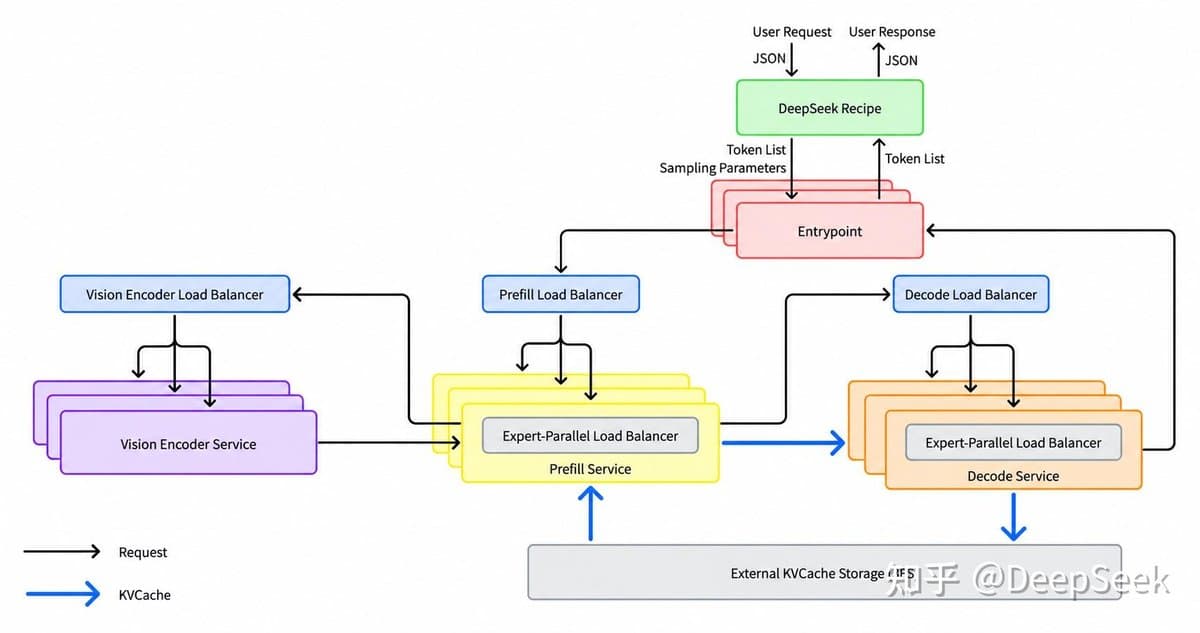
O DeepInfer, novo framework da DeepSeek, detalha como a empresa otimiza a inferência de IA em larga escala. Ele integra tecnologias avançadas como inferência distribuída, caching inteligente, balanceamento de carga e decodificação especulativa. A infraestrutura permite ao DeepSeek V4.1 Flash alcançar um throughput impressionante de 155 trilhões de tokens por dia por cluster, gerando uma receita de US$38 por hora de GPU, e a DeepSeek compartilha grande parte desse sistema como código aberto.
A busca por alto throughput e baixa latência impulsiona as otimizações do DeepInfer. Isso inclui o uso de paralelismo de especialistas (MoE), a separação de recursos para Prefill, Decode e Vision Encoder, e paralelismo de dados. Balançadores de carga específicos para cada etapa (Prefill, Decode, Vision Encoder, Expert-Parallel) garantem que a distribuição do trabalho entre as GPUs seja equilibrada, maximizando a eficiência. O gerenciamento de KVCache é crucial, com o Block KVCache para persistência de longo prazo (até 7 dias) e o SWA KVCache para reuso de curta duração em memória. O DeepSeek Recipe, um componente open-source, gerencia a codificação e decodificação de tokens de forma eficiente, lidando com contextos longos e tokens especiais sem latência.
O que mudou
A DeepSeek vem aprimorando consistentemente suas técnicas de inferência, e o lançamento do DeepInfer mostra essa evolução. A cobertura anterior do CEVIU em 17 de setembro de 2026, com o artigo "DeepSeek-V4.1 Flash Reduz KV Cache e Otimiza Custos em Agentes de IA", já indicava a compressão do KV cache como foco. Agora, o DeepInfer apresenta o SWA Bounded Replay, uma melhoria do V4 para o V4.1 que elimina a persistência do SWA KVCache. Em vez de armazenar, o sistema recomputa os últimos 128 tokens, reduzindo o custo de armazenamento que havia sido uma limitação da abordagem Zero SWA Caching no V4.
Outra inovação é o DSpark, que aprimora a decodificação especulativa. Já tínhamos menção a essa técnica no artigo "DFlash 2 revoluciona inferência de LLMs com decodificação especulativa aprimorada", de 20 de agosto de 2026. No DeepInfer, o DSpark introduz a validação de tamanho variável com base na probabilidade de aceitação de cada token, otimizando a alocação de recursos e aumentando o throughput em 6%, um avanço significativo na eficiência da inferência de Large Language Models (LLMs).
Por que isso importa
O DeepInfer, ao detalhar e abrir grande parte da infraestrutura por trás do DeepSeek V4.1 Flash, estabelece um novo patamar para a eficiência e a escalabilidade da inferência de IA. Isso demonstra que modelos de IA de ponta podem ser operados com alto desempenho e sustentabilidade econômica, democratizando o acesso a avanços técnicos e impulsionando a inovação em todo o ecossistema de LLMs.
Com um throughput de 155 trilhões de tokens por dia por cluster e uma receita de US$38 por hora de GPU, a DeepSeek mostra que é possível aliar inteligência avançada a uma operação economicamente viável. As otimizações no gerenciamento de KVCache, decodificação especulativa e balanceamento de carga são essenciais para tornar modelos de IA mais complexos e agentes autônomos acessíveis e eficientes para diversas aplicações práticas, impactando diretamente o custo total de propriedade da IA.
Linha do tempo
DeepSeek V4-Flash redefine custo-benefício em modelos de IA, sendo o mais econômico do mercado.
DFlash 2 revoluciona inferência de LLMs com decodificação especulativa aprimorada.
DeepSeek-V4.1-Flash: A nova geração de IA da DeepSeek para desempenho e economia.
DeepSeek-V4.1 Flash Reduz KV Cache e Otimiza Custos em Agentes de IA.
DeepInfer e DeepSeek V4.1 Flash: Eficiência e Escala em Inference de IA.
Perguntas frequentes
O que é DeepInfer e qual sua função principal?
DeepInfer é um framework de inferência em nuvem desenvolvido pela DeepSeek para otimizar a execução de seu modelo DeepSeek V4.1 Flash. Sua função principal é habilitar a inferência de IA em larga escala com alta eficiência, utilizando inferência distribuída, caching inteligente e balanceamento de carga.
Quais técnicas o DeepInfer usa para atingir alta eficiência?
O DeepInfer emprega uma combinação de técnicas como paralelismo de especialistas (MoE), Data Parallelism, separação de estágios Prefill/Decode/Vision Encoder e balançadores de carga. Além disso, utiliza um gerenciamento de KVCache otimizado (Block KVCache e SWA Bounded Replay) e a decodificação especulativa DSpark para acelerar o processamento.
Como o DeepSeek V4.1 Flash se destaca economicamente e em desempenho?
O DeepSeek V4.1 Flash, impulsionado pelo DeepInfer, alcança um throughput de 155 trilhões de tokens por dia por cluster, com uma receita de US$38 por hora de GPU. Essa eficiência e rentabilidade resultam da arquitetura otimizada, gerenciamento inteligente de recursos e da disponibilidade do framework DeepInfer como código aberto.
O que é o SWA Bounded Replay e como ele melhorou o gerenciamento de KVCache?
SWA Bounded Replay é uma otimização no gerenciamento de KVCache introduzida no DeepSeek V4.1 Flash. Diferente do V4, que buscava persistência, o V4.1 recomputa os últimos 128 tokens do SWA KVCache apenas quando necessário, reduzindo significativamente a necessidade de armazenamento persistente e os custos associados.
Fontes
- zhuanlan.zhihu.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 21 de outubro de 2026
- Editoria
- CEVIU IA