
DeepSeek-V4.1 Flash Reduz KV Cache e Otimiza Custos em Agentes de IA
Aprofundamento CEVIU
Aprofundamento
A busca por eficiência em modelos de linguagem de grande escala (LLMs) tem no KV cache (Key-Value cache) um de seus maiores desafios. Em cenários com agentes de IA de longo horizonte, onde o contexto da conversa se estende por milhares ou milhões de tokens, o KV cache pode inflar o consumo de memória, principalmente na HBM e SSD, impactando diretamente os custos de infraestrutura e a capacidade de escalabilidade.
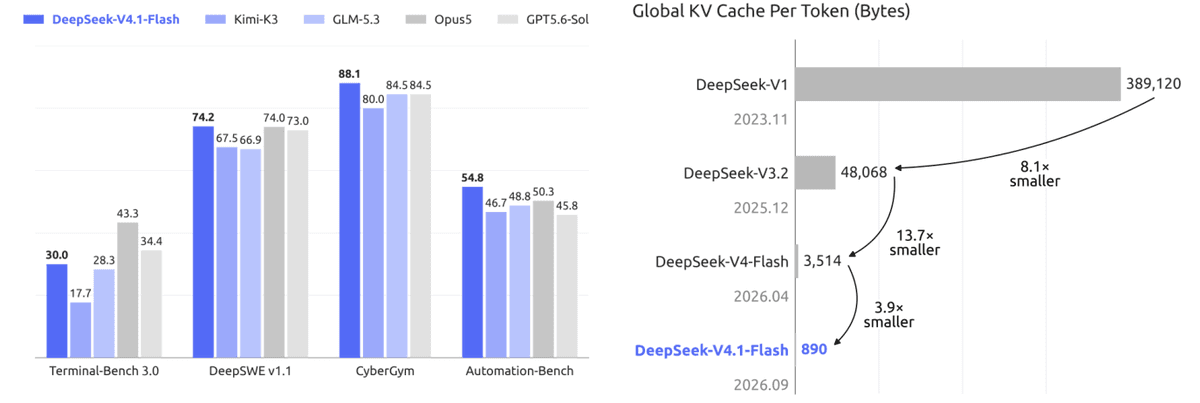
O DeepSeek-V4.1 Flash aborda essa questão de forma agressiva. Ele usa uma arquitetura Causal Encoder-Decoder (CED), onde apenas 8 bilhões de parâmetros são ativados durante o prefill e 16 bilhões durante o decoding. Isso contrasta com abordagens tradicionais que ativam um número muito maior de parâmetros em ambas as fases. A compressão do KV cache é o ponto central: com técnicas como atenção esparsa entre camadas (CSA2), reuso de índice, memória Engram e armazenamento FP4, o modelo consegue reduzir o footprint do KV cache para impressionantes 890 bytes por token. Essa otimização é vital para desenvolvedores, pois permite gerenciar contextos extensos sem comprometer a performance ou explodir o orçamento de infraestrutura, um problema que o CEVIU já discutia em artigos como "Latent Briefing: Compartilhamento Eficiente de Memória para Sistemas Multiagentes via KV Cache Compaction", de 13 de abril de 2026.
O que mudou
O DeepSeek-V4.1 Flash representa uma evolução arquitetural significativa em relação à versão anterior, DeepSeek-V4 Flash, que o CEVIU noticiou em 3 de agosto de 2026 como "DeepSeek Lança V4 Flash com Desempenho Superior para Agentes de IA". Enquanto o V4 Flash já se destacava pelo desempenho e custo-benefício, como abordado em "DeepSeek V4-Flash redefine custo-benefício em modelos de IA", de 4 de agosto de 2026, o V4.1 Flash vai além.
A principal mudança está na compressão extrema do KV cache. O DeepSeek-V4.1 Flash atinge uma redução de aproximadamente quatro vezes no armazenamento de KV cache em tempo de execução e oito vezes no cache persistente, comparado ao V4-Flash, mantendo a qualidade da tarefa. Além disso, a nova versão introduz suporte nativo a entrada multimodal e contextos de até um milhão de tokens, expandindo as possibilidades de aplicação. Essa não é apenas uma iteração pós-treinamento, mas uma reformulação arquitetural profunda, que alguns chegam a considerar o "DeepSeek-V5 Flash", conforme o artigo-fonte destaca.
Por que isso importa
Para a comunidade de desenvolvimento, as otimizações do DeepSeek-V4.1 Flash são um marco. Agentes de IA de longo horizonte se tornaram uma carga de trabalho crítica, e a capacidade de processar contextos vastos de forma econômica e eficiente sempre foi um gargalo. A compressão do KV cache e as otimizações de cálculo de prefill significam menos consumo de HBM, SSD e recursos computacionais. Isso se traduz diretamente em modelos mais acessíveis de operar e escalar.
A possibilidade de lidar com 1 milhão de tokens e entradas multimodais abre portas para novas aplicações em automação, análise de dados e interfaces conversacionais complexas. Desenvolvedores agora podem criar sistemas de IA com memória de longo prazo mais robusta, sem se preocupar excessivamente com os custos de infraestrutura, impulsionando a inovação em diversas frentes.
Linha do tempo
CEVIU publica Latent Briefing sobre KV Cache Compaction para sistemas multiagentes.
CEVIU aborda estratégia de caching de prompts para otimizar custos em agentes de IA.
DeepSeek lança a versão de produção do seu modelo V4 Flash, focado em agentes de IA.
CEVIU noticia que DeepSeek V4-Flash redefine o custo-benefício em modelos de IA.
CEVIU publica artigo sobre desafios na gestão de memória de modelos de IA e o KV cache.
DeepSeek AI anuncia o DeepSeek-V4.1-Flash, destacando desempenho e economia.
DeepSeek-V4.1 Flash revela inovações na compressão do KV cache para otimizar custos.
Perguntas frequentes
O que é KV cache em modelos de IA e por que ele é um problema?
O KV cache armazena os resultados intermediários (chaves e valores) das camadas de atenção dos modelos de IA, evitando recomputações. Ele é um problema porque, em contextos longos, consome muita memória, como HBM e SSD, aumentando os custos de infraestrutura e limitando a escalabilidade, um tema recorrente na cobertura do CEVIU.
Qual a principal inovação do DeepSeek-V4.1 Flash?
A principal inovação é a extrema compressão do KV cache, reduzindo seu tamanho para apenas 890 bytes por token. Isso é alcançado por meio de uma arquitetura Causal Encoder-Decoder (CED), atenção esparsa entre camadas (CSA2), memória Engram e armazenamento FP4, tornando a inferência de agentes de IA muito mais eficiente.
Como o DeepSeek-V4.1 Flash otimiza custos para desenvolvedores?
Ele otimiza custos de diversas maneiras. A compressão agressiva do KV cache reduz o uso de HBM e SSD. A otimização do cálculo de prefill, ativando menos parâmetros (8 bilhões no prefill e 16 bilhões no decoding), diminui a demanda computacional, resultando em menor gasto com hardware e operações.
O DeepSeek-V4.1 Flash suporta entrada multimodal?
Sim, o DeepSeek-V4.1 Flash suporta nativamente entrada multimodal, permitindo que o modelo processe e compreenda informações de diferentes tipos, como texto e imagem. Isso expande as capacidades para construir agentes de IA que interagem com o mundo de forma mais rica e complexa.
Fontes
- zartbot.github.iofonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 17 de setembro de 2026
- Editoria
- CEVIU Web Dev