
NVIDIA apresenta o VFlash, modelo de visão que gera previsões geométricas em paralelo
Aprofundamento CEVIU
Aprofundamento
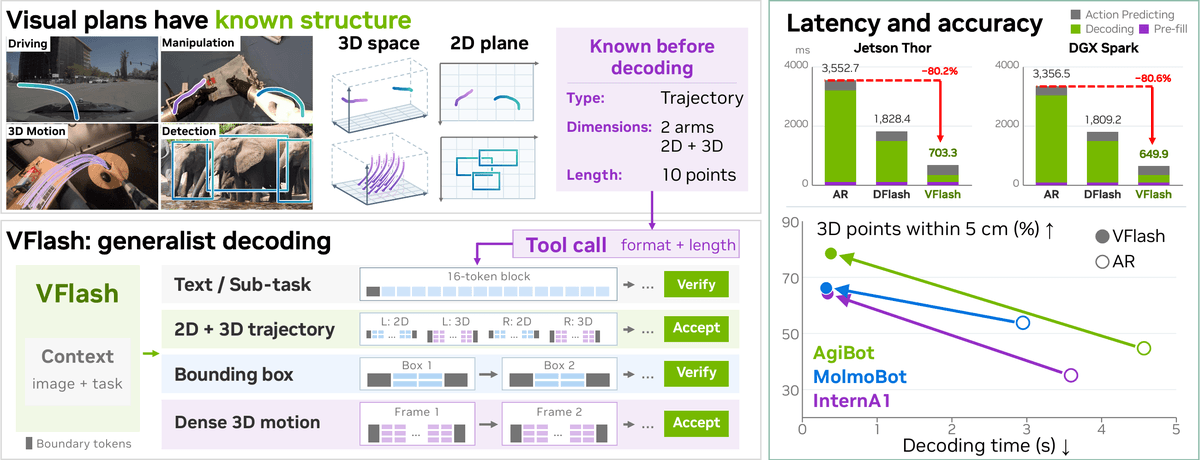
O VFlash é um framework de decodificação para IA física que adapta o speculative decoding de VLMs. A ideia central: a estrutura geométrica conhecida das primitivas visuais (pontos, caixas, trajetórias 2D/3D) permite obter precisão espacial sem reproduzir os tokens exatos do alvo autoregressivo. Um drafter leve, com cinco camadas transformer não causais, treinado com cross-entropy sobre geometria anotada, gera a primitiva completa em um único passe paralelo. O VLM alvo fica congelado.
Os números da fonte: erro médio de deslocamento 3D (ADE) 42,6% menor que o alvo AR em três datasets de robótica. No forecasting de movimento 3D denso com MolmoMotion-AR congelado, o erro cai 27% no DAVIS e a geração fica cerca de 25× mais rápida em H100 com batch size um. Em COCO e Dense200, são 2,6 a 2,8× mais caixas por segundo, com F1 médio próximo ao do alvo. Em controle, um world action model baseado no Cosmos-Predict2.5 chega a 70,2% de sucesso médio, contra 62,6% do baseline e 61,0% com planos AR 2D+3D.
Na latência, medida com TensorRT-Edge-LLM customizado em Jetson Thor, DGX Spark e H100 (batch size um), a decodificação AR responde por 75 a 87% do tempo do estágio de modelo no Thor. O VFlash reduz essa etapa em 12 a 42×, com inferência de robô 5× mais rápida e mais de 3× no NAVSIM. Um exemplo citado: decodificação de 3.107,6 ms para 258,2 ms. Trata-se de pesquisa publicada, não de produto disponível.
O que mudou
A cobertura anterior mostra a mesma linha de pesquisa da NVIDIA em decodificação paralela. Em 28 de maio de 2026, o CEVIU noticiou "NVIDIA Apresenta LocateAnything para Grounding Mais Rápido", framework que decodifica bounding boxes em paralelo, em vez de token a token. O VFlash estende a lógica de caixas para trajetórias 2D/3D, movimento denso e comprimentos variáveis, e mira o ganho em robótica e direção autônoma, com medição em hardware embarcado.
Por que isso importa
Para quem opera agentes físicos com VLMs, o gargalo costuma ser a geração serial de coordenadas. Se os resultados se sustentarem fora do benchmark da própria equipe, a leitura é que dá para replanejar com mais frequência no mesmo hardware embarcado e ainda ganhar precisão. Vale checar o custo de treinar o drafter por tarefa e a dependência de layout fixo de coordenadas.
Linha do tempo
NVIDIA apresenta o LocateAnything, grounding com bounding boxes decodificadas em paralelo.
NVIDIA apresenta o VFlash, decodificação paralela de primitivas geométricas para IA física.
Perguntas frequentes
O que é o VFlash da NVIDIA?
É um framework de decodificação para IA física que gera primitivas visuais completas, como caixas e trajetórias, em paralelo. Usa um drafter leve sobre um VLM alvo congelado. A fonte descreve o trabalho como pesquisa.
Quão mais rápido ele é que a decodificação autoregressiva?
A NVIDIA reporta redução de 12 a 42× no estágio de decodificação no Jetson Thor. Isso resulta em inferência de robô 5× mais rápida e mais de 3× no NAVSIM. As medições usam batch size um.
O VFlash perde precisão por gerar em paralelo?
Segundo a fonte, não nas trajetórias: o erro ADE 3D cai 42,6% em relação ao alvo AR em três datasets de robôs. Em detecção de caixas, o F1 médio fica próximo ao do alvo. O texto de sub-tarefas segue verificado pelo VLM alvo.
Em que hardware foi medido?
Em Jetson Thor, DGX Spark e H100, com runtimes TensorRT-Edge-LLM customizados e engines TensorRT. A latência considera também a preparação das features do alvo.
Fontes
- research.nvidia.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 06 de novembro de 2026
- Editoria
- CEVIU IA