
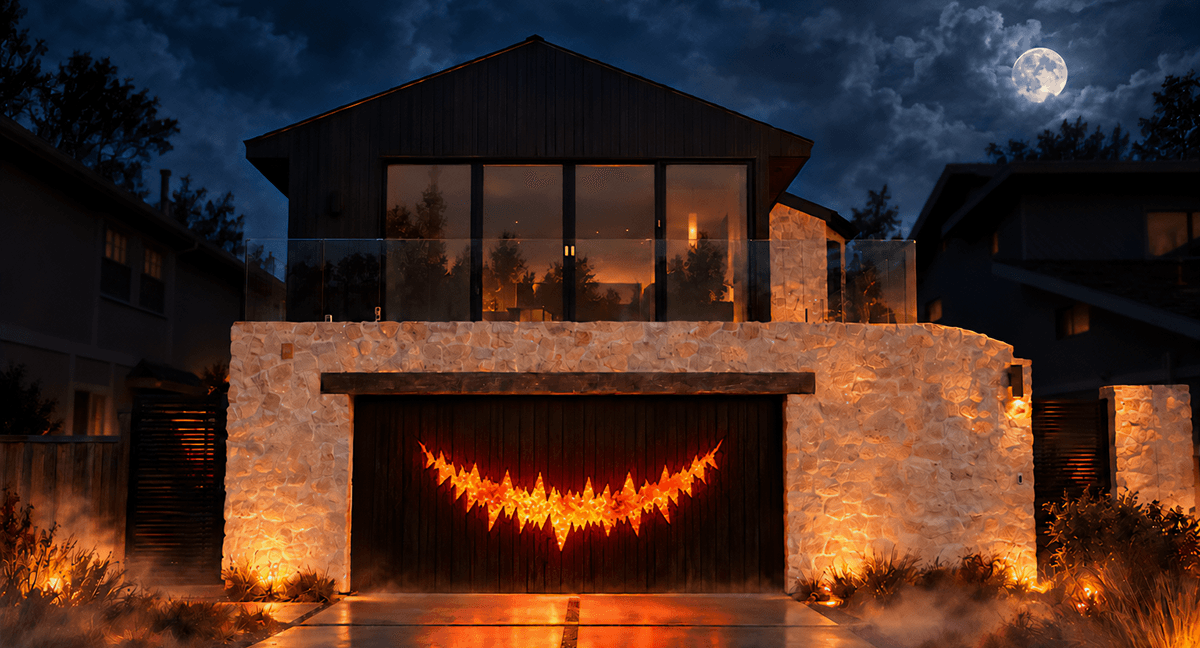
Projeção de Halloween com Nemotron transforma a garagem em uma casa rabugenta que conversa com as crianças
Aprofundamento CEVIU
Aprofundamento
O projeto é um caso concreto de pipeline em cascata de voz rodando localmente. O Nemotron Speech ASR transcreve, o Nemotron 3.5 Bolt E4B 4GB (small language model aberto para agentes conversacionais, em versão quantizada de 4 bits) gera a resposta, e um adaptador LoRA define a personalidade. O Magpie TTS Zeroshot fala a partir de uma amostra curta de referência, e o Audio2Face-3D anima a boca no Unreal Engine 5. O autor diz que testou mais de uma dúzia de modelos antes de escolher o Bolt E4B, por causa do limite de memória e compute de um sistema autônomo e sem dependência de rede.
A divisão de hardware é objetiva: a RTX PRO 6000 Blackwell Max-Q cuida do pipeline de linguagem e voz, e a RTX PRO 4000 Blackwell cuida dos gráficos do Unreal e do Audio2Face-3D. Segundo o autor, o gargalo é compute, não memória, e a separação serve para manter a taxa de quadros estável. Para reduzir latência, o sistema libera texto falável antes de a resposta terminar e usa saudações e piadas em cache, com áudio gravado. O LoRA foi treinado em mais de 5 mil conversas multi-turno. O autor ressalva que a identificação de fantasias é um teste sintético (ovelhas) e que ainda falta testar com visitantes reais. O código do projeto não será publicado, mas os modelos NVIDIA usados estão disponíveis.
O que mudou
O Nemotron 3 Nano Omni, que aqui descreve fantasias, foi apresentado pelo CEVIU em 30 de abril de 2026, na matéria "Apresentando NVIDIA Nemotron 3 Nano Omni: Inteligência Multimodal de Contexto Longo para Agentes de Documentos, Áudio e Vídeo". Ali era um lançamento focado em documentos, áudio e vídeo. Agora aparece em uso prático, como observador opcional de câmera num projeto caseiro.
Por que isso importa
Para quem opera agentes de voz, o ponto útil é a arquitetura: modelo pequeno quantizado, LoRA para persona, cache de respostas e GPUs separadas para isolar a latência da animação. Em cenários com orçamento de compute apertado, a leitura é que dá para entregar uma experiência rápida sem um modelo grande. É um relato de projeto individual, não um benchmark.
Linha do tempo
CEVIU apresenta o Nemotron 3 Nano Omni, modelo multimodal para documentos, áudio e vídeo.
MonsterHouse mostra um agente de voz de Halloween com Nemotron rodando em uma workstation.
Perguntas frequentes
Que modelos a MonsterHouse usa?
Nemotron Speech ASR para escuta, Nemotron 3.5 Bolt E4B 4GB para as respostas, Magpie TTS Zeroshot para a voz e Audio2Face-3D para a animação labial. O Nemotron 3 Nano Omni descreve fantasias, e YOLO com ByteTrack contam e rastreiam pessoas.
Que hardware o projeto exige?
Uma única workstation com duas GPUs. A NVIDIA RTX PRO 6000 Blackwell Max-Q roda linguagem e voz, e a RTX PRO 4000 Blackwell cuida do Unreal Engine e do Audio2Face-3D. O autor diz que o limite é compute, não memória.
Como a casa responde rápido?
O pipeline libera texto falável antes de a resposta inteira ficar pronta. Saudações e piadas comuns vêm de um banco de texto e de áudios em cache, o que poupa geração do modelo e síntese de voz.
Dá para reproduzir o projeto?
O código da MonsterHouse não será liberado, mas todos os modelos NVIDIA usados estão disponíveis. O autor recomenda partir do Nemotron Voice Agent e treinar um LoRA para a personalidade, com a ressalva de que o Magpie TTS Zeroshot exige pedido de acesso para rodar localmente.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 30 de outubro de 2026
- Editoria
- CEVIU IA