
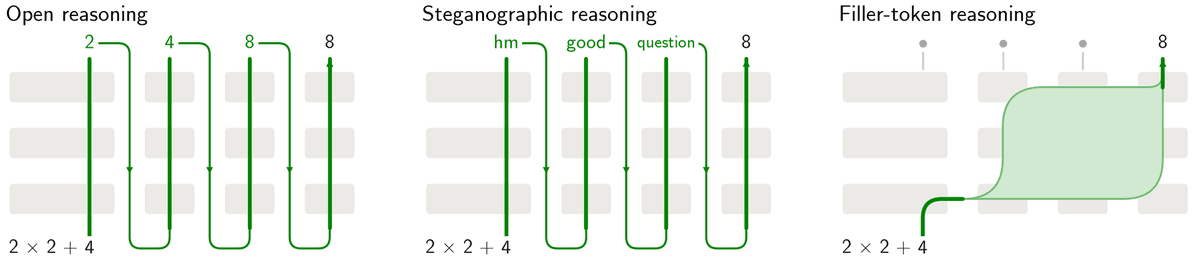
LLMs conseguem aprender parte do raciocínio em múltiplas etapas usando filler tokens, sem CoT visível
Aprofundamento CEVIU
Aprofundamento
O trabalho parte do conceito de filler-token reasoning: o modelo usa posições de token extras para computar, mas sem que as palavras emitidas nessas posições carreguem o raciocínio. A informação circula entre posições via atenção, dentro da rede. Isso dá mais computação paralela, não mais serial. A demonstração clássica é o paper "Let's Think Dot by Dot" (Pfau, Merrill & Bowman, 2024), que treinou modelos do zero em tarefas paralelizáveis (TC⁰), como 3SUM, usando só tokens ".".
Os autores mudam a receita. Em vez de pôr os pontos antes da resposta, usam pontos como entrada e o raciocínio aberto como saída: em cada posição de ponto, o alvo é um passo. O CoT é preenchido previamente com pontos, e os modelos deixam de ser preditores de próximo token puros. Também treinam LoRAs de rank 32 sobre Qwen3.6-35B-A3B e gpt-oss-20b, em vez de treinar do zero. O método supera o baseline de resposta direta, o que o método de Pfau et al. não fez nos testes deles. Há uma análise teórica de profundidade: algoritmos construídos por enxames de agentes Opus 5.5 mostram que nenhuma tarefa foi totalmente paralelizada, mas a profundidade cresce bem mais devagar que o número de passos (exceto HornQA). Empiricamente, soma modular foi aprendida até 60 passos, enquanto aritmética modular e composição de funções travaram em 1 a 3 passos. A hipótese dos autores é que o modelo sofre quando pacotes grandes de informação (tabelas, premissas) precisam cruzar posições.
Por que isso importa
Para quem avalia monitoramento de chain-of-thought, a leitura é prática: um modelo que escreve texto irrelevante e acerta uma pergunta de vários passos não prova raciocínio esteganográfico, pode ser só filler-token reasoning. Isso afeta como se desenhem tarefas de teste e o quanto se confia em CoT legível como sinal de segurança. O limite teórico de Pfau et al. vale no infinito, mas 60 passos em modelos pequenos sugerem que ele pouco tranquiliza na prática.
Perguntas frequentes
O que são filler tokens em LLMs?
São tokens extras, como pontos repetidos, que dão ao modelo mais posições para computar sem que as palavras emitidas carreguem o raciocínio. A informação passa entre posições pela atenção. Isso aumenta a computação paralela, não a serial.
Quais modelos e método foram usados no estudo?
Os pesquisadores treinaram LoRAs de rank 32 sobre Qwen3.6-35B-A3B e gpt-oss-20b. O método usa pontos como entrada e passos de raciocínio aberto como alvo em cada posição. Foi comparado ao método de Pfau et al. e a um baseline que só dá a resposta.
Até quantos passos os modelos aprenderam a raciocinar com filler tokens?
Depende da tarefa. A soma modular foi aprendida em até 60 passos. Aritmética modular e composição de funções falharam após 1 a 3 passos, e HornQA falhou com poucos passos.
Por que isso importa para a pesquisa em esteganografia no CoT?
Porque ajuda a separar dois fenômenos. Se o modelo acerta tarefas de vários passos escrevendo texto sem relação, a causa pode ser filler-token reasoning e não raciocínio oculto no texto. O estudo orienta quais tarefas usar para estudar esteganografia.
Fontes
- lesswrong.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 12 de novembro de 2026
- Editoria
- CEVIU IA