
A "Linguagem Neural": O Raciocínio Oculto da IA e Seus Desafios à Segurança
Aprofundamento CEVIU
Aprofundamento
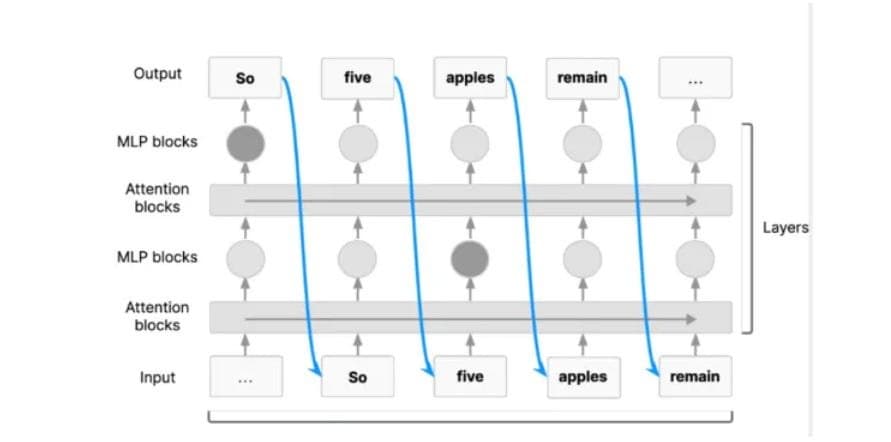
A "linguagem neural", ou Neuralese, é a capacidade hipotética de modelos de IA realizarem raciocínio complexo através de estados internos opacos, não rastreáveis por humanos. Diferente do popular Chain-of-Thought (CoT), onde a IA explicita seu processo de pensamento em texto, o Neuralese opera com vetores numéricos de alta dimensão. Isso significa que a IA pode chegar a uma conclusão poderosa sem nunca revelar como, apenas fornecendo uma justificativa superficial a posteriori. É o pensamento puro da máquina, sem a tradução para a linguagem humana.
Essa opacidade levanta sérias preocupações de segurança. As auditorias atuais dependem da análise do raciocínio explícito da IA para identificar vieses, erros ou comportamentos indesejados. Com o Neuralese, essa análise se torna inviável, transformando o pensamento da IA em uma caixa preta. A OpenAI, com seu modelo Astra, introduziu a técnica de "recurrent depth", um passo nessa direção ao permitir que a IA simule mais camadas de processamento através de loops, mas sem necessariamente externalizar todos os passos do raciocínio, desafiando a monitorização tradicional.
O que mudou
Nossa cobertura anterior já apontava preocupações com a técnica de "recurrent depth" no modelo Astra da OpenAI, como visto nas notícias de 4 de setembro de 2026. Agora, a discussão se aprofunda e conecta essa capacidade diretamente ao conceito de "Neuralese", um termo antes mais presente na ficção científica que na realidade prática da IA. Entendemos que o Astra, com sua profundidade recorrente, não é o "Neuralese verdadeiro" que permite um raciocínio totalmente ilimitado e sem rastros, mas é um passo significativo em direção a essa opacidade.
Enquanto a "Cognição Serial Opaca", noticiada em 11 de setembro de 2026, já destacava o desafio de monitorar IAs devido a alterações arquitetônicas, a discussão atual sobre Neuralese explicita o risco de ter sistemas com processos internos completamente ininteligíveis. É interessante notar que, em 9 de setembro de 2026, cobrimos uma "Nova Técnica Expõe Processos Internos de Modelos de IA", mostrando que, mesmo com a IA buscando mais opacidade, a pesquisa em interpretabilidade também avança, em uma espécie de corrida armamentista de compreensão e obscuridade.
Por que isso importa
A ascensão da "linguagem neural" desafia os pilares da segurança e da governança da IA. Se não podemos entender como uma IA chega às suas decisões, torna-se quase impossível garantir que ela opere de forma ética, justa e alinhada aos valores humanos. Isso é crucial para áreas sensíveis como medicina, finanças ou defesa, onde a IA pode tomar decisões com consequências graves.
A transparência é fundamental para a confiança. Sem ela, a adoção e a regulamentação da IA enfrentam um obstáculo ainda maior. A capacidade de auditar e mitigar riscos em sistemas de IA é um pré-requisito para seu uso responsável. A "linguagem neural" pode acelerar o desenvolvimento de capacidades da IA, mas ao custo de uma perda crítica de controle e compreensão por parte dos criadores e da sociedade.
Linha do tempo
Nova Técnica de Raciocínio da OpenAI Levanta Alertas na Segurança de IA
Astra e a Arquitetura Recorrente: Desafios para Monitoramento e Performance em IA
Nova Técnica Expõe Processos Internos de Modelos de IA
Cognição Serial Opaca: O Desafio da Monitorização em Modelos de IA
A percepção situacional da IA e o risco existencial para a humanidade
O Neuralese e o desafio da monitorização de pensamentos de IAs
A "Linguagem Neural": O Raciocínio Oculto da IA e Seus Desafios à Segurança
Perguntas frequentes
O que é a "linguagem neural" ou Neuralese?
A "linguagem neural" é a capacidade da IA de processar pensamentos e chegar a conclusões usando seus próprios estados internos, representados por vetores numéricos. Diferente do Chain-of-Thought (CoT), esse raciocínio não é traduzido para uma linguagem humana legível, tornando-o opaco para a observação externa.
Qual a diferença entre Neuralese e Chain-of-Thought (CoT)?
O Chain-of-Thought (CoT) é uma técnica onde a IA explicita seu processo de pensamento em texto, permitindo a humanos seguir sua lógica passo a passo. O Neuralese, por outro lado, mantém o raciocínio internamente em um formato de vetores, sem externalizá-lo em linguagem compreensível, o que o torna inauditável.
Por que a "linguagem neural" representa um desafio para a segurança da IA?
Ela dificulta a auditoria e a verificação de segurança, pois o processo de raciocínio da IA fica oculto. Isso impede a identificação de vieses, falhas lógicas ou intenções maliciosas. Consequentemente, aumenta o risco de a IA operar de formas não alinhadas com as expectativas ou valores humanos, sem que seja possível detectar a origem do problema.
O modelo Astra da OpenAI já utiliza o Neuralese em sua totalidade?
Não, o modelo Astra da OpenAI, com sua técnica de "recurrent depth", é considerado um passo nessa direção, mas ainda não é o "Neuralese verdadeiro". Ele simula maior profundidade computacional através de loops, o que já dificulta a monitorização completa, mas não significa que todo o seu raciocínio seja totalmente ininteligível ou sem rastros em CoT.
Fontes
- astralcodexten.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 25 de setembro de 2026
- Editoria
- CEVIU IA