
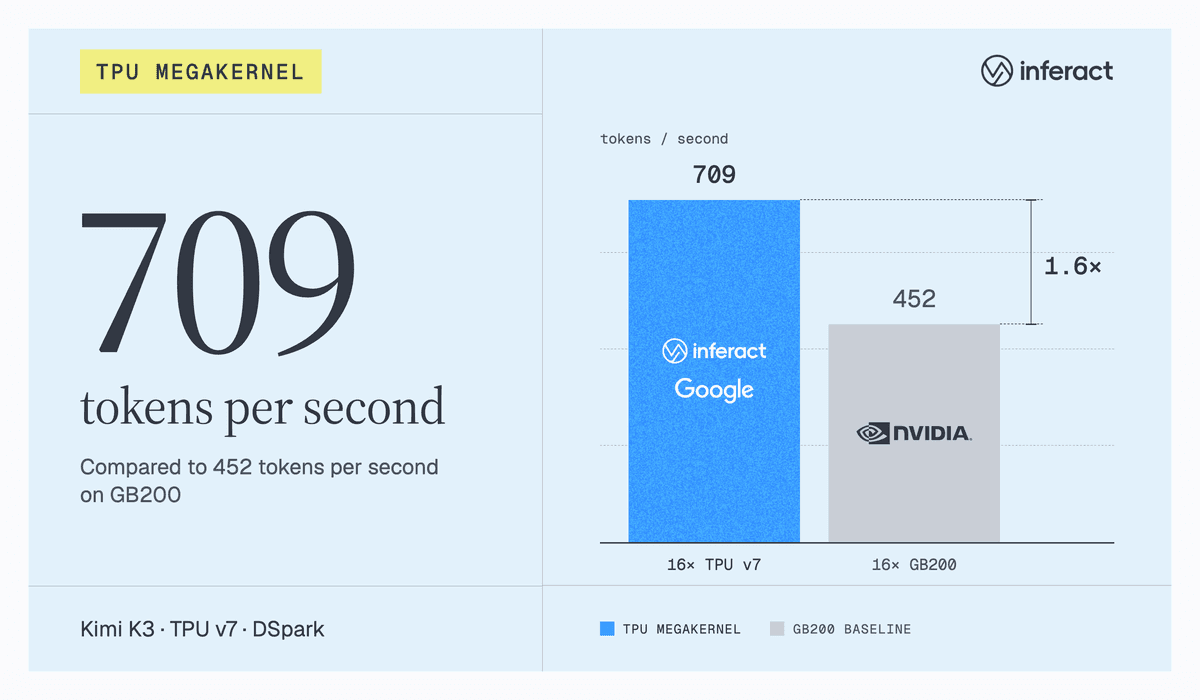
Desempenho Recorde: Kimi K3 Atinge 700 TPS com Megakernels em TPUs
Aprofundamento CEVIU
Aprofundamento
A marca de mais de 700 tokens por segundo alcançada pela implementação Kimi K3, usando os megakernels da inferact/tpu-megakernels em TPUs v7, é um marco relevante para a inferência de modelos de linguagem. No cerne desta inovação está a arquitetura da TPU e a otimização de software. As TPUs se destacam pela sua Vector Memory (VMEM), uma memória on-chip grande, gerenciada explicitamente pelo programa. Enquanto as GPUs contam com uma hierarquia de memória mais complexa, a VMEM das TPUs permite um controle preciso sobre o ciclo de vida dos dados, facilitando o pré-carregamento de pesos do modelo.
Os megakernels consolidam várias operações de decodificação em um único programa, superando as limitações de banda de memória. Isso permite que pesos de camadas futuras sejam pré-carregados na VMEM enquanto a camada atual ainda está processando. A linguagem Pallas, específica para TPUs, é essencial para expressar essas decisões de otimização, dando ao desenvolvedor um controle granular sobre o agendamento e a reutilização de buffers. Outro benefício notável é o tempo de compilação: enquanto modelos complexos no XLA podem levar mais de 30 minutos, o megakernel compila em menos de 90 segundos, acelerando o desenvolvimento e a experimentação.
O que mudou
A cobertura anterior do CEVIU News, como o artigo de 9 de setembro de 2026, já destacava os megakernels como uma tecnologia inovadora para otimizar a inferência em GPUs, inclusive superando o desempenho de implementações vLLM. Agora, a novidade é a aplicação e o desempenho excepcional desses megakernels nas TPUs v7, com a inferact/tpu-megakernels. Essa evolução mostra que a estratégia de megakernels não se restringe a uma única arquitetura de hardware, adaptando-se para extrair o máximo de cada plataforma.
Em artigos de 29 de julho e 3 de agosto de 2026, o Kimi K3 já demonstrava ganhos de performance e eficiência em GPUs AMD MI355X. A notícia atual, com 700 TPS em TPUs, indica uma expansão das plataformas onde o Kimi K3 se destaca, agora com otimizações específicas para as TPUs. Interessante notar também que, enquanto a Cohere mostrava megakernels superando o vLLM, a inferact/tpu-megakernels, conforme o artigo-fonte, constrói sobre o ecossistema vLLM de código aberto, integrando essas otimizações em uma base já existente e amplamente utilizada.
Por que isso importa
Esta conquista é um ponto de virada na corrida por eficiência em inferência de IA. A capacidade de um megakernel otimizado para TPU v7 de entregar mais de 700 tokens por segundo, superando a baseline do GB200 em até duas vezes, significa menos tempo de espera e custos operacionais menores para modelos de IA complexos. A otimização profunda da infraestrutura, aproveitando características como a VMEM da TPU, é o que permite esses saltos de desempenho.
Além da performance bruta, a rápida compilação do megakernel (menos de 90 segundos) em comparação com os longos tempos de compilação XLA (mais de 30 minutos) acelera o ciclo de inovação. Isso permite que desenvolvedores testem e implementem novas ideias muito mais rápido. Em um cenário onde a infraestrutura de IA é um gargalo, essas otimizações de software que extraem o máximo do hardware são cruciais para o avanço contínuo e a democratização de modelos de linguagem.
Linha do tempo
GLM-5.2 e AMD Redefinem Custo-Benefício na Inferência de IA
Desempenho excepcional além do escalamento convencional de modelos de IA (Kimi K3)
Kimi K3 brilha em GPUs AMD MI355X, superando Nvidia em eficiência
Cohere Inova com Megakernel para Otimizar Inferência em GPUs
Cohere revela megakernel de inferência para o North Mini Code
Otimização Revolucionária: vLLM Triplica Desempenho de Inferência do MiniMax M3 na AMD MI355X
Desempenho Recorde: Kimi K3 Atinge 700 TPS com Megakernels em TPUs
Perguntas frequentes
O que são megakernels e por que são importantes para a inferência de IA?
Megakernels são programas otimizados que consolidam múltiplas operações de inferência em um único bloco, reduzindo gargalos de comunicação entre CPU e GPU/TPU e aproveitando melhor a banda de memória. Eles são cruciais porque permitem que modelos de IA operem com mais velocidade e eficiência, diminuindo a latência e o custo de uso.
Qual a principal vantagem das TPUs sobre as GPUs no contexto de megakernels?
A principal vantagem da TPU, como a v7, reside na sua Vector Memory (VMEM) on-chip, que oferece uma memória de alta capacidade e gerenciamento explícito. Isso permite que os megakernels pré-carreguem pesos de modelos de forma agressiva, mantendo os dados próximos ao processador e maximizando o uso da largura de banda da memória, algo mais desafiador na hierarquia de cache das GPUs.
O que é decodificação especulativa e como ela contribui para o desempenho recorde?
A decodificação especulativa é uma técnica que usa um modelo menor e mais rápido para prever os próximos tokens, que são então verificados por um modelo maior e mais preciso. Se as previsões estiverem corretas, múltiplos tokens são gerados em um único passo. Isso acelera significativamente a inferência, como visto nos 700 tokens por segundo do Kimi K3.
Qual o papel da linguagem Pallas na criação dos megakernels para TPUs?
Pallas é a linguagem de kernel para TPUs, oferecendo aos desenvolvedores controle direto sobre o agendamento de operações e o gerenciamento de memória. No desenvolvimento de megakernels, Pallas permite especificar explicitamente como os pesos do modelo são pré-carregados e como os recursos de VMEM são utilizados, garantindo uma otimização profunda que superaria as capacidades de otimização automática de compiladores como o XLA.
Fontes
- inferact.aifonte original
- Categoria
- CEVIU IA
- Publicado
- 25 de setembro de 2026
- Editoria
- CEVIU IA