
Cerebras detalha como implanta modelos de trilhões de parâmetros em vários wafers WSE-3T
Aprofundamento CEVIU
Aprofundamento
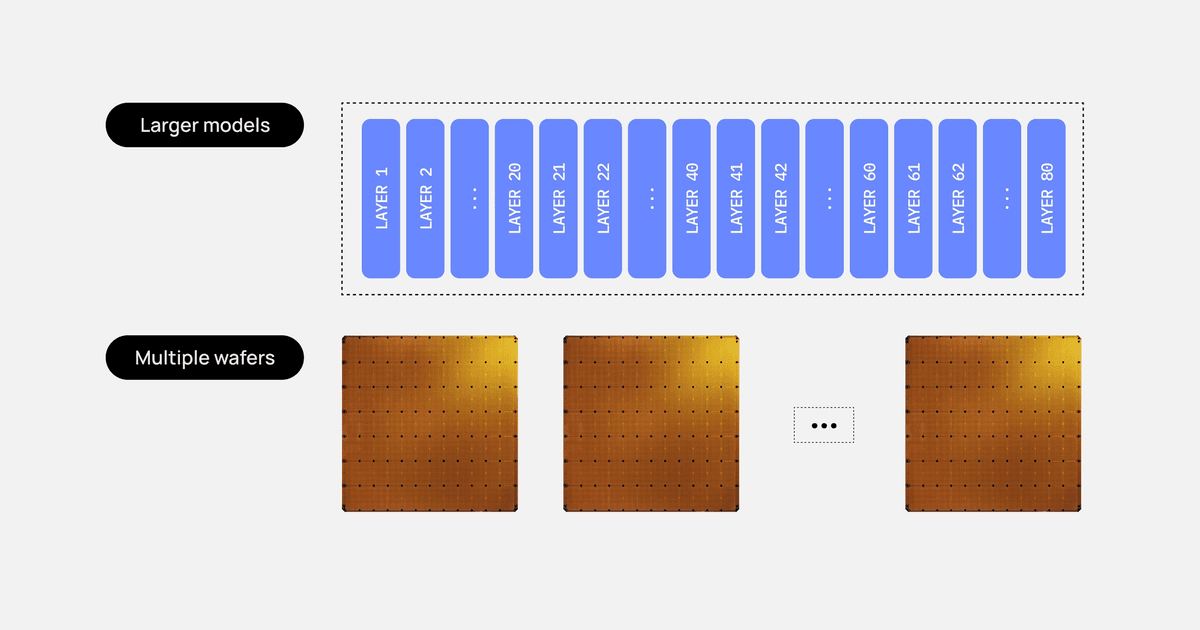
A Cerebras parte de um problema de capacidade. Um wafer WSE-3T tem 44 GB de SRAM on-chip, e modelos de trilhões de parâmetros precisam de terabytes só para os pesos. No post, a empresa usa o Kimi K3 (open source, cerca de 3 trilhões de parâmetros, 69 camadas de atenção linear e 24 camadas densas) como exemplo ilustrativo. As premissas são pesos em 4 bits, KV cache em 8 bits e requisições médias de 256k tokens.
A conta é direta: 3T de parâmetros em 4 bits dão cerca de 16 GB por camada, divididos por 93 camadas. Cada wafer comporta uma camada densa (o restante da SRAM vai para o KV cache) ou duas camadas lineares, que guardam só um estado pequeno e fixo por requisição. Resultado: 35 wafers para as camadas lineares mais 24 para as densas, 59 wafers. Os wafers formam um pipeline, e só as ativações trafegam entre eles, via RDMA sobre Ethernet, a cerca de 2 microssegundos por salto. Os pesos ficam parados. Para manter o pipeline cheio, cada estágio processa uma requisição diferente (ou um micro-batch), e o teto de concorrência vem da SRAM livre para KV cache nos wafers das camadas densas. A empresa informa 1000 a 2000+ tokens por segundo e diz que a métrica mais útil é throughput por unidade de energia (tokens por segundo por megawatt) na mesma velocidade de geração. O post não traz esse número.
O que mudou
A cobertura anterior ajuda a ver o que o post acrescenta. Em 13 de maio de 2026, o CEVIU noticiou, em "A Mudança da Inferência", que o WSE-3 da Cerebras tinha 44GB de SRAM on-chip, com a discussão sobre hierarquia de memória para agentes. Em 9 de março de 2026, "O papel emergente dos chips com arquitetura SRAM na inferência de IA" tratava das vantagens de latência e throughput desses chips. Agora a empresa mostra, com conta passo a passo, como essa SRAM de 44 GB por wafer vira um sistema para modelos de 3T de parâmetros.
Por que isso importa
Para quem avalia infraestrutura de inferência, o post deixa claro onde está o custo: o número de wafers cresce com os pesos, e a concorrência é limitada pela SRAM sobrando para KV cache nas camadas densas. Isso favorece arquiteturas com muita atenção linear, que gastam menos cache. É a descrição do fabricante, com premissas escolhidas por ele, então vale pedir benchmarks independentes antes de comparar com GPUs.
Linha do tempo
CEVIU noticia o papel de chips baseados em SRAM, como os da Cerebras, na inferência de IA.
CEVIU aborda a divisão da inferência e os 44GB de SRAM on-chip do WSE-3.
Cerebras detalha em blog como implanta modelos de trilhões de parâmetros em vários wafers WSE-3T.
Perguntas frequentes
Quantos wafers WSE-3T a Cerebras usa para o Kimi K3?
No exemplo do post, 59 wafers: 35 para as 69 camadas lineares (duas por wafer) e 24 para as camadas densas (uma por wafer). O cálculo assume pesos em 4 bits e KV cache em 8 bits. É um exemplo ilustrativo, não necessariamente a configuração de produção.
Os pesos do modelo precisam se mover entre os wafers?
Na maioria dos casos, não. Cada camada tem cerca de 16 GB e cabe inteira nos 44 GB de SRAM de um wafer. Só as ativações passam de um wafer para o outro, via RDMA sobre Ethernet, a cerca de 2 microssegundos por salto.
O que limita o número de requisições simultâneas?
A SRAM que sobra para o KV cache nos wafers com camadas densas. Cada requisição em andamento precisa do seu cache em cada um desses wafers. As camadas de atenção linear guardam só um estado pequeno e fixo, então não pesam nessa conta.
O pipeline deixa os wafers ociosos esperando a vez?
Segundo a Cerebras, não. Cada estágio trabalha em uma requisição diferente ao mesmo tempo, e pode processar micro-batches. Micro-batches menores deixam cada requisição mais rápida, e maiores aumentam o throughput total.
Fontes
- cerebras.aifonte original
- Categoria
- CEVIU IA
- Publicado
- 23 de outubro de 2026
- Editoria
- CEVIU IA