
Classificação com LLMs: Um Desafio de 'Feature Engineering' Crucial para a Pesquisa em IA
Aprofundamento CEVIU
Aprofundamento
A classificação com Large Language Models (LLMs) representa um dos grandes desafios no campo da Inteligência Artificial. Inicialmente, o uso direto de LLMs para classificar textos, pedindo que retornem um rótulo, mostrou-se problemático. Apesar de frequentemente atingirem um desempenho razoável, esses modelos sofrem com a falta de calibração, não permitem estimativa de parâmetros ou a inserção fácil de novas características, o que limita sua confiabilidade em cenários mais exigentes.
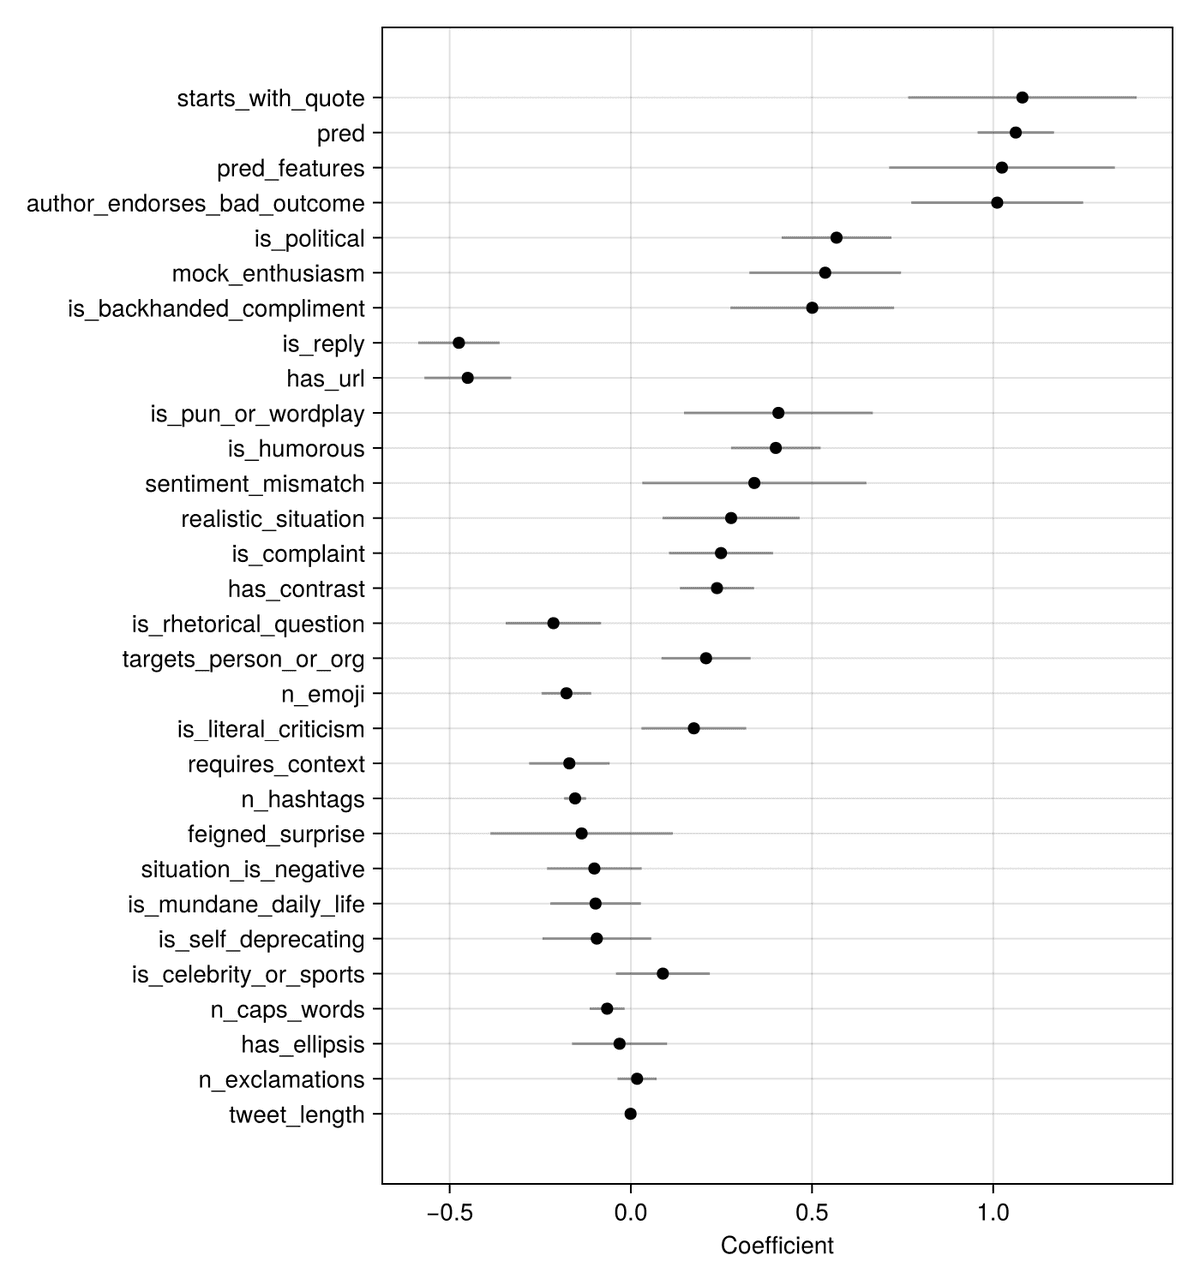
O CEVIU News vem acompanhando de perto os debates sobre a avaliação de LLMs. Artigos como "LLMs Amadurecem e Desafiam Métricas de Avaliação Atuais", de 14 de julho de 2026, e "Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção", de 26 de agosto de 2026, já apontavam para a dificuldade em obter resultados consistentes e robustos com esses modelos. A nova abordagem, que encara a classificação via LLMs como um problema de feature engineering, propõe uma solução. A ideia é extrair informações dos LLMs para usá-las como características de entrada em modelos de Machine Learning mais tradicionais, como a regressão logística. Este método permite, por exemplo, prever a probabilidade de uma saída específica, proporcionando um controle estatístico e a capacidade de integrar características adicionais que vão além do LLM, como dados determinísticos. Isso não só melhora a precisão, mas também a interpretabilidade e a confiabilidade do classificador final. O artigo explora, inclusive, o potencial de classificadores agentivos, onde o próprio LLM investiga e utiliza seu processo de investigação como característica para a classificação.
O que mudou
A cobertura anterior do CEVIU News, especialmente em "Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção" (26 de agosto de 2026), destacava os desafios de se confiar em LLMs para tarefas críticas de classificação, dadas as dificuldades com a robustez e a avaliação em ambientes de produção. O que mudou é que, agora, esta nova abordagem oferece uma metodologia concreta para superar essas limitações. Em vez de focar apenas nos problemas, a comunidade de IA está propondo e validando frameworks que transformam a saída de um LLM em um dado tratável, elevando a qualidade e a confiabilidade de sua aplicação como classificadores. Passamos da identificação de um gargalo para a proposição de uma arquitetura que o contorna, integrando o poder do LLM com a solidez estatística de algoritmos clássicos.
Por que isso importa
Esta perspectiva transforma a maneira como pesquisadores e engenheiros podem utilizar LLMs para classificação. Ela tira o processo do campo da "arte" da engenharia de prompts, tornando-o uma ciência mais mensurável e replicável. A capacidade de criar classificadores mais confiáveis e calibrados com LLMs é crucial para diversas aplicações, desde a detecção de ironia em tweets, como o exemplo do artigo, até a análise de sentimento ou a filtragem de conteúdo. Além disso, a capacidade de integrar características não-LLM aumenta a flexibilidade e o desempenho desses sistemas, consolidando a utilidade dos LLMs em contextos onde a precisão e a validade estatística são indispensáveis. Com LLMs cada vez mais presentes em pesquisa e produção, ter métodos que garantam alta qualidade nos resultados se tornou fundamental.
Linha do tempo
CEVIU News publica "LLMs Amadurecem e Desafiam Métricas de Avaliação Atuais".
CEVIU News publica "Desvendando a Performance de LLMs Locais: O Impacto de Hardware e Configurações".
CEVIU News publica "Aprendizado por Reforço Impulsiona Evolução de Grandes Modelos de Linguagem".
CEVIU News publica "Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção".
CEVIU News publica "Desvendando a Fronteira Eficiente da Inferência de LLMs".
CEVIU News publica "Nova Abordagem Revoluciona Resolução de Problemas Complexos em IA com Reforço".
CEVIU News publica "Classificação com LLMs: Um Desafio de 'Feature Engineering' Crucial para a Pesquisa em IA".
Perguntas frequentes
O que significa 'feature engineering' no contexto de classificação com LLMs?
Feature engineering é o processo de usar o Large Language Model para extrair informações relevantes do texto, que são então tratadas como 'características' ou 'features'. Essas características são usadas como entrada para um algoritmo de Machine Learning mais tradicional, como a regressão logística, para realizar a classificação final. O LLM atua como um extrator de dados ricos e contextuais.
Por que não é ideal usar LLMs diretamente como classificadores?
Quando usados diretamente, LLMs podem carecer de calibração, tornando difícil prever a probabilidade de uma classificação. Eles também não permitem a estimação de parâmetros de forma transparente nem a fácil incorporação de características adicionais para refinar a decisão. A otimização se resume a uma 'engenharia de prompts' muitas vezes subjetiva e ineficiente.
Como essa nova abordagem melhora a precisão e a confiabilidade dos classificadores com LLMs?
Ao tratar a saída do LLM como uma característica para um modelo de Machine Learning estatisticamente robusto, como a regressão logística, o sistema ganha calibração e a capacidade de estimar probabilidades. Isso permite integrar características adicionais, otimizar parâmetros com dados de treinamento e obter resultados estatisticamente mais válidos e confiáveis, superando o desempenho de classificadores LLM puros e até de modelos concorrentes.
Essa técnica já tem aplicação prática ou é apenas teórica?
A técnica já mostra resultados práticos promissores. No artigo, ela supera o vencedor de uma competição de detecção de ironia em tweets de 2018. Além disso, artigos recentes em conferências importantes como ICML e ECML PKDD demonstram o uso de LLMs para engenharia automática de características em tarefas de aprendizado tabular e interpretação de Machine Learning, indicando um campo de pesquisa e aplicação em rápida expansão.
Fontes
- minimallysufficient.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 18 de setembro de 2026
- Editoria
- CEVIU IA