
Benchmarks públicos de IA ignoram a maior parte do trabalho da sua empresa
Aprofundamento CEVIU
Aprofundamento
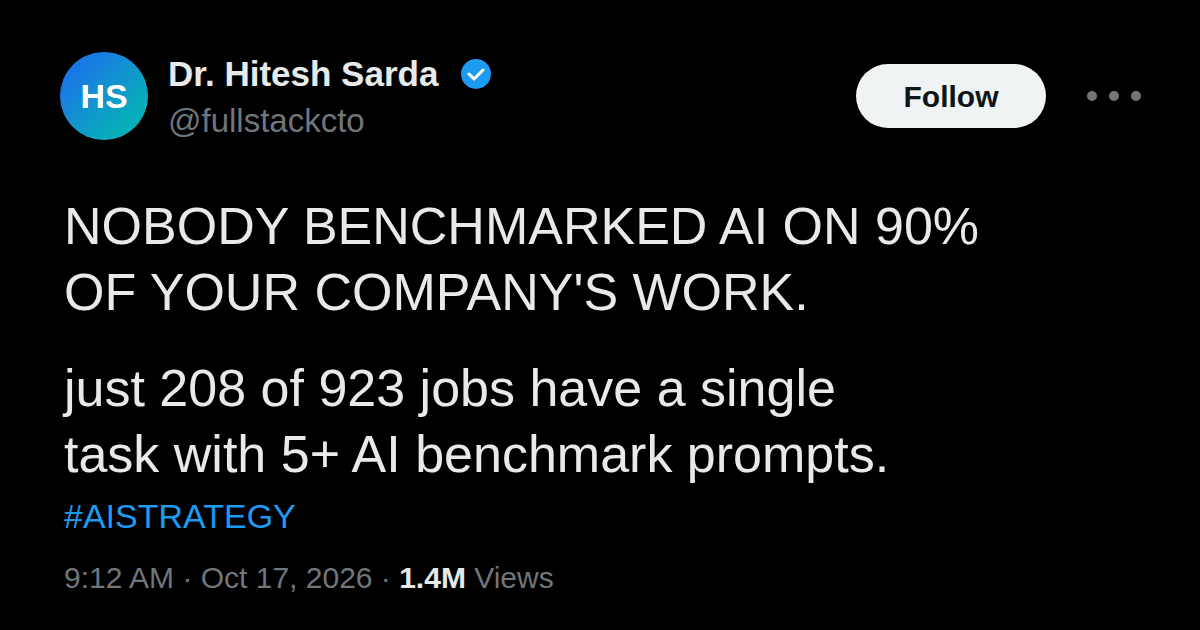
A Mercor cruzou 29 benchmarks públicos de IA com o O*NET, o catálogo do Departamento do Trabalho dos EUA que divide 923 ocupações em 18.797 tarefas. Só 208 ocupações têm ao menos uma tarefa com cinco ou mais prompts de benchmark, e apenas 924 tarefas aparecem na amostra. Ponderando pelo tempo, a estimativa é que cerca de 90% das horas de trabalho americanas caem em tarefas com pouca ou nenhuma cobertura. A própria Mercor diz que os números são provisórios e dependem dos 29 benchmarks escolhidos.
O autor argumenta que benchmarks nascem onde a correção é barata de checar: código compila ou não, modelo financeiro fecha ou não. Já saber se uma ligação de cobrança reteve o cliente exige alguém que conheça o negócio. Além disso, ocupações com folha salarial maior aparecem em excesso. Outro ponto é que cobertura por ocupação engana: 29 de 36 ocupações de computação e matemática são "cobertas", mas 924 de 18.797 tarefas é menos de 5%. O texto recomenda planejar por tarefa, listar as 20 rotinas que mais consomem horas, escolher como piloto algo fácil de verificar e montar um teste próprio com cerca de 50 casos reais, definição clara de bom resultado e uma linha de base humana.
O que mudou
O tema vem sendo construído na cobertura do CEVIU. Em 19 de outubro de 2026, o CEVIU noticiou "Mapeando o Desconhecido: A Lacuna da IA nos Benchmarks de Mercado de Trabalho dos EUA", que já apontava que 90% das horas de trabalho americanas ficam fora dos benchmarks. Em 20 de outubro de 2026, em "A Armadilha dos Benchmarks em IA: Estamos Otimizando Pelas Métricas Erradas?", o foco foi o risco de otimizar para testes específicos. A notícia de agora muda o ângulo: sai o diagnóstico da lacuna e entra a consequência para quem decide compra, ou seja, benchmark público não dá vantagem competitiva e o teste interno sim.
Em 10 de setembro de 2026, o CEVIU publicou "Avaliação de IA: A falha crucial nos testes de POC e a solução para empresas", e em 22 de setembro de 2026, "Avaliação de IA: Por Que Seus Especialistas Podem Não Ser Os Melhores Juízes". Os dois tratam de como montar avaliações internas confiáveis, o que complementa o passo a passo sugerido aqui.
Por que isso importa
Para quem lidera uma startup, a leitura é prática: escolher ferramenta de IA pelo ranking público tende a levar você ao mesmo lugar dos concorrentes. O que diferencia é o teste feito nas suas tarefas, com seus dados. Um piloto pequeno, em fluxo fácil de checar, custa pouco e gera conhecimento que ninguém copia. Também ajuda a definir quanta autonomia dar a um agente, já que sem saber a taxa de erro na tarefa não dá para dimensionar risco.
Linha do tempo
CEVIU noticia a falha crucial nos testes de POC de IA em empresas.
CEVIU noticia por que especialistas podem não ser os melhores juízes de pilotos de IA.
CEVIU noticia o Benchmark Map: 90% das horas de trabalho dos EUA fora dos benchmarks.
CEVIU noticia a armadilha dos benchmarks e o risco de otimizar métricas erradas.
CEVIU noticia que benchmarks públicos ignoram a maior parte do trabalho e recomenda testes internos.
Perguntas frequentes
O que o estudo da Mercor mediu?
Mapeou 29 benchmarks públicos de IA sobre as 18.797 tarefas do catálogo O*NET. Só 924 tarefas têm cobertura, e a estimativa é que cerca de 90% das horas de trabalho americanas tenham pouca ou nenhuma. A Mercor afirma que os números são provisórios.
Por que benchmarks públicos não geram vantagem competitiva?
Todos os concorrentes leem os mesmos rankings e tendem a comprar as mesmas ferramentas, para as mesmas tarefas, ao mesmo tempo. O trabalho coberto vira commodity primeiro. Evidência privada é a única que um rival não consegue copiar.
Como começar a testar IA nas tarefas da minha empresa?
Liste as 20 rotinas que mais consomem horas em uma área e veja quais têm evidência pública. Escolha como piloto uma com resultado fácil de verificar, como conciliar uma fatura. Monte cerca de 50 casos reais, defina o que é bom resultado e tenha uma linha de base humana.
Tarefa sem benchmark significa que a IA é ruim nela?
Não necessariamente. Ausência de evidência não prova incapacidade nem segurança. O erro é tanto supor que o trabalho não coberto é intocável quanto achar que a demo do fornecedor vale para tudo. A saída é medir.
Fontes
- hitesh.infonte original
- Categoria
- CEVIU Empreendedores
- Publicado
- 28 de outubro de 2026
- Editoria
- CEVIU Empreendedores