A adoção de agentes de codificação de IA em indústrias reguladas exige uma abordagem estruturada. Times de plataforma podem viabilizar a transição da experimentação à produção, estabelecendo governança robusta. Isso envolve a criação de ambientes controlados, garantia de visibilidade abrangente e implementação de trilhas de auditoria, além da aplicação rigorosa de políticas. Tais medidas são cruciais para assegurar uma integração segura e escalável, permitindo que as organizações aproveitem o potencial da IA sem comprometer a conformidade.
O Model Context Protocol (MCP) anunciou uma atualização significativa em sua especificação, migrando de sessões stateful para uma arquitetura HTTP stateless. Essa mudança elimina a complexidade de sticky sessions, armazenamentos de sessão compartilhados e coordenação de instâncias em servidores MCP remotos, mesmo quando operam atrás de um balanceador de carga. Agora, cada requisição carrega seu próprio contexto em um objeto de metadados, permitindo que qualquer instância de servidor processe qualquer requisição. Além disso, o MCP substitui seu canal de logging proprietário por OpenTelemetry e padroniza o rastreamento de requisições com W3C Trace Context, aprimorando a capacidade das equipes de correlacionar chamadas de agentes de IA com o restante da stack de aplicação em um único backend de observabilidade.
A AWS introduziu um fluxo de trabalho autônomo inovador para otimizar a resolução de problemas em ambientes de CI/CD. A solução integra o AWS DevOps Agent com o GitHub e o MCP Server, permitindo a investigação proativa de falhas, a identificação precisa da causa-raiz e a geração automática de pull requests para correção. Esta abordagem visa diminuir significativamente o esforço manual de depuração, agilizando a recuperação de incidentes e aprimorando a confiabilidade das pipelines de entrega contínua.
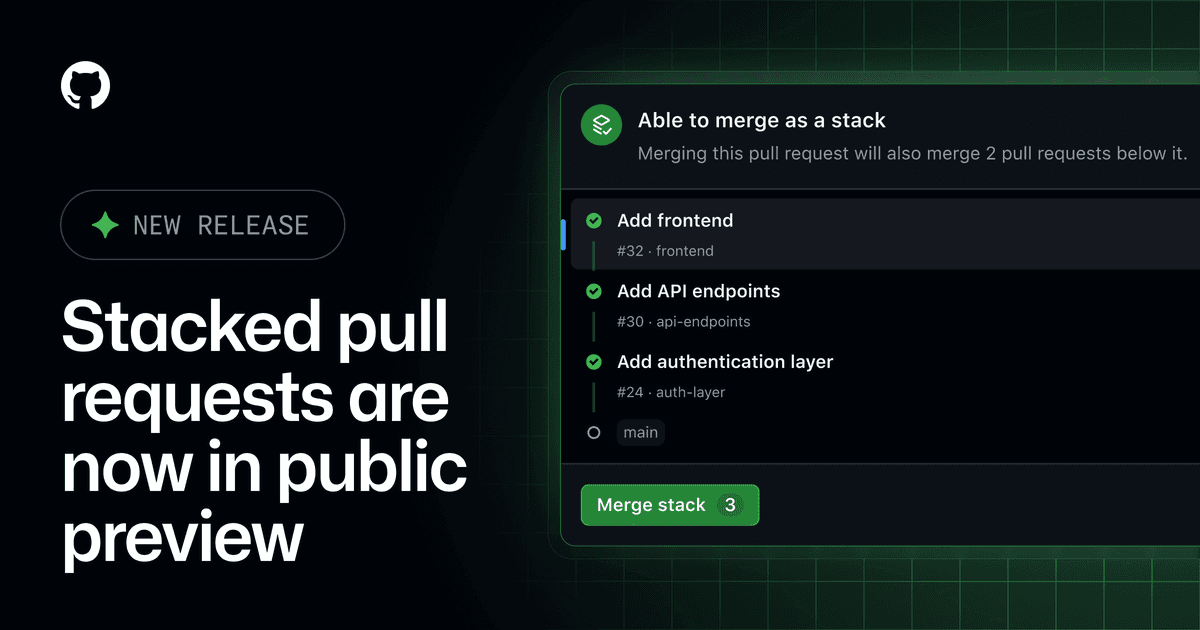
O GitHub anunciou a Public Preview dos stacked pull requests, uma funcionalidade que promete otimizar o fluxo de trabalho dos desenvolvedores. Essa novidade permite decompor grandes mudanças de código em múltiplos PRs menores e sequenciais, facilitando a revisão e a colaboração. A abordagem mantém as verificações automatizadas e as proteções de branch já existentes, visando aprimorar a eficiência no processo de integração contínua e entrega, um marco importante para as práticas de DevOps.
A Datadog ressalta a eficácia do método Single Step Instrumentation como a abordagem preferencial para implementar distributed tracing, simplificando significativamente a configuração. No entanto, a empresa também esclarece cenários em que a instrumentation manual ou personalizada se faz indispensável, como em ambientes não suportados por integrações prontas ou quando se busca uma visibilidade mais granular e aprofundada sobre o comportamento das aplicações.
A Cloud Native Computing Foundation (CNCF) divulgou a programação oficial do Observability Summit Europe 2026, que será realizado em Praga no dia 5 de outubro. O evento, essencial para profissionais de DevOps e SRE, promete mais de 25 sessões técnicas aprofundadas. Destaques incluem discussões sobre monitoramento sintético automatizado, Observability as Code e a aplicação de fluxos de trabalho impulsionados por IA para aprimorar a visibilidade de sistemas. As inscrições gerais estão abertas por 150 euros, com opção acadêmica a 85 euros. Há também a bolsa Dan Kohn, que oferece registro gratuito para grupos sub-representados, com inscrições até 23 de agosto.
A extensão multicluster do Linkerd possibilita três abordagens para interconectar clusters Kubernetes: federação, espelhamento plano e espelhamento via gateway. Uma demonstração prática com três clusters GKE revelou a coexistência desses modos, utilizando uma topologia full-mesh e um teste de caos simulando falhas. Serviços federados garantem a redistribuição automática de tráfego em cenários de indisponibilidade de um cluster, enquanto serviços espelhados demandam que a aplicação cliente gerencie o failover. A configuração por serviço, via uma única label, permite a simultaneidade dos padrões em uma mesma infraestrutura de links.
O Pulumi Cloud acaba de implementar uma nova funcionalidade crucial para a segurança das organizações: a capacidade de definir um limite máximo de validade para os tokens de acesso. Administradores agora podem configurar, em dias, a expiração desses tokens, reforçando as práticas de segurança e mitigando riscos associados a credenciais comprometidas ou esquecidas. Essa atualização é um passo importante para a governança e conformidade em ambientes de infraestrutura como código.
A Oracle apresentou um fluxo de trabalho detalhado para FinOps, focando na integração de dados de custo da AWS com o ambiente OCI. A solução organiza dados padronizados diários do FOCUS, armazena-os no OCI Object Storage e os ingere no Oracle Log Analytics. Essa abordagem visa proporcionar análise e monitoramento confiáveis de custos em nuvem, capacitando equipes a otimizar gastos e melhorar a visibilidade operacional sobre a infraestrutura AWS.
A adoção de microservices é frequentemente vista como uma evolução técnica para substituir monólitos, mas sua principal contribuição reside na criação de fronteiras organizacionais. Essa abordagem permite que equipes assumam a propriedade e a entrega independente de componentes, promovendo autonomia. Contudo, essa liberdade acarreta complexidades inerentes a sistemas distribuídos, como duplicação de infraestrutura, dificuldades na depuração e aumento dos custos de coordenação. Portanto, a arquitetura de microservices é mais benéfica quando a escala organizacional justifica tais trade-offs, alinhando as equipes com a responsabilidade de ponta a ponta.
O Grafana Cloud introduziu uma nova API unificada para gerenciar allowlists, adotando um formato JSON estruturado e sensível à região. Essa atualização substitui as configurações legadas de allowlists por produto. Usuários devem, imperativamente, atualizar e validar a automação de seus firewalls, pois os endpoints antigos serão desativados em 31 de janeiro, garantindo a continuidade e segurança no acesso aos serviços da plataforma.
A Harness e a Kong anunciaram a expansão de sua parceria estratégica, focada em fortificar a segurança de arquiteturas impulsionadas por IA. A colaboração integra o Harness AI Security ao Kong AI Gateway, permitindo que as empresas identifiquem, monitorem e protejam ativos de IA, agentes, serviços LLM e fluxos de trabalho MCP. Esta união visa oferecer detecção de ameaças e visibilidade em tempo real, essenciais para a confiabilidade e segurança de sistemas baseados em IA.
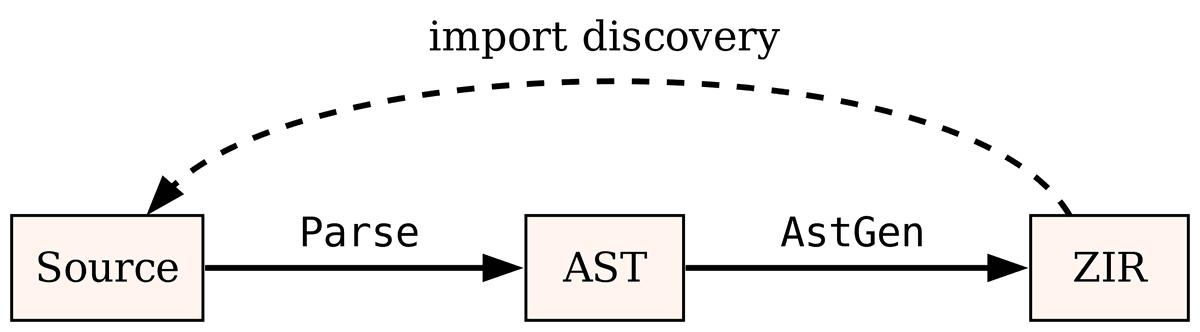
O compilador Zig eleva a eficiência ao rastrear hashes de código-fonte e grafos de dependência em nível de declaração. Essa abordagem permite reanalisar e recompilar apenas as funções diretamente afetadas por alterações no código. Adicionalmente, um linker incremental altamente integrado é capaz de aplicar patches diretamente no código de máquina atualizado, resultando em reconstruções de aplicações complexas que podem levar entre 50 e 70 milissegundos após a compilação inicial, um ganho significativo em produtividade para desenvolvedores.
A HashiCorp anunciou novidades para o HCP Terraform e o Terraform Enterprise, visando otimizar a resiliência da infraestrutura, aprimorar a governança e escalar operações. Entre as inovações, destacam-se a recuperação de workspaces, suporte a monorepos para Stacks, migrações guiadas, funcionalidades de tagging para o registro e permissões granulares para override de políticas. Essas atualizações são cruciais para equipes que buscam maior controle e automação em suas práticas de infraestrutura como código.
A AWS lançou o EKS Node Monitoring Agent, uma iniciativa open source para otimizar a confiabilidade de clusters Kubernetes com GPUs. A ferramenta detecta proativamente falhas de hardware e infraestrutura em nós, acionando a substituição automática por meio do Karpenter. Este desenvolvimento ressalta a importância de APIs estáveis, minimização de latência, classificação de severidade de falhas, isolamento de workloads e uma clara separação entre detecção e diagnóstico de problemas, fundamentais para arquiteturas de alta disponibilidade em ambientes de IA e machine learning.
O OpenTelemetry, resultado da fusão entre OpenCensus e OpenTracing em 2019, alcançou em maio de 2026 o status de projeto graduado na Cloud Native Computing Foundation (CNCF), um marco significativo que o coloca ao lado de gigantes como Kubernetes e Prometheus. Com mais de 12.000 contribuições e 2.800 empresas envolvidas, a iniciativa demonstra uma impressionante velocidade de desenvolvimento, sendo a segunda mais rápida na CNCF. Atualmente, oferece suporte completo para traces, logs e métricas, além de introduzir profiling como novo tipo de sinal. O futuro do OpenTelemetry promete avanços como convenções semânticas para IA generativa, observabilidade para navegadores e dispositivos móveis, e a inovadora instrumentação zero-code via OpenTelemetry Injector.
O Supabase e o Grafana Labs anunciaram uma nova integração que promete simplificar a observabilidade para desenvolvedores. Agora, usuários do Supabase podem acessar diretamente os recursos de monitoramento e análise do Grafana Cloud com apenas um clique a partir do dashboard do Supabase, agilizando a visualização e o diagnóstico de suas aplicações e infraestruturas.
Engenheiros de Staff desempenham um papel crucial na identificação de problemas de alto impacto, absorvendo desafios recorrentes entre equipes e buscando a raiz das necessidades, em vez de focar apenas nas soluções superficiais. A validação de ideias promissoras envolve protótipos, RFCs (Request for Comments) e feedback de stakeholders. Ao resolver consistentemente problemas relevantes, esses profissionais constroem a confiança e visibilidade necessárias para influenciar o roadmap tecnológico, mesmo sem gerenciar diretamente todas as implementações.
A ascensão dos agentes de IA impõe um desafio crucial à engenharia de plataformas, exigindo a formalização de padrões, avaliações, políticas e frameworks de responsabilização. As equipes de plataforma, com seu conhecimento intrínseco, são capacitadas a converter o discernimento humano implícito em infraestruturas escaláveis para IA. Este processo possibilita uma autonomia mais segura, por meio de fluxos de trabalho codificados, governança robusta e guardrails em constante aprimoramento, garantindo que a IA opere dentro de parâmetros bem definidos.
Modelos de IA open-weight são cruciais para democratizar o acesso, reduzir custos operacionais, intensificar a competição e mitigar o aprisionamento tecnológico (vendor lock-in), permitindo que empresas executem e adaptem soluções de IA em sua própria infraestrutura. Setenta empresas e organizações de tecnologia defendem que legisladores devem focar em acesso a recursos computacionais, infraestrutura de IA compartilhada e avaliação de modelos, em vez de restrições amplas que poderiam concentrar o avanço da IA nas mãos de poucos provedores fechados. Tal abordagem é vista como vital para a manutenção da liderança americana no setor.