A Cloudflare anunciou uma otimização significativa em seu resolvedor DNS 1.1.1.1, resultando na economia de cerca de 100 terabytes de memória na plataforma Big Pineapple. Através de cinco otimizações consecutivas nas entradas de cache, o consumo de memória por entrada foi reduzido em 56%, caindo de 953 para 420 bytes em mais de 250 bilhões de entradas. Essa melhoria elevou o throughput de inserção no cache em 43% e diminuiu a latência de lookup em 19%, evidenciando ganhos substanciais em eficiência operacional e uso de recursos.
A DigitalOcean anunciou o lançamento dos Droplets v5, sua mais recente geração de máquinas virtuais projetadas para otimização de desempenho. As novas instâncias são construídas sobre processadores AMD EPYC de 5ª Geração, prometendo entregar maior poder computacional e eficiência para diversas cargas de trabalho na nuvem. Esta atualização visa atender às demandas crescentes por infraestrutura de alto desempenho, oferecendo uma plataforma robusta para desenvolvedores e empresas.
O avanço da IA agentic intensifica os riscos de segurança empresarial, uma vez que agentes autônomos podem interagir com sistemas críticos, gerando vulnerabilidades como 'prompt injection' e 'tool poisoning'. Diante desse cenário, empresas precisam transitar de abordagens restritivas para um modelo de governança proativa, que incorpore segurança por design. Isso inclui o estabelecimento de identidades e permissões claras para os agentes, implementação de supervisão centralizada e a exigência de aprovação humana para ações de alto risco, assegurando a confiabilidade e a integridade das operações com IA.
A DigitalOcean concluiu a correção de sua frota completa de hypervisors contra duas vulnerabilidades de segurança distintas de guest-to-host em um único mês, garantindo a continuidade operacional sem impacto aparente para os clientes. A primeira, identificada como Januscape (CVE-2026-53359), uma falha de virtualização aninhada KVM, foi mitigada em todos os hypervisors até 14 de julho, após sua divulgação pública em 6 de julho. Subsequentemente, a empresa remediou uma vulnerabilidade que afetava cerca de 1.600 hypervisors AMD em doze regiões, requerendo uma atualização de kernel e reinicialização. A correção foi finalizada até 5 de agosto, um dia antes da AMD emitir seu boletim público, demonstrando agilidade na resposta a incidentes de segurança.
Enquanto agentes de IA otimizam o desenvolvimento de software, as operações de produção ainda dependem de equipes de on-call humanas, impactando a agilidade. Uma nova proposta integra agentes de IA para detecção, investigação, correção e prevenção contínua de incidentes, escalando apenas desafios inéditos. Essa abordagem inovadora transforma o papel do engenheiro, que deixa de ser um respondedor inicial para se tornar um decisor estratégico, focando em problemas complexos e na evolução do sistema.
Ferramentas de codificação baseadas em IA podem criar o fenômeno do "novato especialista", no qual desenvolvedores, embora proficientes em usar agentes de IA, carecem do julgamento crítico para avaliar os resultados. A dependência excessiva de código gerado por IA pode suplantar o esforço fundamental que constrói essa expertise. Para um aprendizado mais eficaz, a IA deveria atuar como tutora ou parceira socrática, em vez de mera geradora de código, preservando atividades cruciais como planejamento, depuração e a prática de tentativa e erro, elementos essenciais para transformar experiência em verdadeira expertise técnica.
A plataforma Acadia, inspirada no Datalog, propõe uma solução robusta para o desafio do N+1 Query ao eliminar loops e recursão de propósito geral em sua linguagem de consulta. Essa abordagem impede que desenvolvedores introduzam inadvertidamente chamadas extras ao banco de dados. Em vez disso, as relações são definidas por operações como 'intersect', que são compiladas para SQL baseado em conjuntos, assegurando a terminação de consultas em tempo polinomial em relação ao volume de dados.
A Atlassian deu um passo significativo na redução do tempo de diagnóstico de incidentes em produção, desenvolvendo um sistema automatizado para análise de causa raiz em seus microserviços. A ferramenta integra sinais de anomalias de métricas, distributed traces e logs, correlacionando-os em uma linha do tempo unificada. Utilizando um grafo de dependências de serviços, construído com dados de span do OpenTelemetry, o sistema gera e classifica hipóteses para identificar a origem das falhas, prometendo agilizar a resposta a incidentes e otimizar a operação em ambientes cloud native.
O GitHub revelou que a indisponibilidade de 7 horas e 47 minutos, ocorrida em 17 de agosto, foi causada por um tráfego recorde que sobrecarregou um componente de infraestrutura essencial na região Central dos EUA. A falha de escalabilidade gerou problemas de autenticação e interrupções em cascata. A recuperação foi complexa devido a um loop de *retry* do Copilot, no lado do cliente. Como resposta, o GitHub está implementando orçamentos de *retry* e *timeouts* mais rigorosos, expandindo a capacidade, diminuindo dependências e acelerando a migração para o Azure, que já gerencia 58% da carga da plataforma.
O Jenkins, pilar em automação de CI/CD, realizará seu Contributor Summit anual em formato virtual no dia 11 de setembro de 2026. O evento, um hackathon focado na comunidade, está programado para ocorrer das 08:30 às 19:30 CEST. Para acomodar a participação global, haverá duas sessões distintas: uma matinal, direcionada aos fusos horários APAC/EMEA, e outra vespertina para participantes das regiões EMEA/Américas, garantindo acessibilidade e colaboração entre desenvolvedores e entusiastas da plataforma.
O Octopus Healer, um bot prova de conceito, demonstra como a integração de IA pode revolucionar a gestão de incidentes. Ao invés de gerar comandos diretamente, ele processa alertas do Kubernetes e seleciona tipos de remediação predefinidos, preenchendo parâmetros de runbook com precisão. O Octopus Deploy é então utilizado para executar esses runbooks, mas somente após revisão e aprovação explícita por um operador via Slack. Essa abordagem inovadora mantém a trilha de auditoria e respeita as permissões existentes, garantindo segurança e controle operacional.
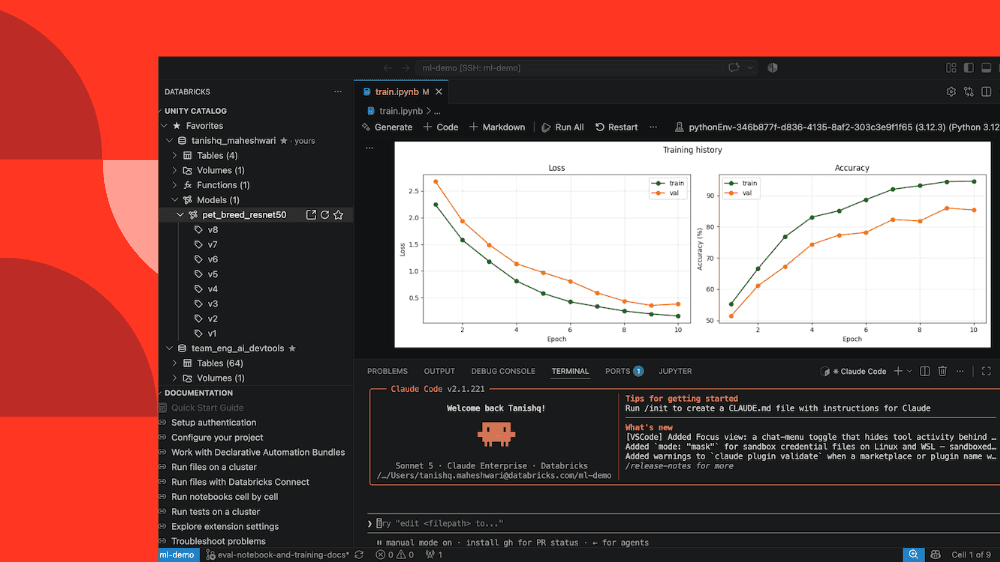
O Databricks anunciou recentemente uma atualização significativa em suas ferramentas de desenvolvimento, capacitando engenheiros a conectar ambientes de desenvolvimento integrados (IDEs) como VS Code, Cursor ou um terminal diretamente à infraestrutura computacional do Databricks. Essa integração é viabilizada por um novo túnel SSH, que promete simplificar a execução, depuração e escalonamento de cargas de trabalho diretamente do ambiente local de um desenvolvedor, otimizando o fluxo de trabalho e a produtividade.
O Amazon EC2, pilar da computação em nuvem, celebra hoje duas décadas de operação. Lançado em 2006 com a instância m1.small, em uma única região e modelo de faturamento por hora, o serviço evoluiu drasticamente. Atualmente, o EC2 oferece mais de 1.200 tipos de instância e está presente em 39 regiões globais, demonstrando sua adaptabilidade e impacto contínuo na arquitetura de infraestrutura como código e na escalabilidade de aplicações modernas.
O Octopus apresenta uma solução para orquestrar microsserviços em Kubernetes, permitindo que sejam implantados de forma independente. A abordagem utiliza um projeto pai com etapas de 'Deploy a Release' para coordenar implantações sequenciais ou paralelas em diferentes ambientes. Isso capacita as equipes a gerenciar o ciclo de vida de múltiplos serviços como uma unidade coesa, sem abrir mão da flexibilidade de implantação individual para cada serviço, otimizando a entrega contínua.
O Google anunciou a integração de seu Protocolo Agent2Agent (A2A) à Agentic AI Foundation (AAIF), uma iniciativa que busca estabelecer padrões abertos para a comunicação entre agentes de IA de diferentes fornecedores. A mudança, que ocorre em conjunto com o ecossistema MCP (Multi-Agent Communication Protocol), projeto da Linux Foundation , , visa fomentar a interoperabilidade e expandir o alcance das aplicações baseadas em IA, garantindo que agentes desenvolvidos por distintas empresas possam interagir de forma padronizada e eficiente.
A diretriz BOD 26-04 da CISA (Cybersecurity and Infrastructure Security Agency) estabelece um novo paradigma para a gestão de vulnerabilidades em agências federais, focando na priorização baseada no risco real, em detrimento das classificações estáticas de severidade. Neste contexto, as ferramentas do Datadog ganham destaque como aliadas estratégicas, capacitando equipes a identificar e remediar de forma eficiente as falhas críticas, alinhando-se aos objetivos da CISA de fortalecer a segurança cibernética.
Mesmo com o avanço das LLMs prometendo otimizações de performance mais acessíveis, o custo de implementação raramente é a barreira principal para a lentidão persistente de softwares. Equipes tendem a tolerar sistemas mais lentos, priorizando outros aspectos ou enfrentando altos custos em testes, migração, correção e manutenção. Adicionalmente, as otimizações geradas por IA, embora rápidas, podem apresentar benchmarks superestimados ou introduzir problemas de confiabilidade, mostrando que a velocidade na geração de código não garante necessariamente um software de produção mais veloz e estável.
Apesar do potencial de agentes de IA autônomos para resolver incidentes rotineiros de forma eficiente, sua capacidade de executar ações operacionais em ambientes complexos introduz novos vetores de falha. O cenário mais crítico surge quando um agente de IA tenta corrigir um problema de maneira imprevista, escalando uma interrupção já desafiadora antes da intervenção humana. Isso força as equipes de resposta a diagnosticar não apenas a falha do sistema original, mas também o comportamento inesperado do próprio agente, evidenciando a necessidade de robustez e supervisão em sistemas de IA na gestão de incidentes.
Uma falha de rede na região Oeste dos EUA do Azure, em 23 de julho, resultou em uma interrupção de aproximadamente cinco horas, desencadeada por um reparo que isolou um número inesperado de dispositivos. A análise pós-incidente revela que a causa raiz incluiu falhas na avaliação do "blast radius", validação insuficiente da "aggregate safety", telemetria enganosa, logs de eventos incompletos e automação de rollback ineficaz devido à dependência da própria conectividade comprometida. O incidente sublinha a importância de estratégias robustas de resiliência e observabilidade para infraestruturas de nuvem.
A DigitalOcean aprimorou seu Inference Router com a introdução do roteamento sensível a cache. O sistema agora avalia o impacto financeiro de invalidar um cache "quente" de prompt ao decidir a troca de modelo durante uma sessão. Para tal, foram adicionados dois novos controles: um cabeçalho de afinidade de modelo explícito, que vincula requisições a uma sessão específica, e um parâmetro de orçamento de roteamento, limitando o custo adicional gerado por uma eventual mudança de modelo. Essa funcionalidade visa otimizar a performance e o custo-benefício em operações de IA.