
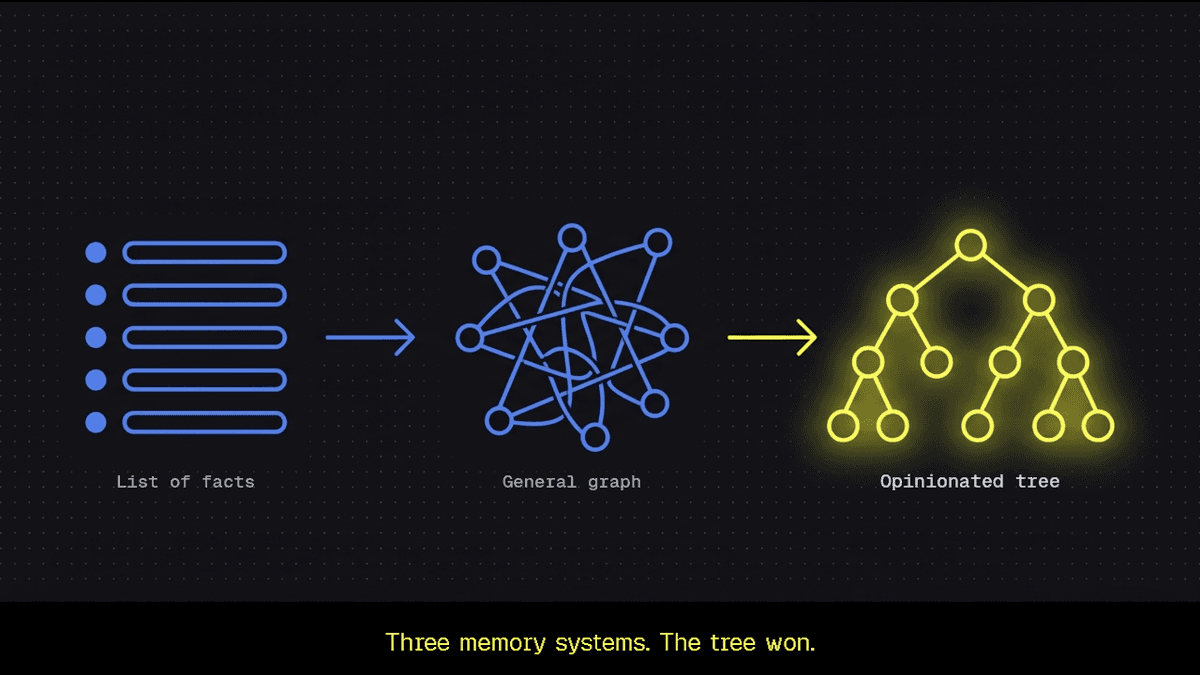
Tiger Data testou três sistemas de memória para seu agente do Slack, e o mais expressivo não foi o mais útil
Aprofundamento CEVIU
Aprofundamento
A Tiger Data construiu três sistemas de memória para o Eon, o agente de Slack usado internamente, e o problema central foi sempre o mesmo: colocar a informação certa no contexto e deixar o resto de fora. Na prática, era um problema de busca. O primeiro sistema, o tiger-memory-mcp-server, tinha quatro operações (remember, recall, update e forget), memórias por usuário e o recall devolvia a lista inteira, relevante ou não. Poucos usuários avançados chegaram a usá-lo.
O segundo foi um knowledge graph em duas tabelas Postgres, node e edge, com metadados em JSONB, tempo de evento e busca BM25 via pg_textsearch. As arestas viraram problema: agentes usaram chaves diferentes para o mesmo atributo, ou nem criaram arestas. Com acesso a SQL arbitrário, os agentes gastavam dezenas de turnos só para integrar o resumo de uma thread. O terceiro sistema trocou o grafo por uma árvore com a extensão ltree, uma tabela só e caminhos como share.projects.my_coding_project, com índice GiST. Integrar um resumo passou a custar, em geral, uma chamada de ferramenta. Permissões de leitura, escrita e dono se aplicam ao caminho e valem para toda a subárvore. A busca é híbrida: BM25, embeddings com índice HNSW e Reciprocal Rank Fusion.
A árvore tem limites, que a própria Tiger Data reconhece: cada memória ocupa um único lugar, as únicas relações são ancestral e descendente, e a hierarquia tende a seguir quem precisa de acesso, não a relação entre as informações. Outras relações ficam nos metadados, como prev_id e next_id nos experimentos com LoCoMo. Sem chave estrangeira, um ponteiro pode apontar para memória apagada, o que a empresa trata como perda de contexto, não de dados. Times internos (dados, marketing, engenharia) passaram a usar o sistema como backend de RAG, e a parte reutilizável virou o searchgres.js, biblioteca TypeScript de código aberto.
Por que isso importa
Para quem modela dados para agentes, a lição é sobre fronteira de decisão. Um modelo expressivo, como um grafo, joga para o agente escolhas de semântica que ele não faz de forma consistente. Uma estrutura restrita, com caminho explícito, reduz o custo em tokens e turnos. Se o seu caso é RAG com regras de acesso próprias, o desenho do searchgres.js sugere manter a política de permissão na aplicação e deixar o filtro para a camada de busca.
Perguntas frequentes
Por que o knowledge graph não funcionou bem para o agente?
Os agentes tinham que decidir o que cada aresta significava, quais criar e quando segui-las. Isso gerou metadados inconsistentes e arestas ausentes. Definir a semântica no prompt ajudou, mas ainda dependia de suposições sobre o que melhoraria a recuperação.
O que o ltree do Postgres faz nesse sistema?
Ele representa a hierarquia como caminhos, como share.projects.my_coding_project, e um índice GiST permite consultar subárvores, ancestrais e padrões de caminho. Buscar sob um caminho dispensa CTEs recursivas. Mover, copiar ou apagar memórias por caminho vira chamada de ferramenta simples.
Como funciona a busca híbrida da Tiger Data?
Combina busca por palavra-chave BM25 com busca semântica por embeddings indexados em HNSW. Os dois resultados são unidos com Reciprocal Rank Fusion. O searchgres.js adiciona filtros por hierarquia, metadados e tempo.
O que é o searchgres.js?
É uma biblioteca TypeScript de código aberto para busca híbrida com filtros compostos em PostgreSQL. Cuida das operações de registro e da recuperação, incluindo fila, retentativas e verificação de versão de embeddings. Usuários, permissões e fluxos ficam por conta da aplicação.
Fontes
- tigerdata.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 26 de outubro de 2026
- Editoria
- CEVIU Dados