
LinkedIn reconstrói infraestrutura de tracking e reduz uso de rede de entrada em cerca de 89%
Aprofundamento CEVIU
Aprofundamento
O Tracking API é a porta de entrada de um pipeline de eventos que o LinkedIn descreve como capaz de processar centenas de bilhões de eventos por dia, com milhões por segundo nos picos e várias centenas de tipos de evento. Os SDKs de mobile e web agrupam as interações em lotes, a camada de borda roteia cada lote para o serviço da categoria certa, e o serviço decodifica, valida, enriquece, classifica, converte e envia os registros ao Kafka pelo produtor assíncrono. O gRPC de sucesso volta assim que o cliente Kafka aceita o registro no buffer local, sem esperar o broker. Por isso, sucesso numa fronteira não prova sucesso na seguinte.
O ganho de rede veio principalmente do contrato novo, que envia o contexto compartilhado de cliente e sessão uma vez por requisição, em vez de repetir em cada evento. Nas janelas observadas, o tráfego de entrada médio caiu de 210,7G para 21,7G (cerca de 89,7%). Como o serviço novo carregava 90% do tráfego, o ajuste para tráfego total deixa a redução perto de 89%. O resultado combina reuso de contexto, Protocol Buffers e outras mudanças de serialização.
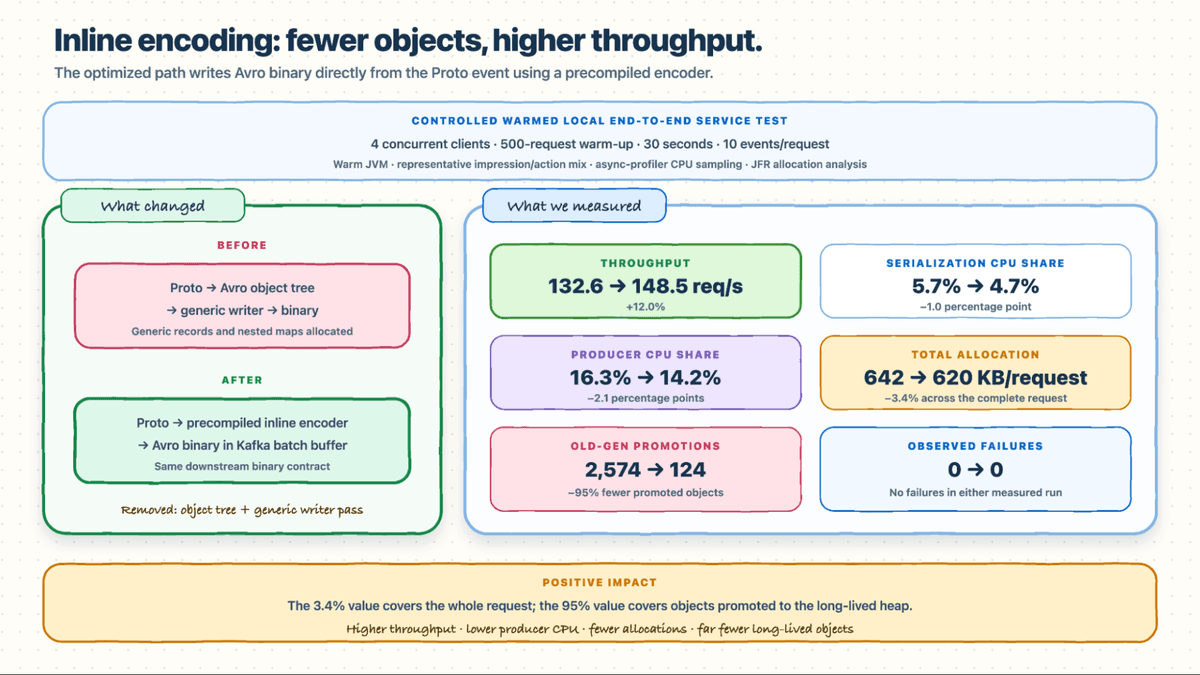
A validação usou uma amostra marcada de 10% dos eventos. O pipeline legado seguia gravando no tópico de produção, e o novo escrevia em um tópico sombra, com jobs que casavam os registros por identificador de comparação. Duplicar 100% do tráfego foi descartado pelo custo. Na otimização, a equipe trocou a conversão intermediária para objetos Avro por um encoder inline pré-compilado e passou a compressão do Kafka de gzip para zstd. Em benchmarks locais, o encoder deu 12% a mais de throughput e o zstd 13,7%, mas os ganhos não se somam, e a própria equipe os trata como sinais direcionais, não como capacidade de produção.
Por que isso importa
Para quem opera pipelines de ingestão, o caso mostra um roteiro reaproveitável: comparar saída com amostra marcada em tópico sombra, migrar por plataforma e categoria com rollback por roteamento, e perfilar sob concorrência real. Também lembra que o gargalo de um serviço ingestor costuma ser CPU, e não I/O, o que muda a escolha de codec e de serialização. A parte sobre transformar falhas tardias do Kafka em backpressure é a que mais interessa a quem usa produtores assíncronos.
Perguntas frequentes
Por que o LinkedIn reconstruiu o pipeline em vez de refatorar?
A mudança envolvia novo contrato de requisição, outro caminho de serialização e outro modelo de deploy. Fazer isso por etapas dentro do único serviço em produção misturaria premissas antigas e novas por muito tempo. Um destino paralelo permitiu comparar saídas e voltar atrás só pelo roteamento.
Como a redução de cerca de 89% no uso de rede de entrada foi obtida?
O novo contrato envia o contexto de cliente e sessão uma vez e o reaproveita entre os eventos, em vez de repetir em cada um. Isso vem junto com Protocol Buffers e mudanças relacionadas de serialização. A medição foi de 210,7G para 21,7G, ajustada para tráfego total.
Como a equipe validou a migração sem duplicar todo o tráfego?
Enviou 10% dos eventos elegíveis pelos dois pipelines, cada um com um identificador de comparação. O legado gravava no tópico de produção e o novo, em um tópico sombra. Qualquer diferença sem explicação bloqueava o avanço daquela fatia.
Por que trocar gzip por zstd no produtor Kafka?
O caminho de compressão gzip em Java consumia muita CPU. O zstd tem implementação nativa mais rápida e razão de compressão parecida para esses eventos. Em benchmark local, subiu o throughput em 13,7%, e os brokers e clientes downstream já o suportavam.
Fontes
- linkedin.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 26 de outubro de 2026
- Editoria
- CEVIU Dados