
Apache Parquet Aprimora Compressão de Dados com Nova Codificação ALP
Aprofundamento CEVIU
Aprofundamento
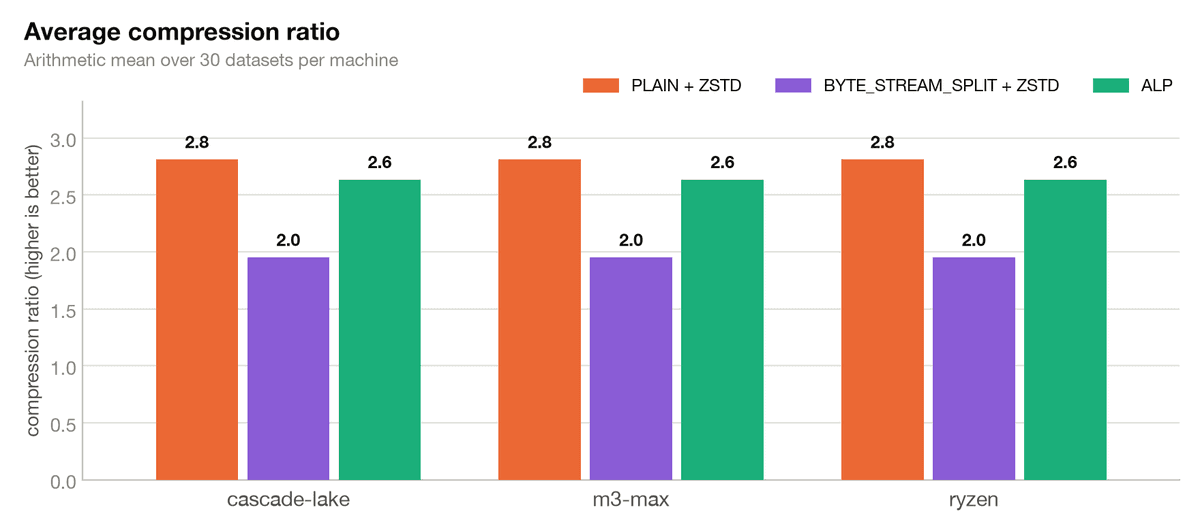
O Apache Parquet, um dos pilares do armazenamento colunar no universo de dados, integra agora o Adaptive Lossless Floating-Point (ALP), uma técnica inovadora para codificar dados de ponto flutuante. Esta nova codificação se destaca por manter uma taxa de compressão similar à do ZSTD, mas com uma velocidade de decodificação dez vezes maior. Isso é um avanço para dados que exigem alta precisão, como valores monetários, coordenadas geográficas e medições científicas.
O ALP resolve desafios antigos de compressão de ponto flutuante, que antes dependia de compressores “pesados” (como ZSTD) sobre encodings como PLAIN ou BYTE_STREAM_SPLIT. A limitação estava na lentidão da decodificação, dificuldade de acesso aleatório a valores específicos e pouca paralelização. A nova codificação ALP atua diretamente nesse gargalo, permitindo que cada valor seja armazenado como um inteiro dentro de “vetores” com parâmetros compartilhados, garantindo acesso rápido e decodificação eficiente, inclusive com processamento paralelo amigável a GPUs e SIMD.
O que mudou
Antes do ALP, a compressão de dados de ponto flutuante no Apache Parquet dependia de codecs gerais como o ZSTD, aplicados sobre encodings mais simples. Embora eficazes na redução de tamanho, esses métodos comprometiam drasticamente a velocidade de decodificação e o acesso aleatório a valores específicos. A decodificação de um único valor muitas vezes exigia processar toda uma página de dados, e a natureza variável da compressão dificultava a paralelização.
Com a introdução do ALP, o Parquet agora oferece uma codificação intrínseca que não apenas comprime de forma eficiente, mas também acelera a decodificação em até dez vezes e aprimora significativamente o acesso aleatório. Essa mudança representa uma evolução direta na forma como dados numéricos precisos são armazenados e consultados, permitindo operações de análise muito mais ágeis sem o trade-off de compressão.
Por que isso importa
A adição do ALP ao Apache Parquet é um marco para engenheiros de dados e cientistas que trabalham com grandes volumes de dados de ponto flutuante. Setores como finanças, geoprocessamento e pesquisa científica, que dependem da precisão de números decimais, verão ganhos substanciais na performance de suas pipelines de dados. A capacidade de decodificar dados mais rapidamente significa consultas mais ágeis e análises em tempo real aprimoradas, traduzindo-se em decisões de negócios mais rápidas e eficientes.
Além disso, a otimização para acesso aleatório e decodificação paralela reduz a latência em operações de leitura e permite melhor aproveitamento de hardware moderno, como SIMD e GPUs. Este aprimoramento reforça a posição do Parquet como um formato de arquivo de escolha para ecossistemas de big data, continuando a atender às crescentes demandas por eficiência e performance.
Linha do tempo
Lançamento do parquet-format 2.14.0, incluindo suporte à codificação ALP.
Notícia atual: Apache Parquet aprimora compressão de dados com nova codificação ALP.
Perguntas frequentes
Qual o principal benefício do Adaptive Lossless Floating-Point (ALP) no Apache Parquet?
O ALP oferece compressão de dados de ponto flutuante com taxas similares a compressores como ZSTD, mas com uma velocidade de decodificação até dez vezes maior. Ele também otimiza o acesso aleatório a valores e facilita a decodificação paralela, acelerando significativamente o processamento de dados.
Que tipos de dados se beneficiam mais da nova codificação ALP?
Dados decimais armazenados como FLOAT ou DOUBLE são os maiores beneficiados, incluindo valores monetários (câmbios, preços), coordenadas geográficas (latitude, longitude) e medições científicas (temperatura, pressão). Para embeddings de vetor, que usam uma gama completa de ponto flutuante, outras abordagens ainda são mais adequadas.
Como o ALP se diferencia das abordagens anteriores de compressão no Parquet?
Antes do ALP, o Parquet usava encodings como PLAIN ou BYTE_STREAM_SPLIT, geralmente seguidos por compressores pesados como ZSTD. Essa abordagem resultava em decodificação lenta e acesso ineficiente a valores individuais. O ALP é uma codificação leve e especializada que integra a compressão e otimiza a performance de forma nativa para esses tipos de dados.
O que era usado antes para compactar dados de ponto flutuante no Parquet?
Anteriormente, dados de ponto flutuante no Parquet eram tipicamente armazenados com codificações PLAIN ou BYTE_STREAM_SPLIT. Para obter compressão, era necessário aplicar algoritmos gerais e mais pesados, como ZSTD, em uma etapa separada. Essa combinação, embora reduzisse o tamanho, gerava gargalos de performance na leitura dos dados.
Fontes
- parquet.apache.orgfonte original
- Categoria
- CEVIU Dados
- Publicado
- 28 de setembro de 2026
- Editoria
- CEVIU Dados