O sistema de anúncios do ChatGPT usa um LLM pós-treinado para orquestrar retrieval, ranking, verificações de relevância e leilões, acompanhando a evolução da intenção do usuário ao longo das conversas. Sessões de anúncios com estado (stateful) preservam o contexto. Já modelos, serviços e código separados mantêm a seleção de anúncios fora do caminho de geração de respostas do ChatGPT.
Os maiores clientes da OpenReplay ingerem bilhões de eventos e cerca de 6 TB por dia em uma única instância do ClickHouse, com consultas em menos de um segundo. Ao tirar a análise comportamental do Postgres, a empresa também substituiu limpezas de retenção que causavam interrupções por regras de TTL e simplificou os pipelines de dados com materialized views.
O tldraw converte os vértices das shapes para coordenadas da página e, em seguida, usa os valores mínimo e máximo para calcular bounding boxes alinhadas aos eixos. O passo a passo, publicado no blog do tldraw, cobre transforms aninhadas e handles de seleção rotacionados. Bounds aproximados funcionam como filtro de candidatos antes de verificações de geometria mais custosas.
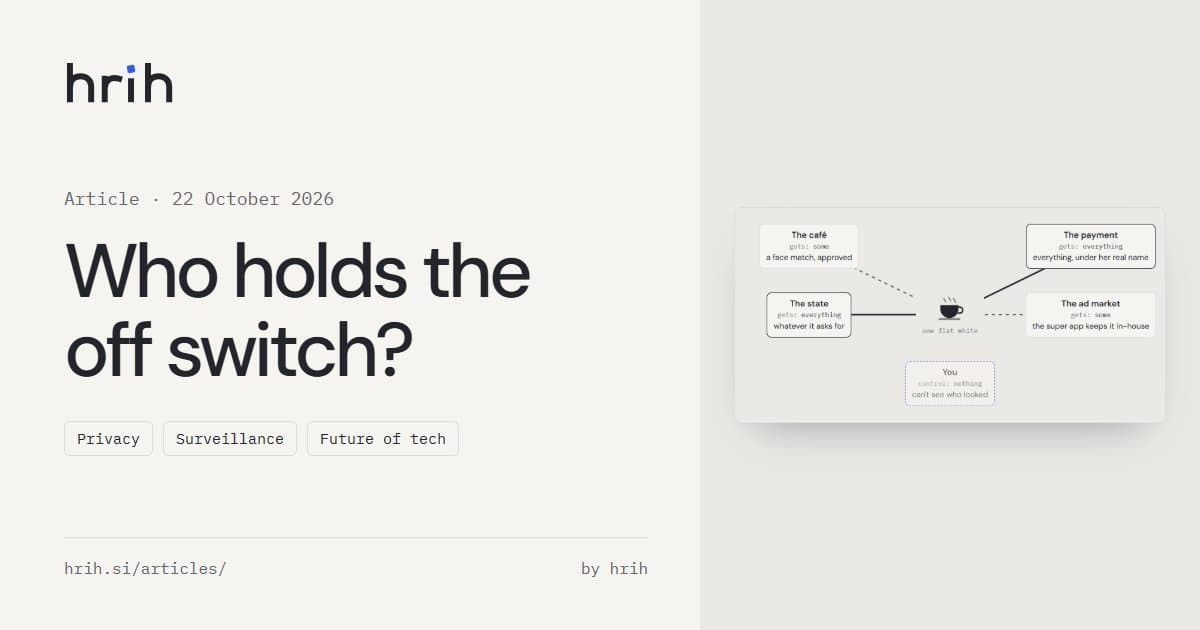
Um artigo publicado no hrih.si imagina cinco compras de café em 2035 para ilustrar diferentes modelos de controle de dados: vigilância estatal, regulação de privacidade, mercados comerciais de dados, infraestrutura pública e identidade biométrica. A privacidade, segundo o texto, depende cada vez mais de quem consegue interromper a coleta. Assistentes de IA e planos pagos de privacidade tendem a tornar essa questão ainda mais urgente.
Os navegadores modernos já oferecem criptografia, código com desempenho nativo, gráficos e áudio. Ao mesmo tempo, a IA facilita o uso desses recursos por indivíduos. Com a queda nos custos de desenvolvimento e hospedagem, a criação de software pessoal pode crescer e desafiar a economia das app stores.
A confiança declarada por um LLM é texto gerado. Por isso, um número com aparência precisa não deve ser tratado como medida calibrada de acerto. A alternativa proposta é derivar os scores a partir de evidências observáveis e de resultados históricos, verificando a calibração com regularidade nos mesmos tipos de tarefa.
Avaliar de forma confiável tarefas abertas executadas por agentes exige combinar julgamentos humanos calibrados, juízes automatizados ou rubricas e monitoramento em produção. Para separar melhorias reais de ruído, ajudam a análise de poder estatístico, os intervalos de confiança e as execuções repetidas. Já os benchmarks continuam úteis quando usam tarefas realistas e diversificadas e incorporam o feedback da produção.
O Jalapeño, chip de inference da OpenAI, liga 64 núcleos dedicados a bancos individuais de memória HBM, com o objetivo de reduzir a movimentação de dados e melhorar a utilização. A entrevista explica o tradeoff em complexidade de gerenciamento de memória, a escolha de manter prefill e decode em hardware fungível e como a otimização assistida por IA acelerou o design do chip e o desenvolvimento de kernels.
A desaceleração do scaling de transistores, os gargalos de memória e os limites de energia estão reforçando o argumento a favor de hardware especializado para inference de IA. Associar diferentes fases da inference a diferentes aceleradores pode melhorar o desempenho por watt, mas aumenta a complexidade de deployment e de software. Há ainda a possibilidade de as GPUs absorverem as ideias que derem certo, o que mantém o cenário em aberto para quem desenvolve.
A Railway informou que pode ter havido acesso não autorizado a variáveis de ambiente de clientes, incluindo parte de conteúdos descriptografados. A empresa recomenda que os desenvolvedores rotacionem os secrets armazenados e as credenciais de private registry, além de revisarem os logs dos serviços.
Os frontier models da OpenAI e os workflows do Codex estão chegando ao Model Garden do Google Cloud. Para quem desenvolve, a novidade amplia as opções de acesso a esses modelos dentro do ecossistema do Google Cloud.
Narrar o próprio raciocínio em voz alta pode ajudar na resolução de problemas. O exercício expõe suposições, organiza dependências, torna as regras explícitas e deixa mais claras as escolhas para fazer backtracking.