Um novo conceito de prova demonstra a implementação de segurança em nível de linha para Dashboards Claude, garantindo que usuários visualizem apenas dados autorizados. Utilizando um servidor Model Context Protocol (MCP) para autenticação e o DuckDB para consultas, as regras de acesso são aplicadas previamente, filtrando informações antes mesmo de chegarem ao Claude. Essa abordagem permite que um único dashboard apresente visualizações personalizadas para diferentes usuários, reforçando a governança de dados e a confidencialidade das informações.
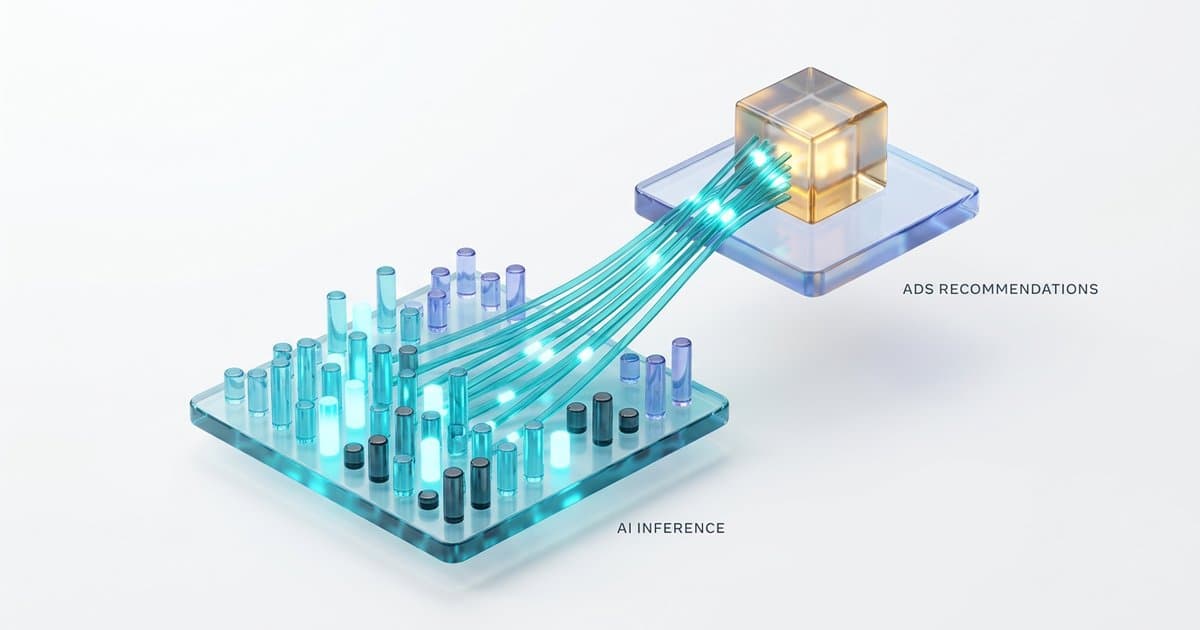
A Meta está implementando uma estratégia engenhosa para refinar as recomendações de anúncios, utilizando a capacidade computacional ociosa de sua infraestrutura de IA. Este recurso permite que a empresa processe um volume maior de classificações de anúncios ou direcione requisições para modelos mais sofisticados, resultando em publicidade mais relevante para os usuários. A abordagem inclui um mecanismo de fallback robusto: caso a capacidade extra não esteja disponível, o sistema prontamente ajusta a carga de trabalho, garantindo que a performance e a confiabilidade dos serviços principais não sejam comprometidas. É uma aplicação prática de otimização de recursos em grande escala.
O GitHub aprimorou a API de histórico de estrelas, permitindo o fornecimento de contagens diárias sem revelar a identidade dos usuários. Esta otimização impactante reduziu o número de requisições React de aproximadamente 2.500 para apenas 24 no histórico completo de estrelas de um repositório. A melhoria foi alcançada filtrando estrelas por data antes da contagem, diminuindo significativamente a carga sobre o banco de dados e eliminando o processamento repetitivo, um avanço notável em arquitetura de dados.
Atualizar versões do PostgreSQL pode ser um desafio, mas a replicação lógica surge como uma solução robusta para minimizar o tempo de inatividade. Uma demonstração prática, utilizando Docker, exibiu a coexistência de clusters antigos e novos. O processo permitiu uma transição suave, com interrupção de escrita de apenas 181 ms durante a atualização e 179 ms para rollback, garantindo a integridade dos dados e uma janela mínima de indisponibilidade, demonstrando a viabilidade de atualizações contínuas em ambientes críticos.
O Airbnb está revolucionando a busca em linguagem natural, especialmente no desafio do 'cold-start', com seu sistema inovador CASTLE. A plataforma supera a falta de dados reais iniciais gerando sinteticamente consultas e rótulos de relevância a partir de sessões de reserva desidentificadas. As consultas sintéticas do CASTLE demonstraram um alinhamento superior aos padrões de busca dos usuários em comparação com métodos tradicionais, e os rótulos de relevância do sistema obtiveram mais de 90% de concordância em avaliações humanas. Essa abordagem exemplar destaca como dados comportamentais, sob governança rigorosa, podem 'impulsionar' o treinamento de sistemas de busca antes mesmo de um volume significativo de tráfego ser alcançado, otimizando a experiência do usuário desde o primeiro dia.
No universo do PostgreSQL, discussões sobre micro-otimizações raramente se traduzem em ganhos reais de desempenho. Para consultas com milhares de IDs, o uso de 'IN', 'ANY' ou 'VALUES' em junções demonstra performance praticamente idêntica; a sugestão é focar em 'ANY' com parâmetros para estabilizar o plano de execução da query. Da mesma forma, tipos de dados como textos curtos, ENUMs e SMALLINTs exibem consumo de armazenamento quase idêntico, enquanto colunas com predominância de NULLs são inerentemente eficientes. A melhor prática é evitar reescritas de código desnecessárias e sempre validar o impacto com 'EXPLAIN' sobre os dados em produção.
A Cloudflare revelou uma série de estratégias eficazes para mitigar o crescimento exponencial de seu hardware, focando em encolher dados em estágios iniciais do processamento e adiar a duplicação. A empresa adotou abordagens como a segmentação de esquemas monolíticos, a transição para o algoritmo de compressão Zstd, o envio único de cada evento e a replicação de dados apenas após a amostragem. Também se destacam a amostragem na borda da rede e a pré-agregação de consultas recorrentes. A filosofia central é otimizar bytes em vez de apenas recursos computacionais, podando campos, comprimindo cargas de trabalho e promovendo reduções upstream, além de replicar dados já compactados. Estas iniciativas demonstram um compromisso com a eficiência de custos e recursos em larga escala.
A Anthropic, gigante em pesquisa de IA, anunciou a substituição do Git pelo Scion, um sistema de controle de versão próprio, desenvolvido em apenas cinco meses. A decisão veio após o volume de merges diários disparar de 2.500 para mais de 30.000, demandando uma solução mais robusta. Com a migração das operações para servidores e a otimização na busca por arquivos, a empresa reporta checkouts até 100 vezes mais rápidos e uma redução de 200 vezes nos requisitos de CPU e memória, marcando um avanço significativo na gestão de código para projetos de IA em larga escala.
Um benchmark recente conduzido por Daniel Lemire demonstra um avanço notável no processamento de JSON em Python. Utilizando a biblioteca fastsimdjson em um ambiente Python free-threaded com 64 cores, foi possível processar 7,6 GB de dados JSON em aproximadamente 0,12 segundos, alcançando uma impressionante taxa de 66 GB/s. Esse desempenho é atribuído à execução paralela de threads e à criação seletiva de objetos Python, focando apenas nos campos essenciais, otimizando o consumo de recursos e a velocidade de processamento.
Em uma recente avaliação com 168 questões, o sistema Jev demonstrou superioridade significativa sobre a busca por embeddings na recuperação de informações para Grandes Modelos de Linguagem (LLMs). O Jev acertou a página correta em 88% das primeiras tentativas, em comparação com 70% dos métodos de embeddings. Além disso, a ferramenta reduziu drasticamente o volume de informações irrelevantes para a IA, de 33% para apenas 3%, ao optar por responder "nenhum" quando nenhuma página se mostrava adequada, otimizando a qualidade da entrada para os LLMs.
O PostgreSQL emprega uma técnica engenhosa chamada TOAST (The Oversized-Attribute Storage Technique) para lidar eficientemente com valores de dados extensos. Este mecanismo crucial compacta atributos grandes ou os reloca para tabelas auxiliares, garantindo uma otimização significativa tanto no armazenamento físico quanto no desempenho geral do banco de dados, impactando diretamente a performance de consultas e operações de dados.