
Jev supera busca por embeddings e aprimora entrega de conteúdo a LLMs
Aprofundamento CEVIU
Aprofundamento
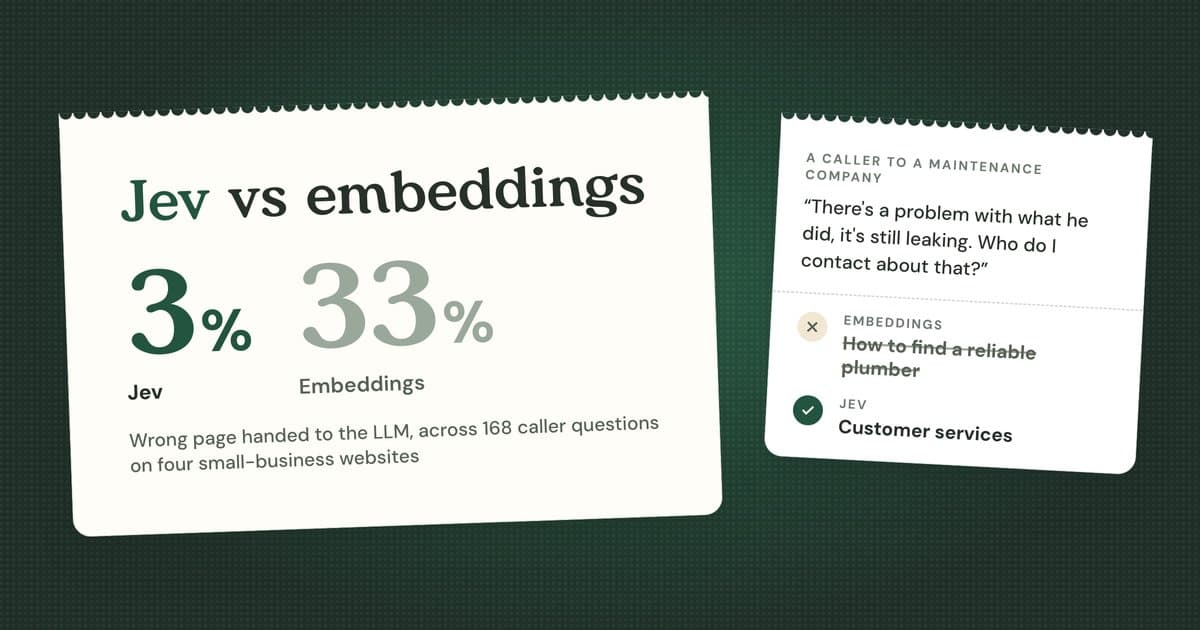
A mais recente avaliação do sistema Jev no contexto de Geração Aumentada por Recuperação (RAG) para Grandes Modelos de Linguagem (LLMs) revela uma abordagem técnica diferenciada e superior. Em vez de depender da fragmentação de conteúdo e da busca por similaridade vetorial (embeddings), Jev opera como um modelo de decisão que preserva a estrutura original de uma página web. Ele recebe descrições concisas das páginas e a consulta do usuário, escolhendo a página mais relevante ou explicitamente indicando que não há resposta adequada no site. Essa estratégia, em vez de fatiar documentos em pedaços e confiar na similaridade de cossenos, explora a inteligência curatorial humana já embutida na organização de um site.
A metodologia de Jev simula um processo de tomada de decisão, onde cada página do site (e a opção de 'nenhuma') é uma alternativa. Isso garante que o LLM receba contexto preciso e minimiza a probabilidade de processar informações irrelevantes ou de guias genéricos que, por similaridade de texto, poderiam ser erroneamente selecionados por embeddings. A sua capacidade de decidir 'nenhum' quando não há correspondência explícita representa um ganho técnico fundamental para a confiabilidade das interações dos LLMs, funcionando como um guarda-chuva contra "alucinações" geradas por contexto inadequado.
O que mudou
A cobertura anterior do CEVIU já explorava Jev como um classificador de nova geração e uma ferramenta para guardrails em LLMs, como nas matérias de 30 de setembro de 2026 e 24 de setembro de 2026. Também destacamos seu desempenho superior em correspondência de vagas e resolução de identidades, conforme noticiado em 8 de outubro de 2026. A novidade agora é a aplicação prática de Jev como um componente crítico na pipeline de RAG, indo além da validação e classificação para atuar diretamente na recuperação de informações. Enquanto embeddings dominavam essa função, Jev demonstrou uma evolução substancial, superando-os e fornecendo uma solução mais inteligente para o problema de contexto irrelevante. A matéria 'LLM Compacto Aprimora RAG e Otimiza Contexto com Alta Precisão', de 11 de julho de 2026, discutia a necessidade de um LLM compacto para otimizar o RAG; Jev agora oferece uma maneira eficaz de alcançar essa otimização na fonte de dados.
Por que isso importa
Para devs e engenheiros de dados, a ascensão de Jev na recuperação de informações significa um avanço significativo na construção de sistemas RAG mais robustos e confiáveis. A capacidade de Jev de reduzir drasticamente o fornecimento de contexto irrelevante para LLMs, passando de 33% para 3%, tem um impacto direto na qualidade das respostas e na experiência do usuário final. Isso minimiza a ocorrência de "alucinações" e respostas imprecisas por parte dos LLMs, que podem ocorrer quando o modelo recebe informações ambíguas ou errôneas. Além disso, a eficiência no custo por consulta de Jev, mesmo com websites maiores, o posiciona como uma alternativa economicamente viável para escalar aplicações que dependem de RAG para interações com clientes ou processamento de informações.
A habilidade de Jev em identificar quando uma pergunta não tem resposta no site (respondendo "nenhum") é crucial para a governança de dados e para a identificação de lacunas de conteúdo. Isso não só melhora a precisão do LLM, mas também oferece insights valiosos para os proprietários de websites sobre quais informações precisam ser adicionadas ou atualizadas. É um passo importante para otimizar pipelines de dados, garantindo que o contexto fornecido aos LLMs seja sempre o mais limpo e relevante possível, elevando o padrão de confiança nas soluções de IA.
Linha do tempo
CEVIU reporta LLM Compacto Aprimora RAG e Otimiza Contexto com Alta Precisão
CEVIU destaca Jev Otimiza Extração de Dados 10-K com Validação de Baixo Custo
CEVIU cobre TypeSafe Jev: Guardrails para LLMs em Tempo Real com Alta Performance
CEVIU publica Jev e a Nova Geração de Classificadores: Otimizando Decisões com IA e Reduzindo 'Hallucinations'
CEVIU noticia Jev Supera OpenAI e Gemini em Correspondência de Vagas com IA
CEVIU reporta Jev Desafia Modelos de IA Líderes em Resolução de Identidades
Jev supera busca por embeddings e aprimora entrega de conteúdo a LLMs
Perguntas frequentes
O que é o sistema Jev e como ele se diferencia de um LLM tradicional?
Jev é um modelo de decisão, não um LLM gerador de texto. Ele é projetado para fazer escolhas precisas entre um conjunto de opções fornecidas, como selecionar a página mais relevante em um site ou determinar a ausência de uma resposta. Ao contrário de um LLM que gera texto livre, Jev retorna uma opção com uma probabilidade, focando em decisões estruturadas e tipadas.
Qual o principal problema que Jev resolve para LLMs no contexto de recuperação de informações (RAG)?
O principal problema que Jev aborda é a alimentação de contexto irrelevante para LLMs. Enquanto métodos baseados em embeddings podem erroneamente selecionar páginas genéricas por similaridade, Jev escolhe o conteúdo mais preciso ou, crucialmente, indica quando o site não possui a resposta, prevenindo "alucinações" e respostas imprecisas dos LLMs.
Por que os embeddings tradicionais podem falhar na busca de informações em websites para LLMs?
Embeddings tradicionais, ao fragmentar o conteúdo e usar similaridade de cossenos, podem ser enganados por termos em guias genéricos ou blogs que não são específicos do negócio. Isso leva à seleção de conteúdo menos relevante que, por ter mais palavras em comum com a consulta, é erroneamente priorizado, resultando em contexto inadequado para o LLM.
Jev substitui completamente os embeddings em uma arquitetura de RAG?
Não necessariamente. A pesquisa demonstra que a combinação de Jev com embeddings pode trazer os melhores resultados. Embeddings são bons em criar uma lista de candidatos ("em algum lugar por aqui"), enquanto Jev se destaca em fazer a escolha precisa entre eles ("esta aqui"). Essa abordagem híbrida pode otimizar ainda mais a recuperação de informações.
Fontes
- sayora.aifonte original
- Categoria
- CEVIU Dados
- Publicado
- 15 de outubro de 2026
- Editoria
- CEVIU Dados