
Renderizador de texto para microcontroladores usa JIT para gerar código de máquina a cada string
Aprofundamento CEVIU
Aprofundamento
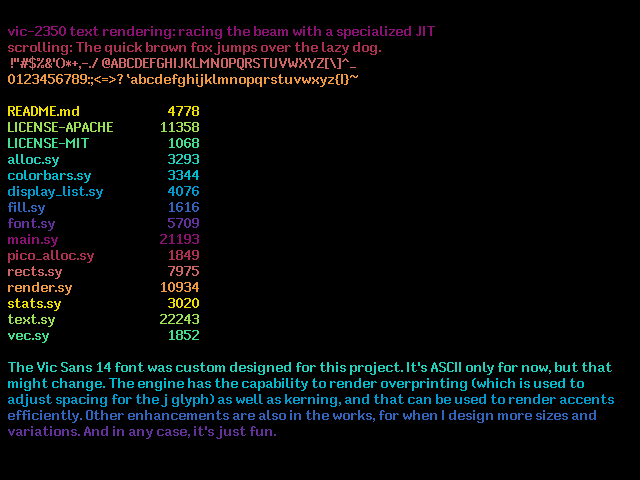
O projeto é o vic-2350, uma releitura de um computador doméstico dos anos 80 numa placa com o microcontrolador RP2350. Raph Levien escolheu fontes bitmap com espaçamento proporcional e kerning. O desafio é o orçamento: o renderizador "corre atrás do feixe" (race the beam), preenchendo o buffer de vídeo a cada scanline, com cerca de 6 ciclos por pixel. O chip tem só 520 kB de SRAM, o que torna um framebuffer completo caro em resolução ou profundidade de cor.
A solução é um JIT que, no método start do objeto de texto, expande a string em código de máquina. Esse código preenche um buffer intermediário de 1 bit por pixel, e uma segunda passada o converte para RGB565 a 1,75 ciclo por pixel. A fonte fica empacotada em SRAM: nenhum glifo cruza um limite de 32 pixels, então uma linha da fonte sai com um único load de 32 bits. A detecção de sobreposição derrubou o bitmap de 1140 para 960 bytes. O instruction scheduling move a última instrução do glifo i para depois do ldr do glifo i + 1, cortando o custo de 4 para 3 ciclos. O laço básico custa 23 ciclos por glifo para o JIT mais 3 ciclos vezes a altura. No textdemo, são cerca de 21 mil ciclos de JIT e 42 mil de execução, uns 2,6% de um núcleo. O código gerado é cerca de 10 vezes maior que a string, e por isso não é cacheado. O renderizador está em symbolasm, linguagem do autor para Cortex-M33, pois Rust não atingiu o desempenho exigido.
Por que isso importa
Para quem trabalha com sistemas embarcados ou código sensível a desempenho, o caso mostra que gerar código por entrada pode ser mais barato do que um laço genérico quando os dados são conhecidos em tempo de execução, mas fixos durante o desenho. A escolha de não cachear o JIT é uma lição de troca: memória vale mais que ciclos quando o custo de regenerar é desprezível. Na leitura editorial, o kerning por produto escalar de bitvectors também é uma ideia reaproveitável fora desse nicho.
Perguntas frequentes
Por que usar JIT para renderizar texto num microcontrolador?
Com espaçamento proporcional, um laço comum gasta muito tempo calculando deslocamentos e tratando glifos que cruzam o limite de 32 bits. O JIT resolve isso uma vez por string e gera código sem desvios desnecessários. Implementações anteriores no pico-dvi-rs tinham dificuldade em exibir uma tela cheia de texto.
Quanto custa o renderizador em ciclos?
O laço básico gasta 23 ciclos por glifo no JIT, mais 3 ciclos vezes a altura na geração do bitmap. No textdemo do vic-2350, o JIT leva cerca de 21 mil ciclos e a execução 42 mil, perto de 2,6% de um núcleo do RP2350. A expansão para RGB565 custa cerca de 3 vezes mais que isso.
Como funciona o kerning proposto?
Cada glifo tem dois bitvectors, um para o lado esquerdo e outro para o direito. Faz-se um and entre o da direita do primeiro e o da esquerda do segundo, e o popcount do resultado dá os pixels de kerning. A conta é feita na montagem da display list, não durante o scanout, e insere um caractere de espaço negativo na string.
Por que o código JIT não é guardado em cache?
Porque a RAM é escassa e o código gerado ocupa cerca de 10 vezes o tamanho da string. Como o JIT roda em menos de 100 µs antes do scanout da linha e seu custo é pequeno, regenerar compensa.
Fontes
- linebender.orgfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 09 de novembro de 2026
- Editoria
- CEVIU Web Dev