
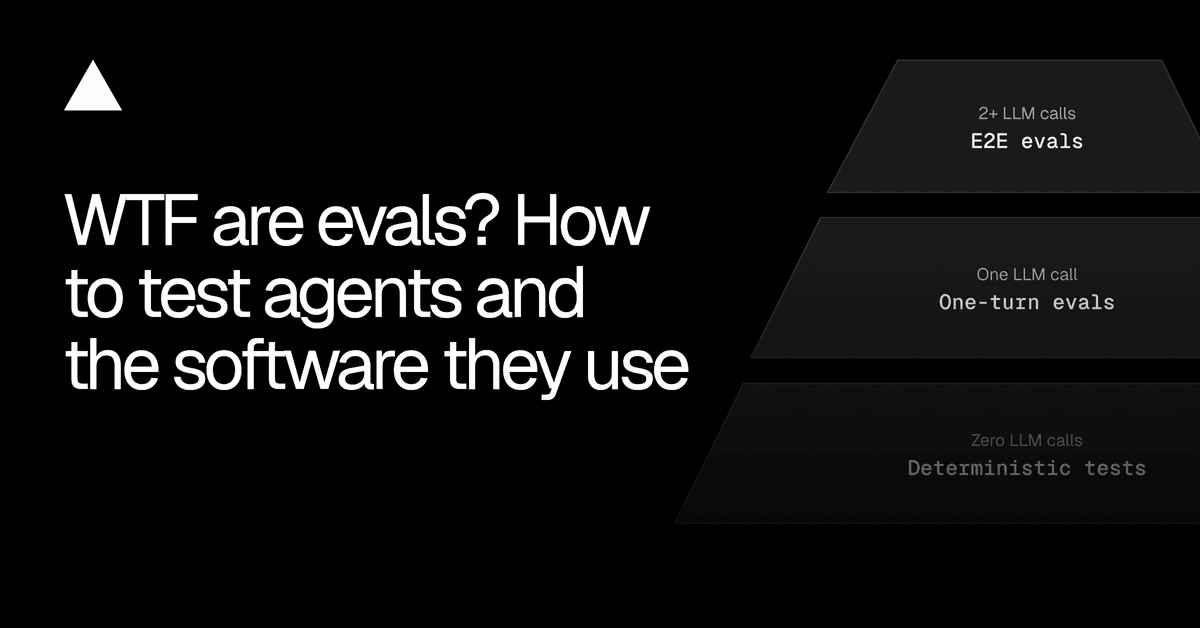
O que são evals e como usá-las para testar agentes e o software que eles utilizam
Aprofundamento CEVIU
Aprofundamento
O texto da Vercel parte de um problema prático: um agente pode concluir um pedido "com sucesso" e ainda assim entregar o resultado errado, como um latte quente quando o usuário queria gelado. Os logs na stack de Observability parecem normais, porque a requisição funcionou. Como as saídas de LLMs variam entre execuções, um teste manual bom não prova que uma correção resolveu algo. A eval repete as mesmas tarefas e avalia os resultados antes e depois da mudança.
A pirâmide proposta agrupa os testes pelo número de chamadas de LLM: determinísticos (0), evals de um turno (1) e evals E2E (2 ou mais). Para medir Success, o nível indicado é o E2E, já que o resultado depende da sequência inteira de passos. No exemplo do SF Beans, a eval usa o Harbor, que roda agentes em containers e registra tudo em traces. As métricas citadas são success rate, Pass@k e Pass^k, além de passos, tempo e custo medidos só nas tentativas bem-sucedidas. Com 60% de sucesso em cinco trials, o Pass@5 chega a cerca de 99%, mas o Pass^5 fica em cerca de 8%. A escolha da métrica depende do custo da falha para o usuário.
O que mudou
O tema já vinha sendo coberto pelo CEVIU. Em 20 de maio de 2026, o CEVIU noticiou "Avaliação de Agentes: Um Guia Detalhado", sobre a migração de benchmarks estáticos para harnesses realistas. Em 23 de setembro de 2026, veio "Avaliação de Agentes de IA: Além da Simples Chamada de Ferramentas", com foco em pontuação por etapa. Em 15 de outubro de 2026, o CEVIU publicou o texto sobre as metodologias da LangChain, que sugere analisar 10 a 20 exemplos de traces. Em 12 de novembro de 2026, saiu "Eval-driven development: como a LangChain propõe melhorar agentes de IA com evals". Esses textos tratam de avaliação de agentes em geral, e agora a Vercel traz um passo a passo concreto, com Harbor, métricas e um exemplo executável.
Por que isso importa
Para quem desenvolve APIs, CLIs ou MCP servers consumidos por agentes, a leitura é que logs verdes não bastam. Uma eval E2E pequena, focada em um problema real vindo de suporte ou de Observability, já mostra onde o agente erra. E escolher entre Pass@k e Pass^k é decisão de produto, não só de estatística.
Linha do tempo
CEVIU publica "Avaliação de Agentes: Um Guia Detalhado".
CEVIU publica "Avaliação de Agentes de IA: Além da Simples Chamada de Ferramentas".
CEVIU publica sobre as metodologias de avaliação de agentes da LangChain.
Vercel explica o que são evals e como usá-las para testar agentes e o software que eles utilizam.
Perguntas frequentes
O que é uma eval de agentes?
Se um teste pergunta "funcionou?", a eval pergunta "com que frequência funciona, e quão bem?". Você dá uma tarefa ao agente, avalia o resultado e agrega os dados de várias tentativas repetidas.
Qual a diferença entre Pass@k e Pass^k?
Pass@k é a chance de pelo menos uma de k tentativas passar, e responde se o agente consegue fazer a tarefa. Pass^k é a chance de todas passarem, e responde se dá para confiar nele sempre. No exemplo da Vercel, 60% de sucesso dá cerca de 99% de Pass@5 e cerca de 8% de Pass^5.
Por que usar eval E2E para medir Success?
Porque o sucesso depende da sequência completa de passos, como buscar cafés, filtrar e fazer o pedido. Cada passo pode parecer razoável isolado e o resultado final ainda estar errado. A eval E2E deixa o agente executar a tarefa toda e verifica o resultado final.
O que é o Harbor?
É um framework open source dos criadores do Terminal-Bench. Ele executa agentes em containers, verifica os resultados e registra as ações, e a Vercel o usa para montar a eval do exemplo.
Fontes
- vercel.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 12 de novembro de 2026
- Editoria
- CEVIU Web Dev