
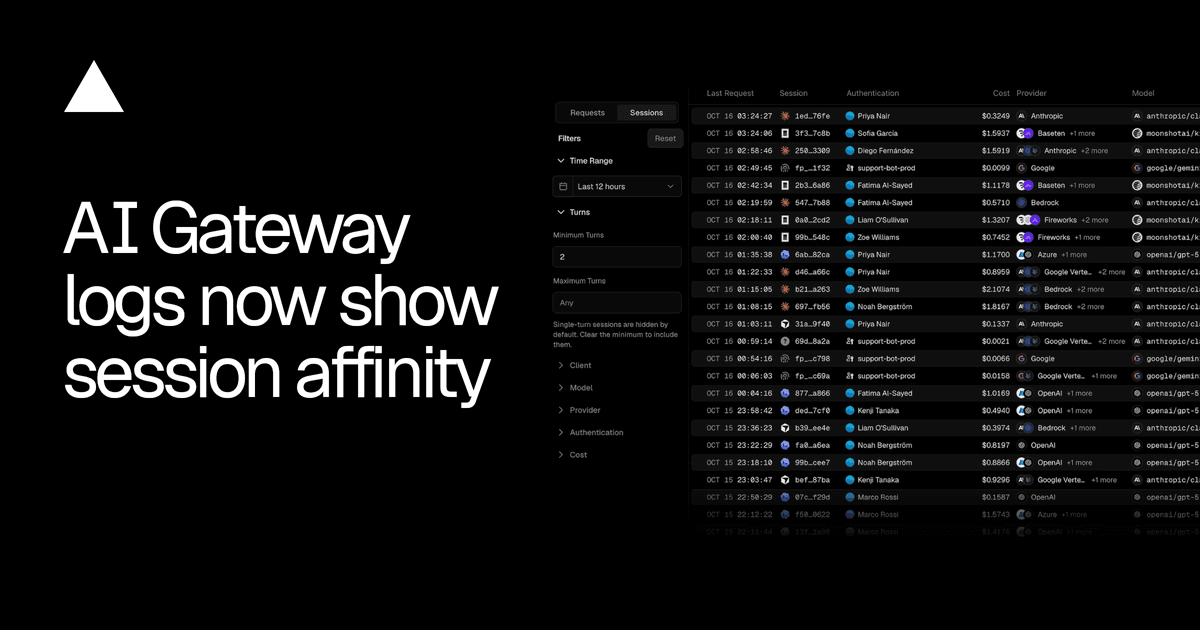
Logs do AI Gateway agora exibem session affinity e taxa de cache por sessão
Aprofundamento CEVIU
Aprofundamento
O ponto técnico aqui é o prompt caching. Em sessões longas de agentes de código, cada turno reenvia boa parte do contexto anterior. Se o turno seguinte cai em outro provedor, esse cache quente se perde e o input volta a ser cobrado e processado do zero. A session affinity do AI Gateway resolve isso mandando cada turno ao provedor que atendeu o anterior.
A nova visualização Sessions torna esse roteamento auditável. Cada linha mostra o agente ou app (Claude Code, Codex, Cursor), custo, modelos, provedores e a fatia do input que veio do cache. Ao abrir a sessão, o dev vê cache hit, duração e o caminho turno a turno, com modelo, tempo e provedor. Dá para filtrar por turnos, cliente, modelo, provedor, autenticação ou custo, e sessões de um único turno ficam ocultas até você limpar o filtro de mínimo de turnos.
Na prática, o agrupamento funciona por padrão em requisições de texto e chat. Para controlar você mesmo, envie o mesmo sessionId em providerOptions.gateway ou o header x-session-id em toda requisição da conversa. Sem identificador, o gateway usa uma impressão digital do início da conversa e lista como fingerprinted session.
O que mudou
A cobertura anterior do CEVIU já mostrava o mercado girando em torno do cache. Em 24 de agosto de 2026, a DigitalOcean passou a pesar o custo de invalidar um cache quente de prompt ao trocar de modelo no Inference Router. Em 25 de setembro de 2026, a OpenAI otimizou o cache de prompts do GPT-6, com descontos de até 90% em tokens de entrada cacheados. Agora a Vercel entrega a camada de observabilidade: não só roteia com afinidade, mas mostra o resultado por sessão.
Por que isso importa
Com desconto grande em token cacheado, quebrar o cache por roteamento ruim vira custo direto. Ver a taxa de cache por sessão ajuda a achar quais agentes ou fluxos estão trocando de provedor demais e a depurar gasto antes que ele estoure o orçamento.
Linha do tempo
Vercel adiciona orçamentos para chaves de API no AI Gateway.
DigitalOcean lança roteamento sensível a cache no Inference Router.
OpenAI otimiza o cache de prompts da família GPT-6 com descontos em tokens cacheados.
Logs do AI Gateway ganham a visualização Sessions com session affinity e taxa de cache.
Perguntas frequentes
O que é session affinity no AI Gateway?
É o roteamento que envia cada turno de uma conversa ao provedor que atendeu o turno anterior. Esse provedor já tem boa parte do prompt em cache. Uma sessão que fica em um único provedor lê mais do prompt a partir do cache.
Preciso configurar algo para usar?
Não. A session affinity roda por padrão em requisições de texto e chat. Só é preciso configurar se você quiser agrupar as requisições manualmente.
Como agrupo requisições na mesma sessão manualmente?
Envie o mesmo sessionId em providerOptions.gateway ou o mesmo header x-session-id em todas as requisições da conversa. Assim o gateway trata tudo como uma só sessão.
O que são fingerprinted sessions e por que não vejo sessões de um turno?
Quando não há identificador, o gateway agrupa as requisições por uma impressão digital do início da conversa, e elas aparecem como fingerprinted sessions. Sessões de um único turno ficam ocultas até você limpar o filtro de mínimo de turnos.
Fontes
- vercel.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 21 de outubro de 2026
- Editoria
- CEVIU Web Dev