
Ubicloud mostra como corrigir a precisão de tool calls no vLLM
Aprofundamento CEVIU
Aprofundamento
A Ubicloud serviu o Kimi K2.6 com vLLM 0.28 e mediu, no benchmark K2VV ToolCall da Moonshot AI, que só 92% das tool calls seguiam o schema. Na prática, 2 de cada 25 chamadas falhavam. Em fluxos de agentes com várias interações, cada falha joga mensagem de erro no contexto, derruba a qualidade e ainda custa mais, porque o agente precisa tentar de novo.
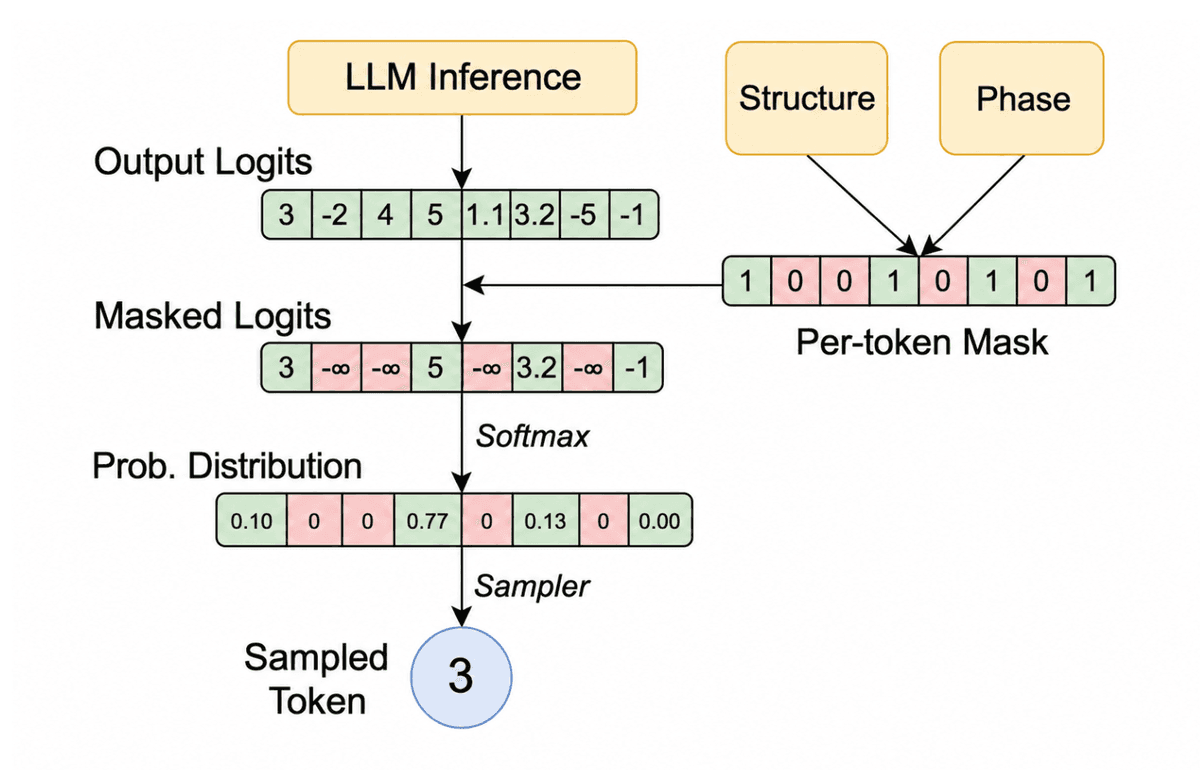
A causa é a natureza probabilística do modelo, que não roda compilador nem type checker. Ele pode gerar search_web quando a ferramenta se chama web_search, ou city_name quando o schema pede location. O constrained decoding resolve isso mascarando, a cada passo, os tokens inválidos. O vLLM usa structural tags da biblioteca XGrammar, que define o caminho válido: início da chamada, nome da tool, índice, início dos argumentos, JSON restrito ao schema e fim da chamada. Segundo a Ubicloud, o overhead é desprezível.
Houve um desvio no caminho. Depois que o recurso entrou no vLLM v0.25, a Ubicloud migrou do seu fork para o upstream e viu a precisão cair para 91%. A implementação estava correta, mas o vLLM passou a deixá-lo desligado por padrão, por ser um motor agnóstico a modelos. A flag --tool-strict-level permite ativá-lo, e o recurso saiu como flag de servidor no vLLM 0.31. Com ele, a empresa chegou a 100% de schema accuracy em Kimi e DeepSeek (o texto cita DeepSeek V4 Flash).
Por que isso importa
Para quem opera inferência própria de modelos open-weight, a leitura é que a qualidade percebida depende do motor e das flags, não só do modelo. Se o resultado em produção destoa dos benchmarks, vale checar o padrão do servidor antes de culpar o modelo. E 100% de schema accuracy garante chamada bem formada, não chamada útil, então ainda é preciso avaliar a decisão do agente.
Linha do tempo
Ubicloud publica como corrigiu a precisão de tool calls no vLLM, de 92% para 100% no K2VV ToolCall.
Perguntas frequentes
O que é constrained decoding em tool calls?
É uma técnica em que o motor de inferência bloqueia, a cada passo, os tokens que gerariam uma chamada inválida. A escolha do modelo fica restrita a um conjunto sintaticamente correto, definido pelo schema da ferramenta. Isso troca a abordagem de melhor esforço por uma garantia em tempo de execução.
Como ativar isso no vLLM?
Segundo a Ubicloud, o recurso saiu como flag de servidor no vLLM 0.31. O vLLM também adicionou a flag --tool-strict-level, que permite habilitar a rigidez das tool calls no deployment. O padrão é desligado, porque o suporte é feito modelo a modelo.
Por que a precisão caiu para 91% depois de usar o vLLM upstream?
A implementação do constrained decoding estava correta. O vLLM mudou o comportamento padrão para requisições que não pedem o recurso explicitamente, já que problemas apareceram com vários modelos. Desligar por padrão foi a opção mais segura para um motor genérico.
100% de schema accuracy significa que o agente acerta sempre?
Não. A garantia diz que a chamada segue o schema e pode ser executada. Ela não mostra se a tool call é útil ou correta para a tarefa.
Fontes
- ubicloud.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 27 de outubro de 2026
- Editoria
- CEVIU Web Dev