
Databricks usa o AI Runtime para sustentar experimentos de pesquisa com centenas de GPUs
Aprofundamento CEVIU
Aprofundamento
A Databricks descreve como o time de pesquisa em IA usa o Databricks AI Runtime (AIR) no dia a dia. O time treina modelos que alimentam o ai_parse_document e o ai_extract, das AI Functions, com SFT, RL offline e RL online. Os modelos vão de poucos bilhões de parâmetros a quase um trilhão, em GPUs NVIDIA H100 ou B300. As maiores execuções usam centenas de GPUs por dias ou semanas, com rede de alta largura de banda.
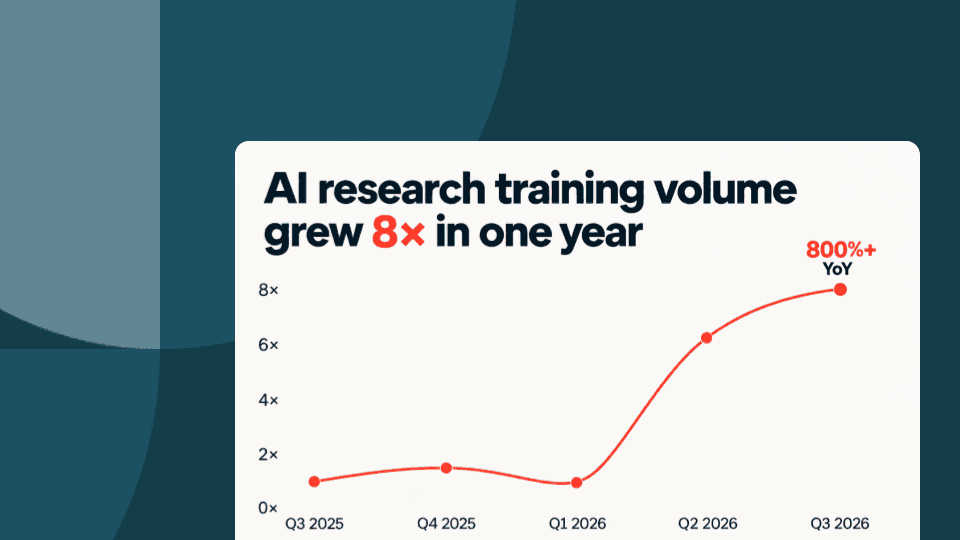
O AIR faz preflight checks nos nós e monitora a saúde durante a execução. Detecta falhas de comunicação NCCL, throttling térmico ou de energia e problemas de driver, e isola (cordon) o nó problemático para que os próximos jobs não caiam nele. A AIR CLI lança cargas de forma programática, e os mesmos containers Docker do desenvolvimento local servem para treinar, com imagens compartilhadas no Databricks Artifact Registry. O AIR cria e gerencia os experimentos MLflow automaticamente, e os dados ficam no Unity Catalog, acessados via FUSE mounting. Com agentes propondo e rodando experimentos (o chamado autoresearch), o número de jobs de treinamento nas pesquisas de AI Functions cresceu 8x. Os agentes usam a Databricks CLI e o databricks-air-skills para lançar cargas concorrentes e ler métricas do MLflow.
O que mudou
Em 3 de julho de 2026, o CEVIU noticiou "Como a Databricks garante a confiabilidade de GPUs em larga escala para IA", sobre falhas como jobs interrompidos e lentidões silenciosas. Agora a empresa mostra essa confiabilidade em uso real, no próprio time de pesquisa, com health checks e isolamento de nós. Já em 20 de março de 2026, o CEVIU publicou "Escalando a Autopesquisa de Karpathy: O Que Acontece Quando o Agente Recebe um Cluster de GPUs", com cerca de 910 experimentos em 8 horas. O relato da Databricks traz o mesmo padrão para dentro de uma empresa, com o aumento de 8x nos jobs.
Por que isso importa
Para quem opera pipelines de treinamento, a leitura é que, quando agentes disparam centenas de experimentos, startup lento e erro confuso viram gargalo antes de qualquer limite de modelo. Interface programática, erros claros e rastreamento automático passam a ser requisito de infraestrutura, não conveniência.
Linha do tempo
CEVIU noticia a autopesquisa de Karpathy com agente e cluster de 16 GPUs.
CEVIU noticia como a Databricks garante a confiabilidade de GPUs em larga escala.
Databricks detalha o uso do AI Runtime na pesquisa, com jobs de treinamento 8x maiores via agentes.
Perguntas frequentes
O que é o Databricks AI Runtime (AIR)?
É a infraestrutura de GPU da Databricks para treinar e ajustar modelos. Oferece provisionamento, agendamento, rede de alta largura de banda, health checks e integração com MLflow e Unity Catalog. O time de pesquisa da empresa é o cliente zero do produto desde o início, no ano passado.
Como o AIR lida com GPUs defeituosas?
Faz preflight checks antes do treino e monitora os nós durante a execução. Detecta falhas de NCCL, throttling e problemas de driver. Se um nó falha, ele é isolado para que os jobs seguintes não sejam agendados nele.
O que é autoresearch e por que mudou o volume de jobs?
É o uso de agentes para propor mudanças, rodar experimentos, avaliar resultados e decidir o próximo passo, popularizado por Andrej Karpathy. Nas pesquisas de AI Functions da Databricks, o número de jobs de treinamento cresceu 8x.
Como os agentes interagem com o AIR?
Pela Databricks CLI e pelo databricks-air-skills. Com eles, os agentes lançam cargas concorrentes, acompanham o status dos jobs, buscam métricas no MLflow e iteram com base nos resultados.
Fontes
- databricks.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 26 de outubro de 2026
- Editoria
- CEVIU Web Dev