
Observabilidade de GPU na Nuvem: Desafios e Estratégias Essenciais
Aprofundamento CEVIU
Aprofundamento
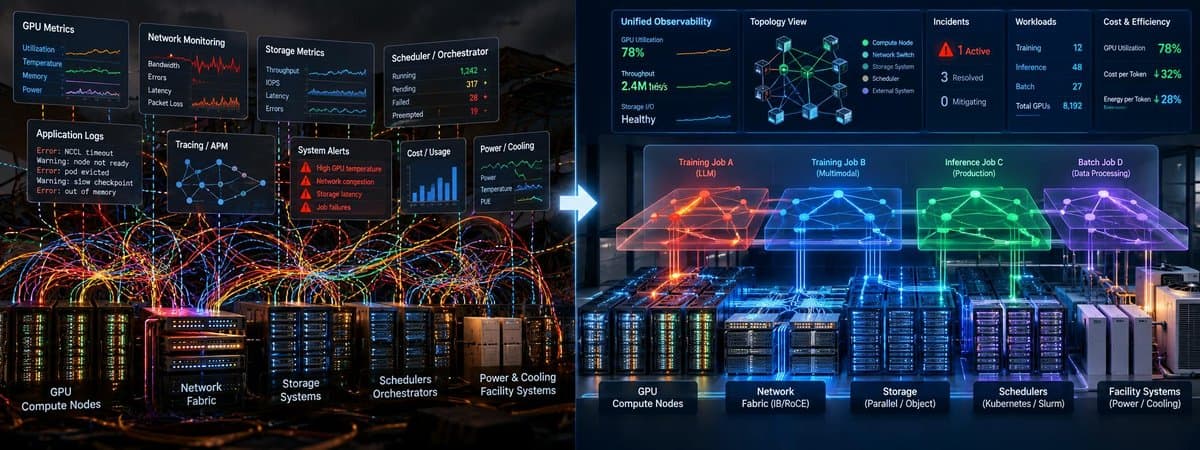
A complexidade de monitorar GPUs em ambientes de nuvem, os NeoClouds, reside na interdependência profunda entre infraestrutura física e cargas de trabalho de IA. Ferramentas de monitoramento convencionais, segmentadas por subsistema, frequentemente falham em apresentar uma visão coesa, gerando desafios para otimizar desempenho e alocação de recursos. A matéria "GPUs ociosas: O novo desafio da otimização na era da IA", de 31 de julho de 2026, já apontava o problema da ineficiência. Agora, fica claro que a observabilidade ciente da topologia é crucial: ela interliga componentes de hardware com as tarefas de software, permitindo identificar gargalos, como um caminho de rede congestionado ou um serviço de armazenamento lento, que afetam diretamente o treinamento e a inferência de modelos.
Essa abordagem integrada permite correlacionar dados de hardware com métricas de aplicações distribuídas, um ponto que a "NVIDIA Exemplar Cloud revela gargalos em infraestrutura de IA e aprimora desempenho" (31 de julho de 2026) já havia tocado ao identificar falhas de configuração. A observabilidade ciente da topologia, ao conectar essas pontes, ajuda a gerenciar a fragmentação da capacidade e garante que os recursos de GPU, que são caros, sejam utilizados de forma produtiva. Isso é estratégico para evitar o desperdício, como alertado na "A Gestão de Custos de GPUs: O Novo Desafio para Equipes de IA", de 24 de agosto de 2026.
O que mudou
A cobertura anterior do CEVIU estabeleceu o cenário dos desafios operacionais. A matéria "NVIDIA Exemplar Cloud revela gargalos em infraestrutura de IA e aprimora desempenho", de 31 de julho de 2026, identificou falhas de configuração específicas. Mais recentemente, a "Netflix Otimiza Infraestrutura de GPU para Treinamento e Inferência em Larga Escala", de 19 de outubro de 2026, mostrou uma solução prática para gerenciar interrupções causadas por falhas menores. A notícia atual aprofunda essa discussão, apresentando a ênfase na observabilidade ciente da topologia como a estratégia arquitetural necessária. É uma evolução da identificação de problemas pontuais e soluções reativas para uma abordagem proativa e sistêmica de monitoramento.
Por que isso importa
Para líderes de TI, arquitetos de soluções e equipes de engenharia de plataforma, a observabilidade de GPU na nuvem é fundamental para maximizar o retorno sobre o investimento em infraestruturas de IA, que têm custo elevado. A capacidade de integrar telemetria com o contexto de topologia e carga de trabalho traduz-se em maior eficiência operacional, melhor previsibilidade de desempenho e controle de custos. Evitar o desperdício de GPU e garantir a produtividade das cargas de trabalho de IA não é apenas uma questão técnica, mas um imperativo estratégico para o sucesso das iniciativas de transformação digital baseadas em IA nas empresas.
Linha do tempo
GPUs ociosas: O novo desafio da otimização na era da IA
NVIDIA Exemplar Cloud revela gargalos em infraestrutura de IA e aprimora desempenho
Desafios da Memória em Sistemas Distribuídos: Otimização Crucial para Desenvolvedores
A Gestão de Custos de GPUs: O Novo Desafio para Equipes de IA
Desafios na Otimização de Custos no GCP: Integrando Faturamento e Telemetria
Netflix Otimiza Infraestrutura de GPU para Treinamento e Inferência em Larga Escala
Observabilidade de GPU na Nuvem: Desafios e Estratégias Essenciais
Perguntas frequentes
O que é observabilidade ciente da topologia em NeoClouds?
É a capacidade de monitorar a infraestrutura de GPU na nuvem, interligando dados de telemetria (desempenho e uso) com o mapa de como os componentes físicos e lógicos estão conectados. Ela revela como sistemas e recursos interagem e impactam as cargas de trabalho.
Por que a observabilidade de GPU é um desafio maior em NeoClouds?
NeoClouds são sistemas altamente acoplados, projetados para IA acelerada com requisitos de rede e armazenamento específicos. Ferramentas de monitoramento tradicionais, fragmentadas por subsistema, não conseguem oferecer a visão holística necessária para identificar problemas complexos que cruzam esses limites.
Como a observabilidade avançada de GPUs impacta os custos operacionais?
Ela ajuda a identificar GPUs ociosas ou subutilizadas e a gerenciar a fragmentação da capacidade. Com isso, garante que os recursos de GPU, que são caros, sejam alocados e utilizados de forma eficiente, evitando desperdício e otimizando o investimento em hardware.
Quais tipos de dados uma plataforma de observabilidade unificada integra?
Uma plataforma robusta integra dados de identidade de componentes (UUIDs, nomes de hosts), telemetria com carimbo de tempo consistente, informações normalizadas de diferentes fornecedores, a topologia da infraestrutura e o contexto das cargas de trabalho e clientes.
Fontes
- hackernoon.comfonte original
- Categoria
- CEVIU TI
- Publicado
- 20 de outubro de 2026
- Editoria
- CEVIU TI