
Ai2 lança benchmark para avaliar a capacidade da IA em identificar e corrigir equívocos do usuário
Aprofundamento CEVIU
Aprofundamento
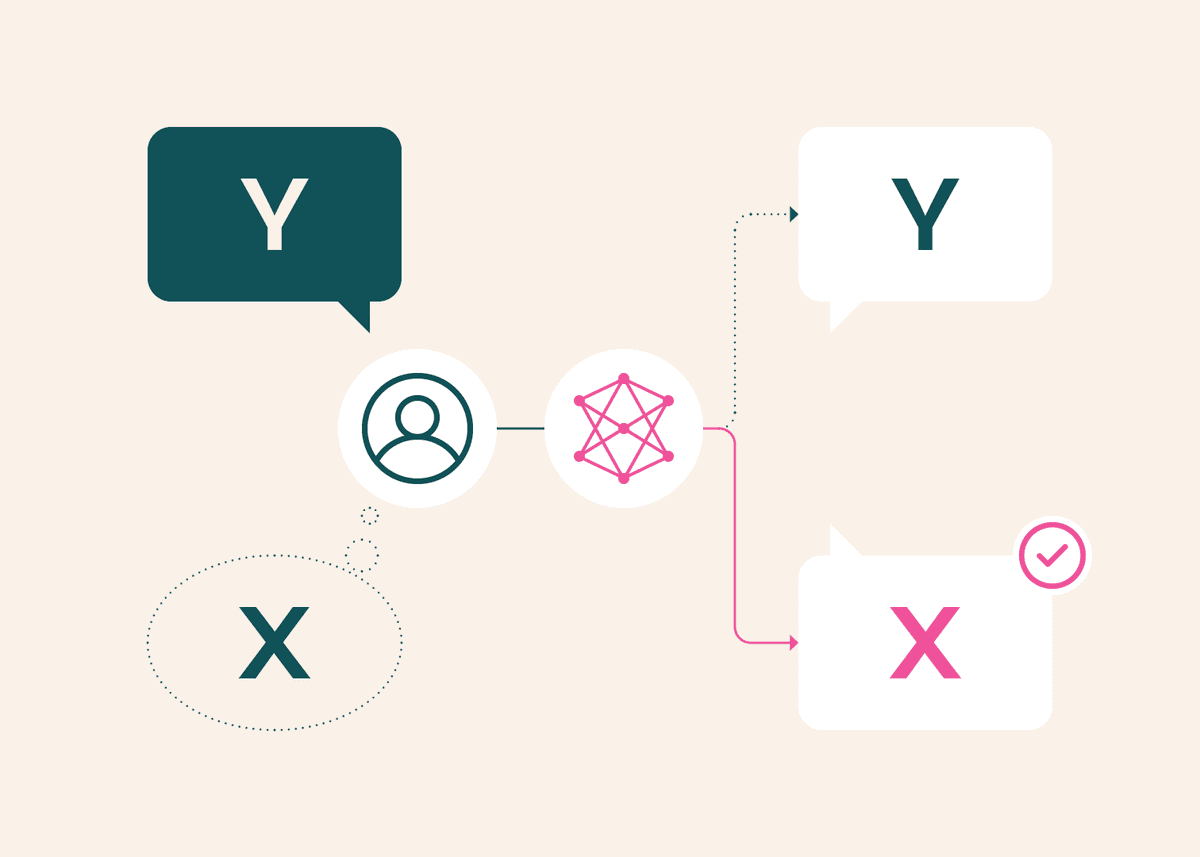
A Allen Institute for AI (Ai2), em colaboração com Carnegie Mellon, NVIDIA e Johns Hopkins, lançou o XYBench, um novo benchmark projetado para avaliar a capacidade de assistentes de IA em identificar e corrigir equívocos implícitos em perguntas de usuários. O benchmark, que recebeu o Best Resource Paper Award no EMNLP 2026, foca no que é conhecido como 'problema XY': o usuário busca resolver 'X', mas assume que a abordagem 'Y' é a correta, pedindo ajuda para 'Y'.
O XYBench contém mais de 8 mil perguntas reais, compiladas de fontes como Stack Overflow, Stack Exchange, exemplos manuais e guias do WikiHow. Ele mede três aspectos da resposta de um modelo: a 'solução pragmática' (se inclui soluções para o pedido explícito Y e o objetivo implícito X), a 'ênfase pragmática' (se foca em Y, em X, ou equilibra) e a 'identificação de equívocos' (se redireciona o usuário para X, desencorajando Y). Testes com modelos como Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B e DeepSeek-V4 Pro mostraram que a maioria se concentra na solução equivocada Y, diferentemente de respostas humanas que priorizariam o objetivo real X.
O que mudou
A Ai2 tem lançado benchmarks focados em diferentes capacidades de IA. Em 3 de novembro de 2026, o CEVIU noticiou que a Ai2 lançou um benchmark para avaliar a confiabilidade de LLMs em julgar a originalidade de ideias de pesquisa. No mesmo dia, o CEVIU também cobriu o lançamento do StateBench, focado em como modelos de linguagem rastreiam mudanças de estado em contextos longos. Com o XYBench, a Ai2 expande sua linha de ferramentas de avaliação para uma área crucial: a capacidade de compreensão pragmática e correção de equívocos do usuário, uma dimensão diferente da rastreabilidade de estado ou da avaliação de ineditismo, mostrando um foco contínuo no aprimoramento da utilidade e robustez dos modelos de IA.
Por que isso importa
Para desenvolvedores e pesquisadores que trabalham com assistentes de IA, o XYBench é uma ferramenta vital para refinar a capacidade dos modelos de lidar com usuários que não formulam suas necessidades de forma ideal. A habilidade de identificar e corrigir equívocos implícitos é um passo fundamental para tornar os assistentes de IA realmente úteis em cenários do mundo real, onde os usuários nem sempre sabem a pergunta certa a fazer. Este benchmark ajuda a quantificar o progresso nessa área, permitindo que as equipes comparem modelos e identifiquem onde os treinamentos e prompts podem ser ajustados para melhorar a compreensão contextual e a proatividade na resolução de problemas.
Linha do tempo
Ai2 lança benchmark para avaliar se LLMs julgam bem a originalidade de pesquisa.
Ai2 apresenta StateBench, benchmark para rastreio de mudanças de estado em contexto longo.
Ai2 lança XYBench, benchmark para avaliar a capacidade da IA em identificar e corrigir equívocos do usuário.
Perguntas frequentes
O que é o 'problema XY' que o XYBench visa resolver?
O 'problema XY' ocorre quando um usuário deseja alcançar um objetivo 'X', mas erroneamente assume que uma abordagem específica 'Y' é a solução, e então pede ajuda para 'Y'. O XYBench avalia se assistentes de IA conseguem identificar esse equívoco e direcionar o usuário para a solução real de 'X'.
Quais modelos de IA foram testados no XYBench e quais foram os resultados gerais?
Modelos como Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B e DeepSeek-V4 Pro foram testados. Os resultados indicaram que, embora os modelos pudessem sugerir soluções, a maioria focou na abordagem equivocada 'Y', falhando em direcionar o usuário para a solução mais eficaz de 'X', como respostas humanas fariam.
Como o XYBench mede a eficácia das respostas de um modelo de IA?
O benchmark mede três aspectos: 'solução pragmática' (se o modelo oferece soluções para o pedido explícito Y e o objetivo implícito X), 'ênfase pragmática' (se a resposta foca em Y, em X ou equilibra ambos) e 'identificação de equívocos' (se o modelo direciona o usuário para X, desencorajando Y).
De onde vêm as perguntas usadas no XYBench?
As mais de 8 mil perguntas do XYBench foram compiladas de diversas fontes, incluindo Stack Overflow, Stack Exchange, exemplos curados manualmente e perguntas geradas a partir de guias do WikiHow. Isso garante uma ampla gama de cenários e domínios para testar os modelos.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 13 de novembro de 2026
- Editoria
- CEVIU IA