
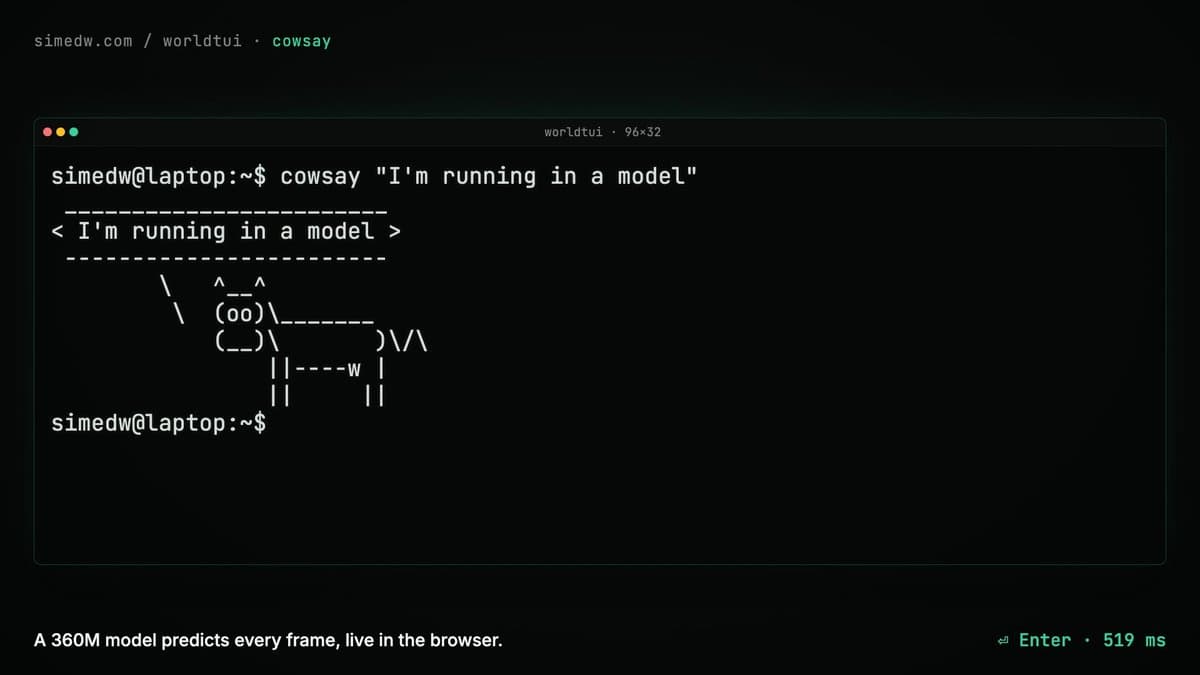
WorldTUI, modelo de 360M de parâmetros com fine-tuning, simula um terminal sem shell por trás
Aprofundamento CEVIU
Aprofundamento
O WorldTUI parte do Qwen2.5-Coder-0.5B (cerca de 494M de parâmetros), com fine-tuning em sessões de terminal gravadas de programas reais rodando em Docker. Não há shell nem sistema de arquivos por trás: cada tecla entra como os bytes que um terminal real enviaria, e o modelo responde com quais linhas reescrever e onde o cursor termina. O vocabulário cai para 333 tokens (256 de bytes, 64 de linhas e algumas operações especiais), com decodificação restrita por gramática, então toda previsão é uma atualização de tela válida. Uma operação COPY evita regerar a tela inteira num scroll: três tokens por linha, em vez de cerca de 96.
Os números de treino: 336 mil episódios, algo como 2B de tokens, e cerca de 75 horas de GPU numa RTX 4090. A autocorreção, inspirada no DAgger, levou o PresetBench de 24/47 para 38/47 em int4. Na memória, o modelo acertou 9/13 leituras, contra 2/13 e 3/13 dos modelos com prompt. Ainda não é um sistema de arquivos confiável: após echo green >> colors, o cat colors muitas vezes não mostra a linha anexada.
Na latência, a decodificação paralela por linha, com verificação sequencial no estilo speculative decoding, derrubou o p95 de quadros grandes de 6,7 s para 0,87 s. No navegador, num Mac M4, digitar um caractere leva cerca de 60 ms, e um man test cai de 2,5 s para 0,9 s. Cortar a tabela de embeddings reduz o modelo a cerca de 360M parâmetros, e o int4 chega a 208 MB, rodando local via WebGPU. A tentativa de destilar em menos camadas mostrou um achado curioso: remover só a camada 7 mal mexeu na acurácia de próximo token (99,3% para 98,9%), mas zerou as leituras de memória (64/64 para 0/64).
O que mudou
A conexão com a cobertura anterior é de tema, não de evolução do mesmo produto. Em 22 de outubro de 2026, o CEVIU noticiou "GUI-Owl 1.5: modelo de 2B de parâmetros opera apps Android direto no celular", e em 4 de setembro de 2026, "Three-LLM Viabiliza LLMs no Navegador com WebGPU e Three.js". Ambos tocam em modelos pequenos rodando perto do usuário, mas são projetos distintos do WorldTUI.
Por que isso importa
Para quem trabalha com world models, o recado é que dá para estudar consistência de estado em escala pequena, com dados rotulados de graça. O resultado também mostra um limite: o modelo imita bem a saída, mas a memória de longo prazo ainda falha em combinações novas. Para quem pensa em inferência no navegador, o caso ilustra o que vocabulário enxuto e int4 entregam em 208 MB.
Linha do tempo
CEVIU noticia o Three-LLM, que roda LLMs no navegador com WebGPU e Three.js.
CEVIU noticia o GUI-Owl 1.5, modelo de 2B que opera apps Android no celular.
WorldTUI, modelo de 360M que simula um terminal sem shell, ganha demo no navegador.
Perguntas frequentes
O WorldTUI roda um shell de verdade?
Não. Não existe shell nem sistema de arquivos por trás. O modelo recebe cada tecla e prevê como a tela muda. Digitar pythoon na demo mostra isso, porque ele aceita o erro de digitação e abre o Python.
Qual é o modelo base e qual o tamanho final?
A base é o Qwen2.5-Coder-0.5B, com cerca de 494M de parâmetros. Ao reduzir o vocabulário para 333 tokens, o modelo cai para cerca de 360M. Quantizado em int4, fica com 208 MB.
Como rodar a demo?
Ela roda no navegador, de preferência Chrome ou Edge em desktop com WebGPU e teclado físico. Todo o processamento é local, na aba. Em celulares modernos deve funcionar, mas muito devagar.
O WorldTUI é confiável como sistema de arquivos?
Ainda não. Acertou 9/13 leituras de memória, bem acima dos modelos com prompt, mas combinações novas de comandos quebram com facilidade. Por exemplo, o cat nem sempre mostra uma linha adicionada com echo >>.
Fontes
- simedw.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 23 de outubro de 2026
- Editoria
- CEVIU IA