
OpenAI Otimiza Cache de Prompts para GPT-6 com Melhorias de Desempenho e Economia
Aprofundamento CEVIU
Aprofundamento
A OpenAI elevou o patamar do prompt caching para o GPT-6, uma evolução fundamental para os agentes de IA mais sofisticados. Agentes que trabalham por horas, como os que refatoram código ou criam documentos complexos, fazem várias requisições API em sequência. Muitas vezes, carregam as mesmas instruções e contexto do início. Reutilizar essa computação por meio do cache não é só uma questão de velocidade, mas de viabilidade econômica.
Já vínhamos cobrindo a importância dessa estratégia. O CEVIU noticiou em 24 de julho de 2026, no artigo “Otimização de Custos em Aguns de IA: A Estratégia de Caching de Prompts”, que a reutilização de prefixos de prompt seria crucial para otimizar desempenho e reduzir custos operacionais de agentes de IA de longa duração. Agora, com o GPT-6, essa otimização se concretiza com um sistema ainda mais robusto e ferramentas inéditas para desenvolvedores.
O que mudou
Houve uma evolução clara desde as primeiras discussões sobre prompt caching. Em 19 de fevereiro de 2026, o CEVIU já detalhava no artigo “Prompt Caching 201: Otimizando Desempenho e Custos com Reutilização de Prefixes de Prompt” como a reutilização de prefixos de prompt reduzia latência e custos. Essa era a teoria e a base. Agora, com o GPT-6, a OpenAI entrega mais do que uma explicação: vemos um sistema aprimorado com taxas de acerto padrão mais altas, além de descontos substanciais de até 90% para tokens de entrada em prefixos compartilhados reutilizados em um período de 30 minutos.
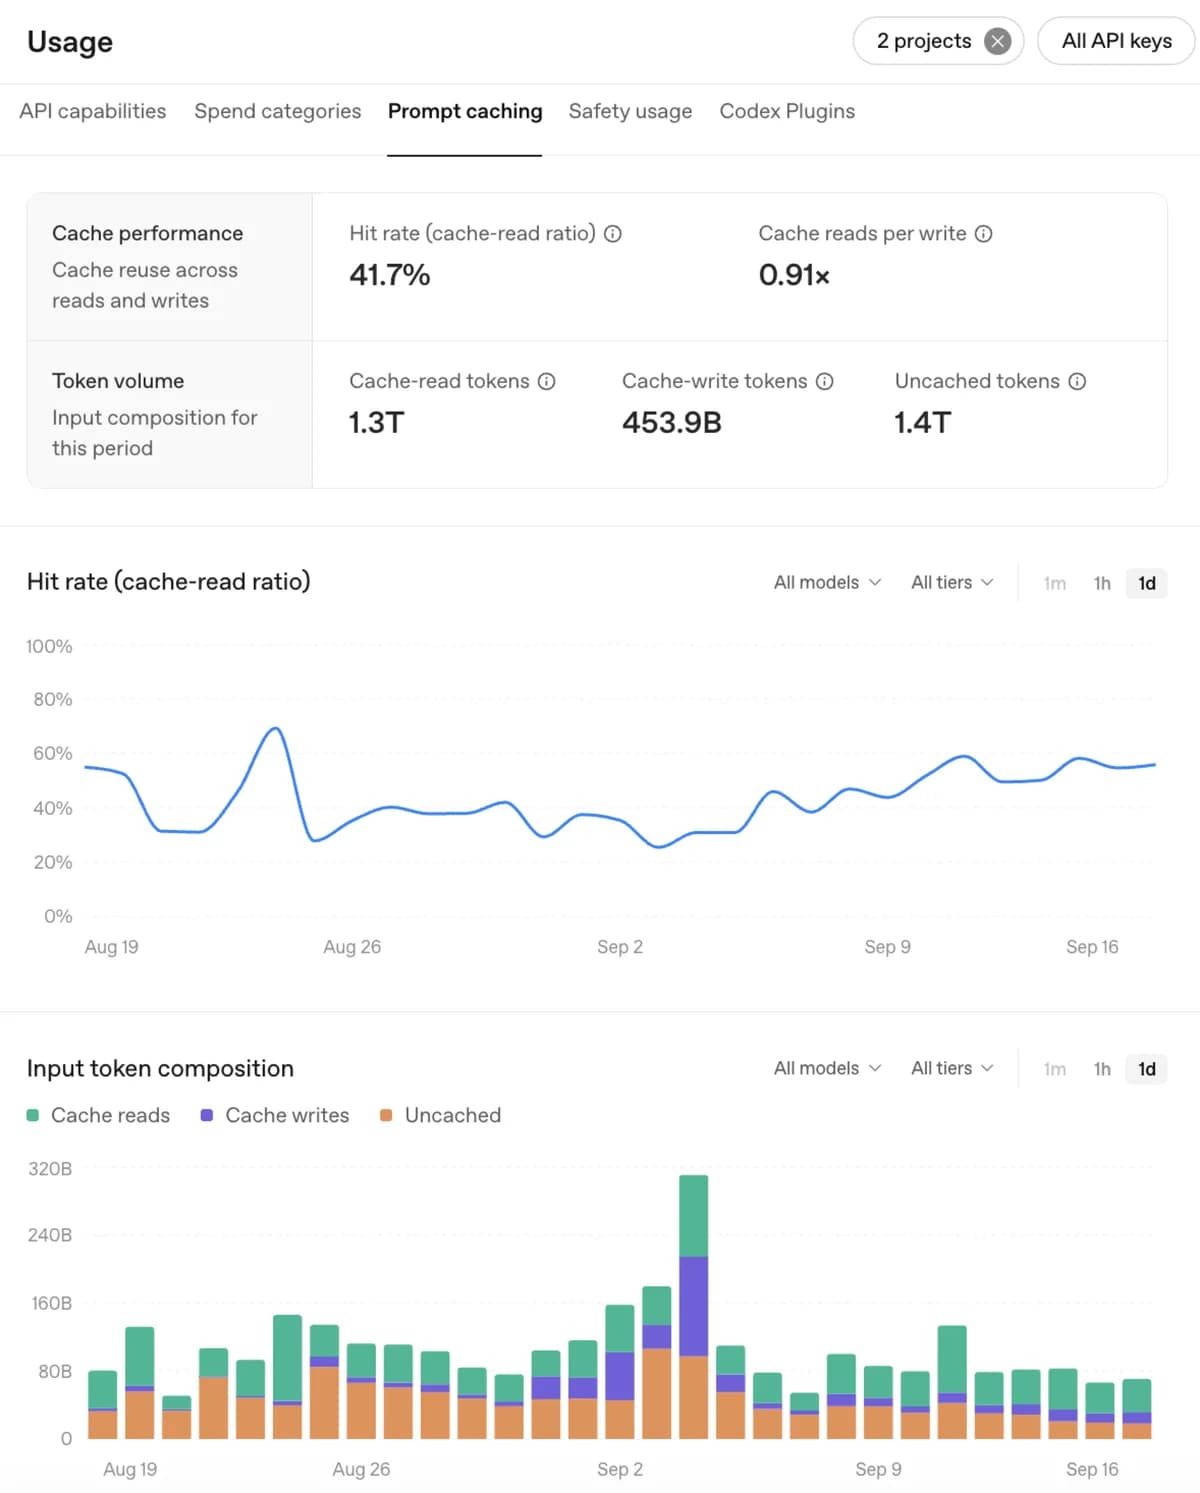
As novidades incluem também um painel de monitoramento de cache, ferramentas de diagnóstico de “misses” e controles finos para desenvolvedores. Agora é possível escolher o que cachear, ajustar o esforço de raciocínio sem quebrar o cache, e até preaquecer o cache para reduzir a latência inicial. São recursos que dão mais poder e visibilidade para otimizar o uso da IA, algo que antes era mais um conceito teórico.
Por que isso importa
Para os desenvolvedores, isso significa mais controle e economia. Reduzir a latência e o custo de interações complexas com IA torna aplicações antes impensáveis, ou caras demais, em realidade. A capacidade de monitorar e diagnosticar o desempenho do cache permite afinar as aplicações para máxima eficiência.
No cenário mais amplo, a otimização do cache é um motor para a próxima geração de agentes de IA. Agentes capazes de realizar tarefas mais complexas e duradouras tornam-se economicamente viáveis. É um passo essencial para a democratização da IA, como já abordado no lançamento do GPT-6 Sol e Luna, em 23 de setembro de 2026, tornando a tecnologia de ponta mais acessível e prática.
Linha do tempo
OpenAI publica 'Prompt Caching 201' detalhando a reutilização de prefixos de prompt para otimização.
CEVIU noticia 'Otimização de Custos em Aguns de IA: A Estratégia de Caching de Prompts', focando em agentes de longa duração.
OpenAI lança família GPT-5.6 com foco em desempenho e eficiência de custo, incluindo técnicas de caching.
OpenAI reduz preços do GPT-5.6 e acelera APIs, impulsionando a adoção da IA.
OpenAI anuncia melhorias na relação preço-performance para modelos GPT, com redução de custo para o GPT-5.6 Luna.
OpenAI expande sua família de modelos de linguagem com o lançamento do GPT-6 Sol e Luna.
OpenAI anuncia avanços no sistema de cache de prompts para o GPT-6, com melhorias de desempenho e descontos.
Perguntas frequentes
O que é prompt caching e como ele funciona com o GPT-6?
Prompt caching é uma técnica que reutiliza partes de instruções (prompts) que se repetem em sequências de requisições a modelos de IA. No GPT-6, quando um agente faz várias chamadas à API com contexto compartilhado, o sistema armazena e reusa essa computação, evitando processamento desnecessário. Isso economiza custos e acelera as respostas.
Quais são os principais benefícios das melhorias de cache para desenvolvedores?
Os desenvolvedores ganham em performance e custo. Com taxas de acerto de cache mais altas, a latência diminui. Os descontos de até 90% em tokens de entrada reduzem significativamente os gastos. Além disso, as novas ferramentas de monitoramento e diagnóstico oferecem maior visibilidade e controle sobre como o cache está sendo utilizado.
Como as novas ferramentas ajudam a otimizar o uso do cache?
A OpenAI disponibilizou um dashboard para acompanhar as taxas de acerto e tokens cacheados. Há também uma ferramenta de diagnóstico para entender o que causa um 'cache miss'. Desenvolvedores podem ainda definir 'breakpoints' para escolher o que cachear, ajustar o esforço de raciocínio sem quebrar o cache e até pré-aquecer o cache, preparando o contexto antes da primeira interação.
Qual o impacto dessas otimizações para agentes de IA persistentes?
Agentes de IA persistentes, que operam por horas em tarefas complexas, se beneficiam enormemente. Eles fazem múltiplas requisições sequenciais. A capacidade de reutilizar o contexto de forma eficiente e econômica torna esses agentes mais viáveis e performáticos, permitindo que executem tarefas extensas como refatorar código ou produzir documentos detalhados sem interrupção ou custo proibitivo.
Fontes
- openai.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 23 de setembro de 2026
- Editoria
- CEVIU IA