
O Salto na Escala do Reinforcement Learning para Modelos que Aprendem Sozinhos
Aprofundamento CEVIU
Aprofundamento
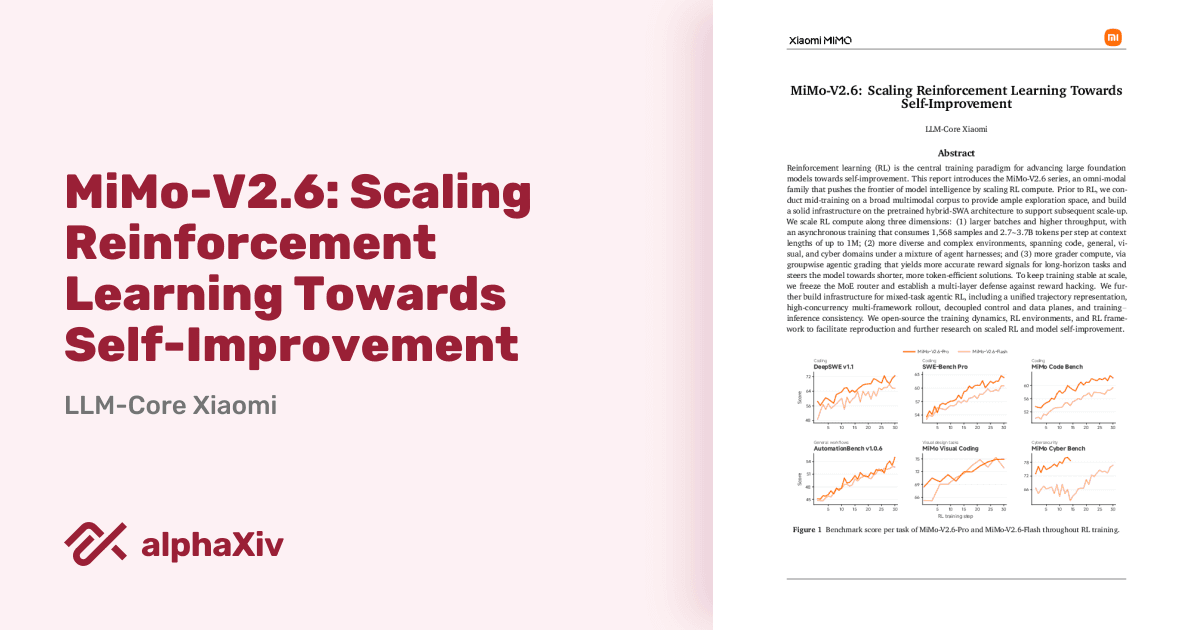
A série MiMo-V2.6 representa um avanço significativo no Reinforcement Learning (RL) para modelos de fundação que se autoaperfeiçoam. Esta nova família de omni-models escala o poder computacional do RL em três frentes. Primeiro, com lotes maiores e maior vazão, usando treinamento assíncrono para consumir 1.568 amostras e 2,7 a 3,7 bilhões de tokens por etapa. Segundo, pela diversidade e complexidade dos ambientes, abrangendo domínios como código, visual e cibersegurança. Terceiro, com o aumento da capacidade de avaliação, utilizando a avaliação agente-grupo para sinais de recompensa mais precisos.
Para garantir a estabilidade do treinamento em larga escala, os desenvolvedores congelaram o roteador MoE (Mixture-of-Experts), resolvendo um problema de desequilíbrio crítico que surgia com a atualização dos pesos. Além disso, implementaram uma defesa robusta contra o "reward hacking", conhecida como Groupwise Advantage Redistribution (GAR). O projeto abriu o código da dinâmica de treinamento, os ambientes de RL e o framework, facilitando a reprodução e futuras pesquisas em RL escalonado e autoaperfeiçoamento de IA.
O que mudou
A cobertura anterior do CEVIU News, como a matéria "Nova Abordagem Revoluciona Resolução de Problemas Complexos em IA com Reforço" de 16 de setembro de 2026, já apontava a falha dos métodos tradicionais de RL e a insuficiência de avaliações escalares para LLMs em problemas complexos. O MiMo-V2.6 oferece uma solução concreta para isso, com a introdução do Groupwise Advantage Redistribution (GAR), um mecanismo que supera a avaliação binária "passa/falha" ao classificar e recompensar soluções mais limpas e eficientes. Era um problema identificado; agora temos uma resposta técnica implementada.
Outro ponto de evolução é a solução para a instabilidade em larga escala. Embora a comunidade discutisse a importância do RL para aprimorar modelos, o MiMo-V2.6 detalha uma solução específica para a estabilidade: congelar o roteador da arquitetura MoE. Isso resolve um problema técnico crucial na hora de escalar, mostrando que o que era um desafio teórico na cobertura de "Aprendizado por Reforço Impulsiona Evolução de Grandes Modelos de Linguagem" de 25 de agosto de 2026, agora tem uma solução prática para o treinamento massivo.
Por que isso importa
O MiMo-V2.6 é um marco porque valida a escalabilidade do Reinforcement Learning para a construção de IA que pode se autoaperfeiçoar de forma robusta e estável. A capacidade de treinar modelos em lotes massivos e ambientes heterogêneos, mantendo a estabilidade e combatendo o "reward hacking", pavimenta o caminho para agentes de IA mais autônomos e confiáveis. Isso significa que podemos esperar sistemas que não apenas aprendam mais rápido, mas também com maior qualidade e alinhamento, evitando atalhos indesejados.
A abertura do código do framework de treinamento é outro ponto vital. Ela democratiza o acesso a tecnologias de ponta em RL e acelera a pesquisa, permitindo que outros desenvolvedores e pesquisadores contribuam e inovem sobre uma base sólida. Embora os custos de pós-treinamento em RL possam ser altos, chegando a milhões de dólares para os modelos maiores, a reprodutibilidade em escalas menores demonstra um esforço para tornar essas técnicas acessíveis à comunidade.
Linha do tempo
A Arquitetura RL Por Trás do Minimax M2.5 é explicada.
Estudo da OpenAI mostra eficácia do Reinforcement Learning para alinhar modelos de IA.
Miles v0.1 é lançado, aprimorando agentes de IA com pós-treinamento por reforço.
Família Ornith-1.5 de modelos abertos de IA promete autoaprimoramento contínuo.
Aprendizado por Reforço é destaque como pilar na evolução de grandes modelos de linguagem.
Nova abordagem para Reinforcement Learning revoluciona resolução de problemas complexos em IA.
MiMo-V2.6 introduz família de omni-models, escalando Reinforcement Learning para autoaperfeiçoamento.
Perguntas frequentes
O que é o MiMo-V2.6 e qual sua principal inovação?
MiMo-V2.6 é uma nova série de omni-models de IA que avança a fronteira da inteligência artificial ao escalar o Reinforcement Learning (RL). Sua principal inovação é a capacidade de aprimorar modelos de fundação em larga escala de forma estável, utilizando mecanismos como o Groupwise Advantage Redistribution para sinais de recompensa mais precisos e o congelamento do roteador MoE para estabilidade de treinamento.
Como o MiMo-V2.6 combate o "reward hacking"?
Para combater o "reward hacking", o MiMo-V2.6 implementa o Groupwise Advantage Redistribution (GAR). Em vez de uma recompensa binária de "passar/falhar", o GAR compara múltiplas tentativas de uma tarefa e classifica as soluções, dando maior reforço positivo para as mais limpas e eficientes. Soluções que "trapaceiam" (reward hacking) são resetadas e tratadas como falhas.
Qual a importância de congelar o roteador MoE no treinamento do MiMo-V2.6?
Congelar o roteador MoE (Mixture-of-Experts) é crucial para a estabilidade do treinamento em larga escala. Os desenvolvedores descobriram que atualizar os pesos do roteador causava um desequilíbrio, com alguns especialistas sobrecarregados e outros ociosos. Manter o roteador fixo garante que a carga de trabalho seja distribuída de forma equitativa, permitindo que o modelo aprenda de maneira mais eficiente e estável.
Qual o significado de abrir o código e os ambientes de RL do MiMo-V2.6?
A abertura do código da dinâmica de treinamento, dos ambientes de RL e do framework visa facilitar a reprodução e futuras pesquisas. Isso permite que a comunidade científica e desenvolvedores repliquem os resultados, entendam as metodologias e construam sobre elas, acelerando o desenvolvimento de técnicas de RL escalonado e o autoaperfeiçoamento de modelos de IA de forma colaborativa.
Fontes
- alphaxiv.orgfonte original
- Categoria
- CEVIU IA
- Publicado
- 22 de setembro de 2026
- Editoria
- CEVIU IA