
Meta investiga componentes essenciais de encoders visuais em modelos multimodais
Aprofundamento CEVIU
Aprofundamento
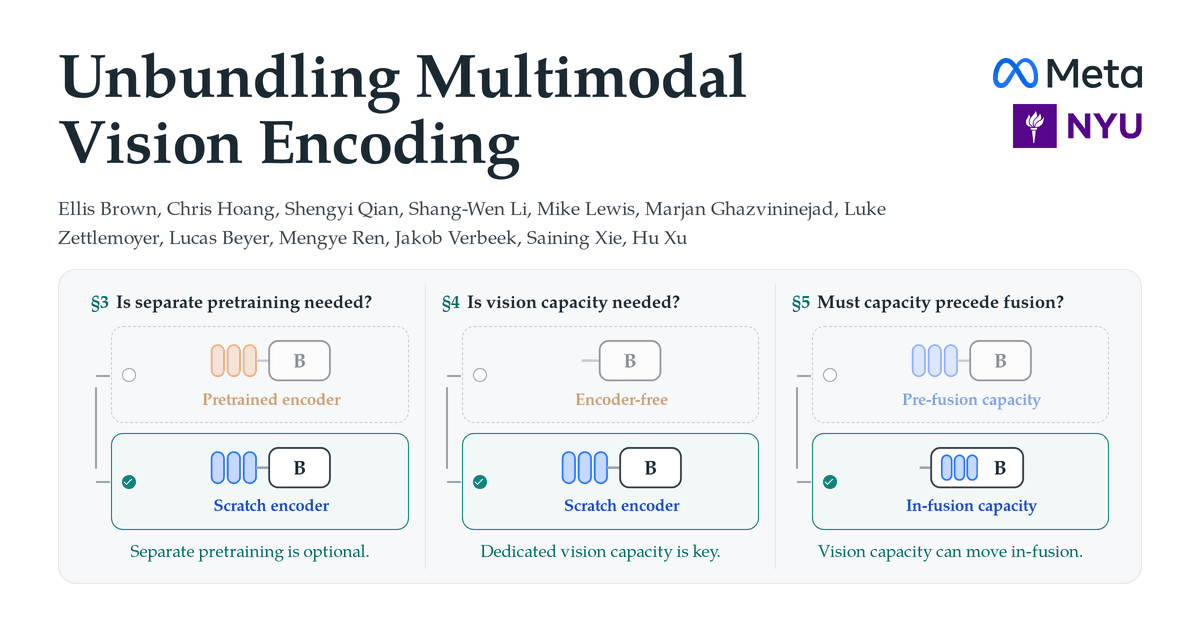
A Meta, por meio de seus pesquisadores, conduziu um estudo detalhado para identificar os elementos cruciais nos encoders visuais de modelos multimodais. A pesquisa focou em desvendar se a pré-treinamento isolado ou a capacidade visual dedicada impactam mais o desempenho. Os resultados mostram que a capacidade de processamento visual dedicada é mais relevante para a eficácia desses modelos do que o pré-treinamento prévio.
O estudo avaliou três aspectos: o pré-treinamento separado, a capacidade visual dedicada e o posicionamento dessa capacidade antes da fusão. Modelos treinados do zero com o modelo de linguagem se igualaram a encoders pré-treinados, mesmo quando o pré-treinamento era mais extensivo. Em contrapartida, modelos sem capacidade visual dedicada tiveram desempenho inferior em compreensão visual, mesmo com um número similar de parâmetros.
O que mudou
Em 7 de agosto de 2026, o CEVIU noticiou
Por que isso importa
Para engenheiros e cientistas de dados trabalhando com modelos multimodais, esta pesquisa da Meta é um guia claro: priorizar a capacidade visual dedicada, mesmo em vez de extenso pré-treinamento. A descoberta de que a capacidade visual pode ser integrada ao backbone do modelo, sem necessidade de um encoder separado, otimiza o design e o tempo de inferência. Isso tem o potencial de reduzir custos computacionais e acelerar a entrega de modelos mais eficientes, especialmente em cenários com restrições de latência.
Linha do tempo
Meta desvenda sinergias multimodais em pré-treinamento de IA
Meta investiga componentes essenciais de encoders visuais em modelos multimodais
Perguntas frequentes
Qual a principal conclusão do estudo da Meta sobre encoders visuais?
A principal conclusão é que a capacidade de processamento visual dedicada é mais crucial para o desempenho de modelos multimodais do que o pré-treinamento isolado do encoder. Modelos treinados do zero podem alcançar resultados similares aos pré-treinados se tiverem capacidade visual adequada.
O que significa 'capacidade visual dedicada' no contexto deste estudo?
Significa a alocação de parâmetros e módulos específicos dentro da arquitetura do modelo para o processamento de informações visuais. O estudo mostra que esses módulos dedicados são essenciais para a compreensão visual, independentemente de estarem em um encoder separado ou integrados ao backbone principal.
O pré-treinamento de encoders visuais é desnecessário?
O estudo sugere que o pré-treinamento de encoders visuais é opcional. Encoders treinados do zero com o modelo de linguagem podem igualar o desempenho de encoders pré-treinados, especialmente em tarefas como VQA (Visual Question Answering), mesmo que o pré-treinamento aumente a acurácia no ImageNet.
Fontes
- unbundling.github.iofonte original
- Categoria
- CEVIU IA
- Publicado
- 16 de novembro de 2026
- Editoria
- CEVIU IA