
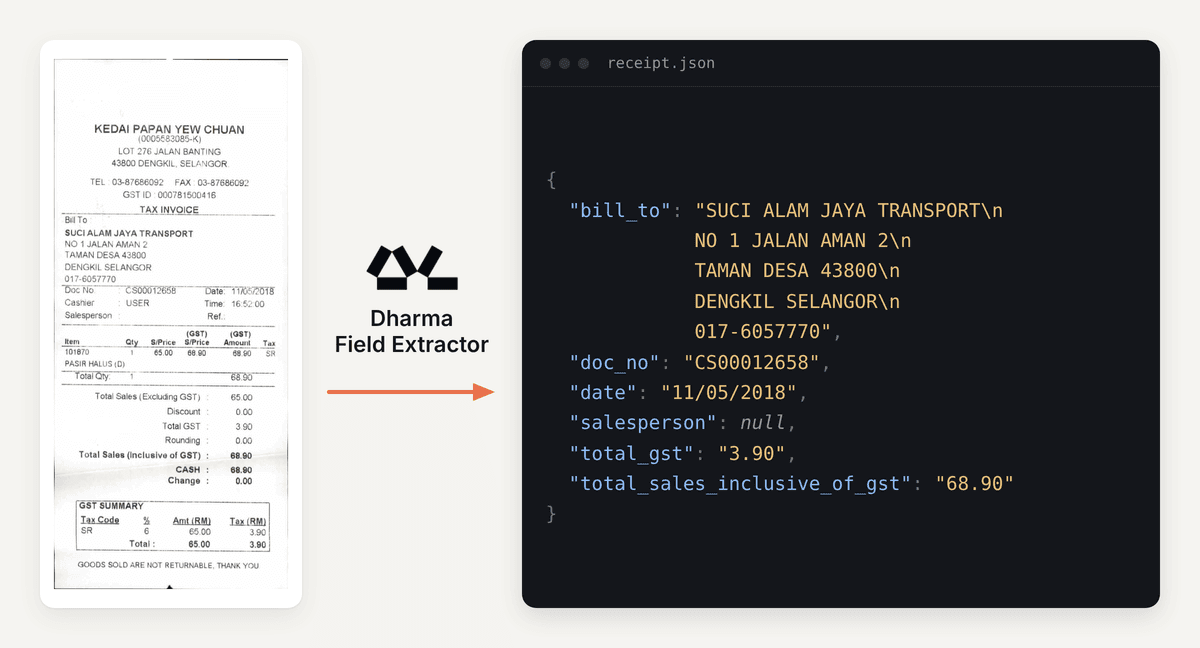
Dharma-AI lança Field Extractor, modelo de 2B que transforma documentos em JSON estruturado
Aprofundamento CEVIU
Aprofundamento
O Dharma Field Extractor ataca um problema bem delimitado: o OCR devolve todo o texto da página, mas não diz qual string é o tipo de exame, a data ou o total. Alguém ainda escreve o código que liga cada valor ao campo certo. O modelo de 2 bilhões de parâmetros pula essa etapa. Recebe a imagem e um pedido (tudo o que achar, ou um schema exato) e devolve JSON tipado, com aninhamento quando o documento tem.
Treino e avaliação. O modelo-base é o DharmaOCR-LITE v1.1, já especializado em OCR com fine-tuning supervisionado e DPO. Sobre ele, a Dharma-AI treinou um adaptador LoRA com 43.384 exemplos, em três fluxos: documentos multidomínio em inglês, documentos brasileiros reais em português e uma parcela menor multilíngue. O benchmark tem 546 documentos em três cenários (sem schema, schema parcial e schema com campos inexistentes), somando 1.638 casos. A métrica é F1 por campo, multiplicada pela similaridade de Levenshtein e pela taxa de JSON válido. O modelo marcou 0,834, contra 0,816 do Claude Opus 5 e 0,741 do GPT-5.6 Luna. A empresa diz que o custo é de cerca de 6 a 147 vezes menor.
Ressalva de custo. A comparação mistura bases diferentes. Os modelos frontier foram medidos por tokens médios por página, com raciocínio em nível baixo, no preço de tabela. O da Dharma-AI é auto-hospedado, contado como tempo de GPU numa L40S a US$ 2,24 por hora. A própria empresa avisa que não é preço de venda e que o custo real depende de hardware, volume e latência. Os números vêm do benchmark da própria Dharma-AI.
O que mudou
A notícia atual é continuação do DharmaOCR-LITE, lançado em abril segundo a própria empresa. Quanto à cobertura do CEVIU, não há matéria anterior sobre a Dharma-AI. Há apenas temas vizinhos, como o Parse da Cohere (28 de agosto de 2026) e o Clairic da Cloudflare (20 de outubro de 2026), que são produtos de outras empresas e não evolução do mesmo projeto.
Por que isso importa
Para quem opera extração de documentos em alto volume, a leitura é que um modelo pequeno e especializado, rodando em uma GPU só, pode ser alternativa a APIs frontier. Isso vale se o seu caso se parecer com o benchmark. Antes de decidir, teste nos seus documentos e refaça a conta de custo com o seu volume e a sua latência.
Linha do tempo
Dharma-AI lança o Field Extractor, modelo de 2B que extrai campos de documentos em JSON estruturado.
Perguntas frequentes
O que o Dharma Field Extractor faz?
Recebe a imagem de um documento e extrai campos em JSON tipado. Funciona em modo aberto, sem schema, ou orientado por schema, com chaves e tipos definidos pelo usuário. Um único checkpoint cobre todos os tipos de documento, sem fine-tuning por tipo.
O que acontece quando o campo pedido não existe no documento?
O modelo retorna null em vez de inventar um valor. Com schema, a saída segue exatamente as chaves pedidas, sem campos extras. O benchmark inclui um cenário com campos deliberadamente inexistentes para testar isso.
O modelo é mesmo mais barato que as APIs frontier?
Segundo a Dharma-AI, custa entre 6 e 147 vezes menos por extração. A conta compara tokens a preço de tabela com tempo de GPU auto-hospedada numa L40S a US$ 2,24 por hora. A empresa admite que o custo real varia conforme hardware, volume e latência.
Em que o modelo foi treinado?
Parte de um DharmaOCR-LITE v1.1 de 2 bilhões de parâmetros, ajustado com um adaptador LoRA em 43.384 exemplos. Os dados misturam documentos multidomínio em inglês, documentos brasileiros em português e uma fatia multilíngue, todos anotados por campo.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 04 de novembro de 2026
- Editoria
- CEVIU IA