
OpenAI apresenta BioBasicsBench para medir como agentes de IA lidam com tarefas rotineiras de laboratório
Aprofundamento CEVIU
Aprofundamento
O BioBasicsBench foi desenvolvido pela OpenAI com a Ligo, empresa de biotecnologia focada em design de enzimas. São 100 tarefas de wet-lab rotineiro, divididas em cinco áreas: métodos de proteína, imagem e citometria, quantificação e ensaios, métodos de ácidos nucleicos e clonagem molecular. As entradas são evidências brutas: imagens de gel e blot, fotos de placas, pilhas de microscopia, leituras de sequenciamento, exportações de plate reader e vídeos de bancada. Folhas de referência, como escadas de peso molecular e mapas de plasmídeo, ajudam na interpretação.
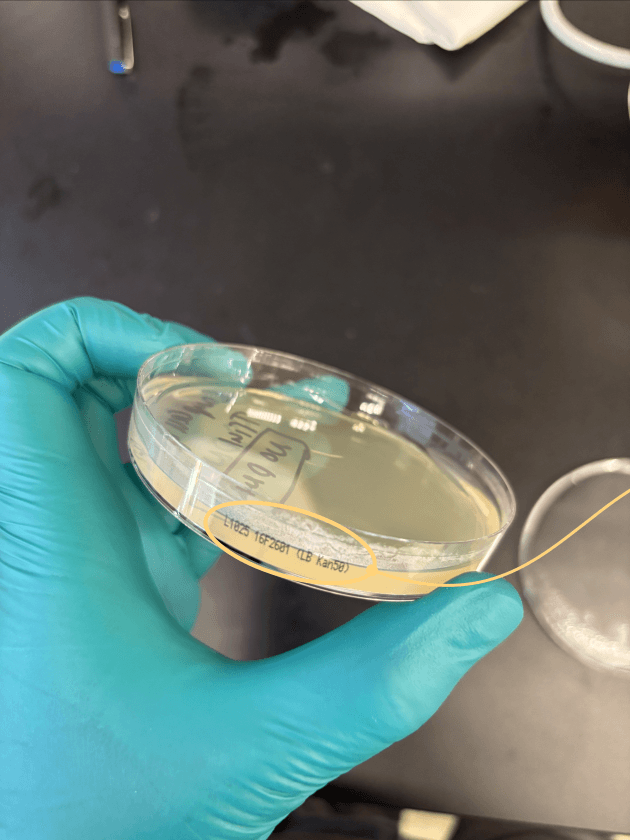
A correção usa rubricas escritas por especialistas, com crédito por critério (conclusão, resultado numérico, raciocínio ou reconhecimento de que a evidência não basta). Cada tarefa passou por revisão interna de um cientista da Ligo, revisão externa de um PhD de wet-lab e revisão final. Foram avaliados sete modelos, em 37 configurações de esforço de raciocínio, com cinco tentativas por tarefa, somando 18.500 resultados. No esforço 'xhigh', o GPT-6 Astra obteve 66,7% do crédito disponível, contra 43,8% do GPT-5.6 Sol. A própria OpenAI mostra falhas do Astra: assumiu que o produto de PCR maior indicava clonagem bem-sucedida e escolheu as colônias erradas, descartou observações que contradiziam sua hipótese sobre vacúolos e superestimou em cerca de 12% a contagem de colônias em uma placa.
O que mudou
Em 6 de novembro de 2026, o CEVIU noticiou "OpenAI apresenta BioBasicsBench para medir como agentes de IA lidam com ciência de wet-lab do dia a dia", com o mesmo benchmark e a mesma premissa. Esta nova matéria acrescenta os números por modelo, o desenho da avaliação e os exemplos de erro. Em 19 de junho de 2026, o CEVIU já havia coberto o LifeSciBench, também de ciências da vida, mas é outro benchmark e outro foco.
Por que isso importa
Para quem avalia agentes em contextos científicos, o dado útil não é só a pontuação. É onde o modelo falha: controles, premissas que atropelam a evidência e contagem visual. Pelo próprio resultado, 66,7% ainda está longe de algo que dispense revisão humana no laboratório. Leitura editorial: o benchmark serve mais como mapa de lacunas multimodais do que como selo de prontidão.
Linha do tempo
CEVIU noticia o LifeSciBench, benchmark de IA em ciências da vida.
CEVIU noticia a apresentação do BioBasicsBench pela OpenAI.
Nova matéria detalha as 100 tarefas, os resultados do GPT-6 Astra e as falhas apontadas.
Perguntas frequentes
O que é o BioBasicsBench?
É um benchmark da OpenAI, criado com a Ligo, que mede como agentes de IA interpretam dados experimentais brutos em tarefas rotineiras de laboratório. Tem 100 tarefas em cinco áreas, como clonagem molecular e imagem e citometria.
Qual foi o desempenho dos modelos?
No esforço 'xhigh', o GPT-6 Astra obteve em média 66,7% do crédito disponível, e o GPT-5.6 Sol, 43,8%. Foram sete modelos testados, com cinco tentativas por tarefa.
Como as respostas são avaliadas?
Cada resposta é pontuada contra uma rubrica escrita por especialistas, com crédito por critério. Isso separa uma conclusão correta de uma análise parcialmente correta.
Em que o GPT-6 Astra ainda falha?
A OpenAI cita três casos: deixar uma premissa passar por cima dos controles, descartar dados que contradizem sua interpretação e errar a contagem de colônias, com superestimativa de cerca de 12% em uma placa.
Fontes
- openai.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 09 de novembro de 2026
- Editoria
- CEVIU IA