
Aprimorando a Avaliação de IA: Estratégias Essenciais para Evitar Erros na Validação de Modelos
Aprofundamento CEVIU
Aprofundamento
A busca por métricas confiáveis na avaliação de desempenho é um desafio constante, seja em infraestrutura, seja em modelos de IA. O problema apontado na notícia atual sobre benchmarks falhos ressoa com a discussão que o CEVIU News vem travando. Muitas vezes, esses 'benchmarks', incluindo o chamado 'napkin math' para estimativas rápidas, simplificam demais a complexidade real. No hardware, por exemplo, números de latência de memória podem ser enganosos por ignorarem paralelismo ou o efeito de cache, como visto no benchmark 'sirupsen/napkin-math'. As medições de SSD também sofrem, com dados imprecisos e problemas de leitura que não simulam cenários reais.
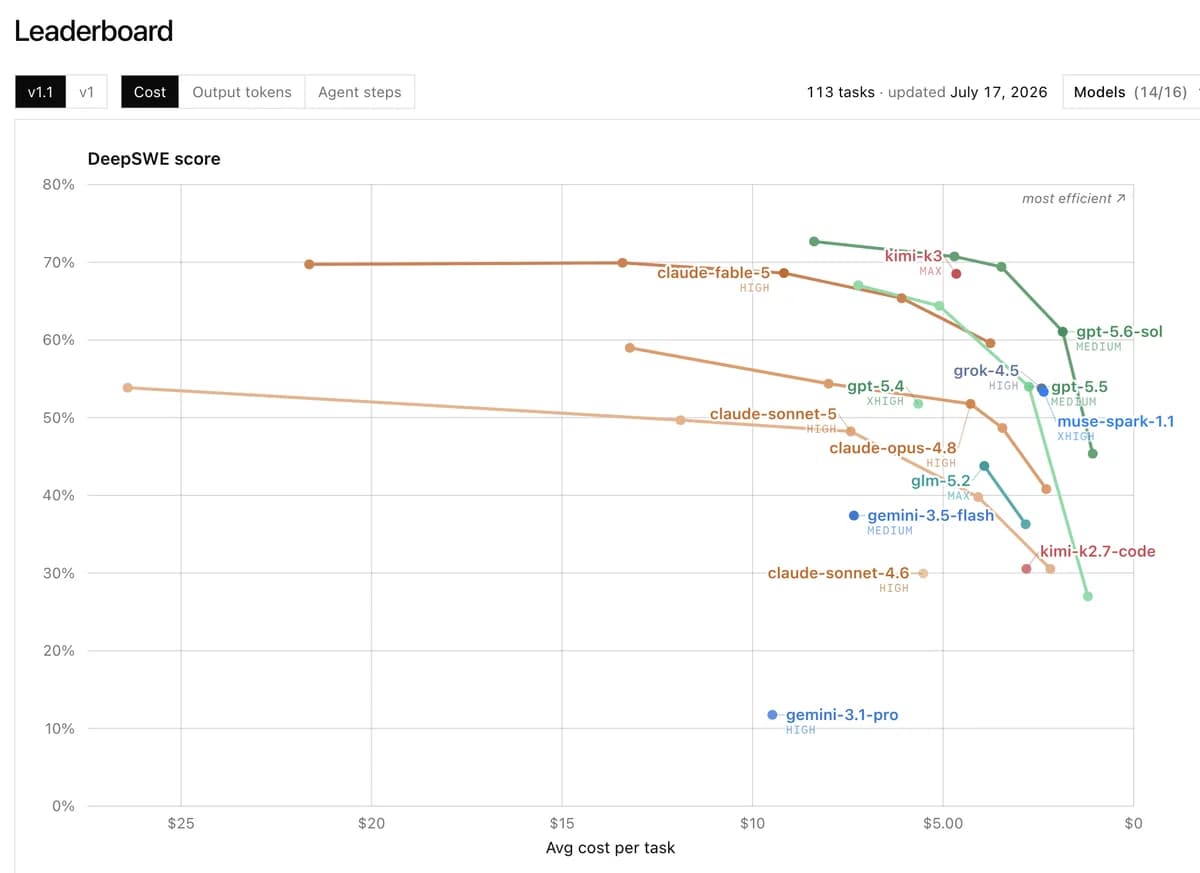
Para modelos de IA, a situação não é diferente. Benchmarks como DeepSWE e Senior SWE-Bench são frequentemente usados para 'provar' superioridade, mas, sem um olhar crítico sobre sua metodologia, esses testes podem levar a conclusões erradas. Nossa cobertura anterior, como em 'Desvendando o Verdadeiro Potencial da IA: A Armadilha da Percepção' (14 de julho de 2026), já alertava que a avaliação da IA exige testes rigorosos em áreas onde o avaliador realmente tem conhecimento. A complexidade dos sistemas atuais vai muito além de uma única saída ou de um prompt isolado, como abordamos em 'Avaliando a IA: Por Que uma Única Saída Não Banaliza o Desempenho em UX' (24 de agosto de 2026) e 'Avaliação de Prompts: Um Olhar Crítico sobre a Eficácia na IA' (10 de setembro de 2026).
Por que isso importa
Entender as fragilidades dos benchmarks é crucial para qualquer profissional de tecnologia. Avaliações imprecisas levam a decisões de arquitetura equivocadas, investimentos mal direcionados e, no caso da IA, à implantação de modelos com desempenho inferior ou inesperado em produção. O artigo 'Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção' (26 de agosto de 2026) já destacava a necessidade de uma metodologia de avaliação robusta que vá além dos benchmarks iniciais, considerando a complexidade dos dados reais. Uma compreensão aprofundada dos mecanismos subjacentes, e não apenas a memorização de um número isolado, é o que garante a validade das avaliações e a eficácia das soluções.
Linha do tempo
Desvendando o Verdadeiro Potencial da IA: A Armadilha da Percepção
Avaliação do Impacto Cumulativo de Experimentos em DevOps
Avaliando a IA: Por Que uma Única Saída Não Banaliza o Desempenho em UX
Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção
Avaliação de Prompts: Um Olhar Crítico sobre a Eficácia na IA
Ciclo Contínuo Otimiza Agentes de IA com Observabilidade e Experimentação
Aprimorando a Avaliação de IA: Estratégias Essenciais para Evitar Erros na Validação de Modelos
Perguntas frequentes
O que é 'napkin math' e quais são seus riscos na avaliação de desempenho?
'Napkin math' refere-se a estimativas rápidas de desempenho, muitas vezes com base em números simplificados. O risco está em que esses números, como os de latência de memória ou SSD, podem ser imprecisos ou não considerar fatores complexos como paralelismo, caching e condições reais de operação, levando a conclusões errôneas.
Por que os benchmarks de modelos de IA podem ser enganosos?
Benchmarks de IA, como DeepSWE e Senior SWE-Bench, podem ser enganosos se não forem avaliados criticamente. Eles frequentemente simplificam demais o comportamento complexo da IA em cenários reais, ignoram a interação de múltiplos fatores e podem não ser representativos das aplicações em produção, como o CEVIU já discutiu em diversas matérias.
Como o contexto da avaliação afeta a percepção do desempenho da IA?
O contexto é fundamental. A IA pode parecer 'inteligente' em um ambiente controlado de benchmark, mas falhar em cenários do mundo real. Avaliações eficazes exigem conhecimento aprofundado do domínio e testes que simulem as condições operacionais e as complexidades dos dados, como vimos em 'Desvendando o Verdadeiro Potencial da IA: A Armadilha da Percepção' (14 de julho de 2026).
Qual a relação entre falhas em benchmarks e a implantação de LLMs em produção?
Falhas em benchmarks têm impacto direto na implantação de Large Language Models (LLMs). Se a avaliação inicial for baseada em benchmarks simplistas, os LLMs podem não performar conforme o esperado em ambientes de produção, onde enfrentam dados ambíguos e complexos. Uma avaliação robusta e contínua é essencial, como explorado em 'Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção' (26 de agosto de 2026).
Fontes
- danluu.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 15 de setembro de 2026
- Editoria
- CEVIU IA