
A Crescente Lacuna entre o Potencial da IA e Sua Aplicação por Usuários Comuns
Aprofundamento CEVIU
Aprofundamento
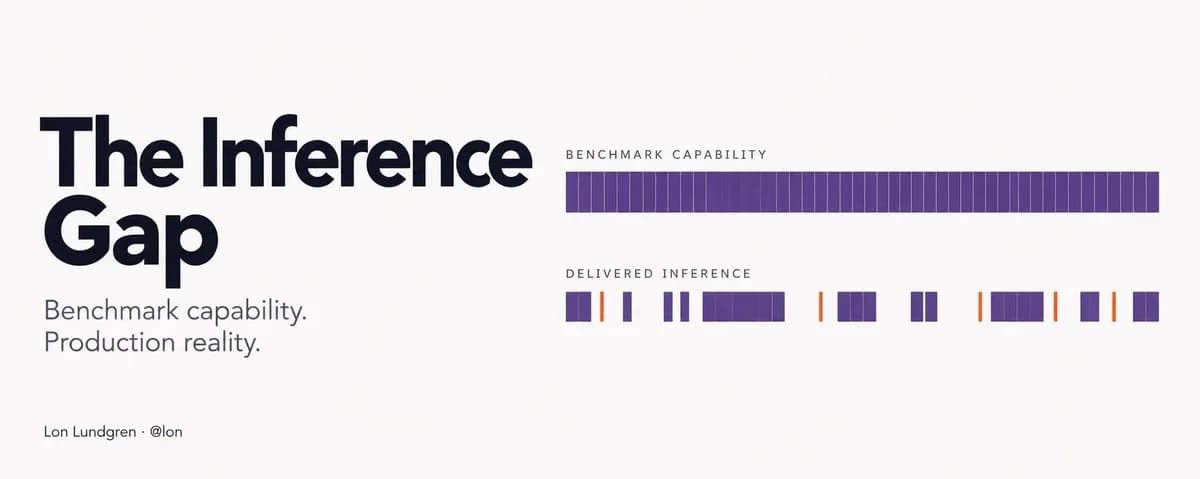
A notícia destaca um desafio técnico crucial na Inteligência Artificial: a diferença entre o que os modelos de IA podem fazer e o que o usuário comum consegue extrair deles. Essa é a chamada "lacuna de inferência". Basicamente, você tem acesso a um modelo poderoso, mas não necessariamente à sua capacidade total de raciocínio. Um estudo forense do modelo Fable 5 da Anthropic, por exemplo, revelou que, mesmo com configurações de "esforço máximo", a quantidade de "tokens de pensamento" ininterrupto que o modelo performava era bem menor que o esperado.
Metade das invocações do Fable 5 entregou no máximo 123 tokens de pensamento sequencial ininterrupto. Em quase 40% das vezes, o modelo não pensou nada. Para contexto, tokens de pensamento são as sequências de raciocínio que o modelo executa para chegar a uma resposta. Esse nível de fragmentação cresce conforme a tarefa se alonga, o que impacta diretamente a capacidade do modelo de realizar tarefas complexas que exigem um raciocínio profundo e contínuo. É como se a IA recebesse um grande problema, mas tentasse resolver em pequenos pedaços desconectados, sem a deliberação contínua necessária. Essa observação aprofunda o que já discutíamos em "Paradoxo da IA: Modelos Avançados, Ferramentas Menos Confiáveis" (11 de julho de 2026), onde apontávamos a queda de fidelidade na emissão de esquemas por IA.
O que mudou
Antes, usuários percebiam uma queda de performance e rumores de que modelos estariam sendo "nerfados", ou seja, com capacidades reduzidas secretamente. Agora, temos uma explicação técnica mais aprofundada. O problema não está necessariamente no modelo em si, mas no regime de inferência, a forma como o acesso e o uso dos recursos computacionais do modelo são gerenciados e entregues. A análise do Fable 5 revelou que a identidade do modelo permaneceu a mesma, mas o regime de inferência entregue ao usuário final não. Isso explicita o porquê de os usuários terem que "gastar um esforço dramaticamente maior" para obter o mesmo resultado, o que era antes uma percepção anedótica agora é um fato quantificado com base em dados de uso real.
Por que isso importa
Essa lacuna de inferência tem implicações diretas na adoção e custo da IA. O que se vê em benchmarks de fronteira, que mostram capacidades "dazzling", pode não ser o que o usuário comum experimenta. Conforme discutimos em "A ascensão do custo da computação e o dilema da IA" (30 de julho de 2026), a inferência já é um gargalo de custo. Se para acessar a capacidade real do modelo for preciso um regime de inferência mais robusto e, por consequência, mais caro, o custo para reproduzir capacidades de ponta pode se tornar proibitivo, um "dilema" ainda maior. Além disso, a fragmentação do pensamento da IA pode tornar a "Engenharia de Contexto: O Calcanhar de Aquiles na Adoção da IA Corporativa" (27 de julho de 2026) ainda mais complexa e cara, exigindo mais esforço humano para compensar o raciocínio inconsistente da máquina. Entender esse mecanismo é crucial para não "construir para os usuários errados", como alertamos em 27 de março de 2026.
Linha do tempo
CEVIU News: As Empresas de IA Estão Construindo para os Usuários Errados
CEVIU News: A Sociedade da Curva Plana: quando a IA avança, mas a percepção fica para trás
Anthropic restaura acesso ao modelo Fable 5
CEVIU News: Paradoxo da IA: Modelos Avançados, Ferramentas Menos Confiáveis
Anthropic anuncia que Fable 5 ficará permanentemente acessível a assinantes
CEVIU News: Engenharia de Contexto: O Calcanhar de Aquiles na Adoção da IA Corporativa
CEVIU News: A ascensão do custo da computação e o dilema da IA
Início da investigação de especialista sobre a performance do Fable 5
Criação do proxy semântico para coletar dados do Fable 5
CEVIU News: O Dilema da IA: Produção Acelerada vs. Avaliação Humana
Notícia sobre a crescente lacuna entre o potencial da IA e sua aplicação por usuários comuns
Perguntas frequentes
O que é a "lacuna de inferência" na IA?
É a diferença entre o potencial teórico e as capacidades demonstradas de um modelo de IA e o que os usuários conseguem extrair dele na prática. Basicamente, os modelos são mais poderosos do que o regime de inferência que geralmente é entregue, limitando o acesso ao seu potencial máximo.
O que são "tokens de pensamento"?
Tokens de pensamento são uma métrica que representa a quantidade de passos de raciocínio ininterrupto que um modelo de IA executa durante uma invocação. Quanto mais tokens de pensamento sequenciais e ininterruptos, mais profunda e complexa é a deliberação do modelo para resolver um problema.
Por que a Anthropic entregaria um regime de inferência mais fragmentado no Fable 5?
O estudo sugere que isso pode ser uma forma de gerenciar os recursos computacionais e os custos de operação. Um regime de inferência com pensamento fragmentado pode consumir menos recursos do que um raciocínio contínuo e profundo, mas resulta em menor performance percebida pelo usuário final.
Como essa "lacuna de inferência" afeta o usuário final?
Para o usuário, isso se traduz em performance inconsistente e na necessidade de gastar muito mais esforço para obter os mesmos resultados que um modelo teoricamente capaz deveria entregar com menos intervenção. Isso pode gerar frustração e dificultar a adoção prática de soluções baseadas em IA.
Fontes
- x.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 21 de setembro de 2026
- Editoria
- CEVIU IA